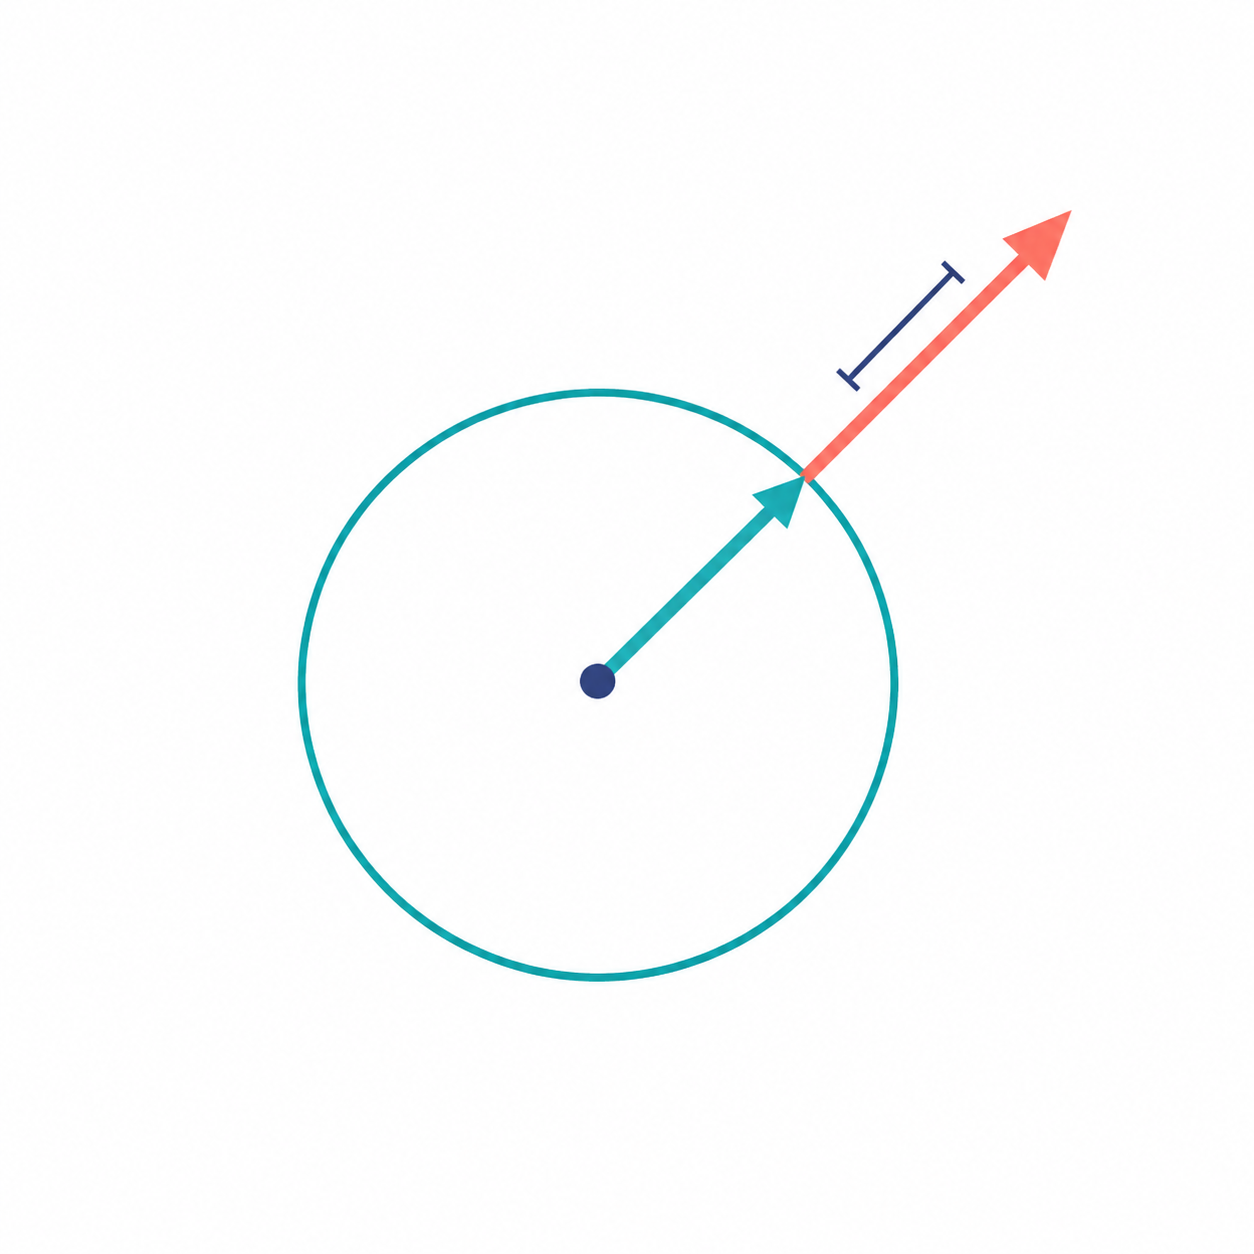
让 AI 裁一次全局梯度:两组各自合格,合起来仍可能超限 “把梯度限制到5”至少可能指单个数值、每组参数的长度,或全部梯度合在一起的长度。让AI解释裁剪前,先要求它把这三种对象分开。本例只研究全局L2范数,让裁剪后的总长度成为可以复算的验收项。 yunqueblog/ AI分享/ 2026-10-02/ 2 阅读
用 AI 记两步 Adam:这一步梯度为零,参数为何还在移动 如果让AI直接解释优化器,答案很容易停在“结合动量和自适应学习率”。可以给它一个只有一个参数的账本,要求把每次更新前后的状态列全。第二步故意提供零梯度,马上就能看出它是否保留了历史。 yunqueblog/ AI分享/ 2026-10-02/ 2 阅读
让 AI 配标签平滑比例:真实类别保留八成,不是七成 标签平滑常被概括成“从正确类别拿走一点概率”。这句话容易漏掉一个细节:如果采用和均匀分布混合的定义,正确类别自己也会收到均匀份额。让AI列出完整目标向量,比只问“平滑参数是多少”更可靠。 yunqueblog/ AI分享/ 2026-10-02/ 2 阅读
用 AI 转一对 RoPE 向量:位置一起后移,点积为何仍然相同 旋转位置编码听起来像把词放到一只表盘上。要把这个类比变成能核验的练习,可以请AI只处理一对二维向量:写出旋转后的坐标,再计算点积。这样能看见“位置进入计算”究竟发生在哪里。 yunqueblog/ AI分享/ 2026-10-02/ 2 阅读
让 AI 记一笔 BatchNorm:这批方差是五,存下来的为何不是五 学习BatchNorm时,可以让AI做一张“本次计算”和“留给以后”的双栏账。两栏都写方差,却不一定使用同一个数;如果只抄一条标准化公式,切换评估模式后的结果就很难解释。 yunqueblog/ AI分享/ 2026-10-02/ 2 阅读
用 AI 逐行算 LayerNorm:另一条样本变大,当前这一行为何没变 看到神经网络里的“归一化”,容易把整张表的数一起求平均。让AI解释LayerNorm时,先给它一张只有两行的小表,并要求标出每个均值来自哪些格子。能否圈对统计范围,比背出公式更能检验理解。 yunqueblog/ AI分享/ 2026-10-02/ 2 阅读
用 AI 算 KV 缓存:查询头有十六个,缓存也可能只按四组保存 本地模型的权重已经装得下,为什么对话变长后显存还会涨?原因之一是生成过程保存了过去位置的键和值。可以让AI按张量形状做一份容量预算,但先要确认该数查询头,还是实际存储的KV头。 yunqueblog/ AI分享/ 2026-10-02/ 2 阅读
让 AI 枚举 Dropout:训练时保留的值放大,推断时就不再补一次 同一个网络,训练和推断时Dropout的输出为什么不同?只说“训练随机删一半”容易产生两个误解:每次一定恰好删一半,以及推断时还要再把数乘回去。可以让AI枚举两个输入数的全部情况,把这两件事一次算清。 yunqueblog/ AI分享/ 2026-10-02/ 2 阅读
用 AI 摆两步束搜索:第一步最可能的词,未必带来最可能的整句 生成文字时,每一步都选概率最高的候选,会不会自动得到概率最高的整段?让AI把输出缩成两个符号,画出每个前缀的后续概率,就能亲手比较贪心解码与束搜索的区别。这不是让模型写漂亮句子,而是检查搜索到底留下了什么。 yunqueblog/ AI分享/ 2026-10-02/ 2 阅读
让 AI 检查训练集分组:照片文件不同,背后也可能是同一件物品 准备图片分类练习时,把文件名随机分到训练集和验证集,看起来已经没有重复文件。然而同一件物品的连拍、裁剪和调色版本,仍可能分到两边。若目标是判断新物品,验证对象实际上并没有真正换新。 yunqueblog/ AI分享/ 2026-10-02/ 2 阅读


 yunqueblog