

让 AI 配标签平滑比例:真实类别保留八成,不是七成
标签平滑常被概括成“从正确类别拿走一点概率”。这句话容易漏掉一个细节:如果采用和均匀分布混合的定义,正确类别自己也会收到均匀份额。让AI列出完整目标向量,比只问“平滑参数是多少”更可靠。
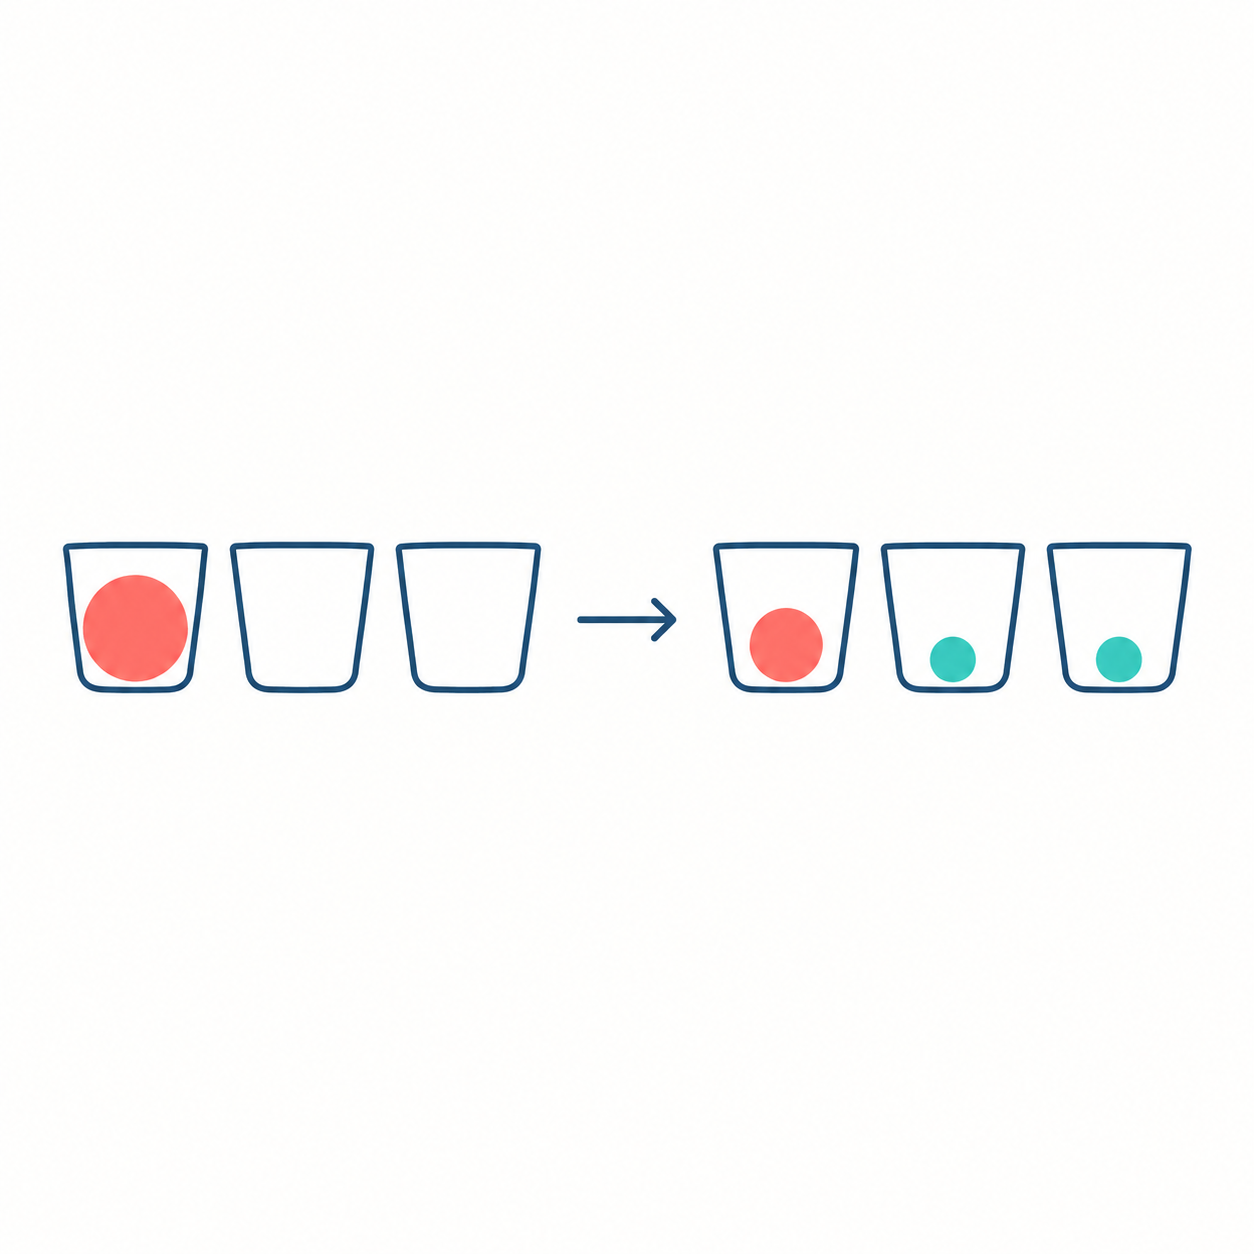
AI模型生成的概念插图:目标质量从单一类别分布到三个容器,圆形大小不作精确比例;不代表软件截图、真实实验或精确数据图。
先把两份分布按比例混合
虚构分类器有A、B、C三个互斥类别,当前样本标签是A。原始目标为[1,0,0],设平滑量s=0.3,均匀分布为[1/3,1/3,1/3]。按PyTorch文档所述的混合口径,目标q=(1-s)×原目标+s×均匀分布。
A收到0.7+0.1=0.8,B与C各收到0.1,最终是[0.8,0.1,0.1],总和为1。写成[0.7,0.15,0.15]虽然也能加到1,却采用了“只向其他类别分配”的不同规则,不能当作这一实现的同义写法。
同一预测,损失的衡量目标已经变了
给第一组预测p=[0.8,0.15,0.05],全部为正且总和为1。用自然对数,原硬标签损失为-ln(0.8),约0.223143551;平滑目标损失为-0.8ln(0.8)-0.1ln(0.15)-0.1ln(0.05),约0.667800067。
第二组预测p=[0.98,0.01,0.01]更偏向A。硬标签损失约0.020202707,确实更小;但平滑目标损失约0.937196203,反而比第一组大。因为B和C的目标质量都不是0,过小的预测概率也会产生交叉熵贡献。
两组都把A排在第一名,单样本分类准确与损失大小因此不能混作一件事。尤其不能拿硬标签训练时的0.223与平滑后的0.668直接宣布模型“退步了”,因为目标分布已经换过。
要求AI保留三项贡献
可用提示词:“三分类真实类别A,label_smoothing=0.3,采用原始one-hot与全类别均匀分布混合。先算完整q,再对[0.8,0.15,0.05]和[0.98,0.01,0.01]分别列每一项-qᵢln pᵢ及总损失,同时列硬标签损失。检查总概率,并解释[0.7,0.15,0.15]为何属于另一口径。”
练习可以再检查s=0时回到[1,0,0],s=1时变成全均匀目标。它们帮助发现实现是否把平滑量加到了错误位置,但不是推荐实际训练使用某个极端值。
手算入口是概率,PyTorch CrossEntropyLoss的输入则应是未归一化logits;若用代码复现,可选log(p)作为logits,因为这两组p的和均为1。不要先把p本身当logits又做一次softmax。本例没有类别权重、忽略标签或批量归约;加入这些设置后,需要重新核对损失定义。
资料核对日期:2026年10月2日。数值为原创教学设定,已用独立Python计算复核,不代表真实模型性能测试。



