

用 AI 查乘积量化距离表:两个向量代码相同,真实距离为何差很远
向量检索中的乘积量化,常被简称为“把浮点向量压成短码”。要知道短码为什么能用来估距离,可以让AI把四维向量切成两段,各自查一个小码本,再亲手把两张距离表的结果加起来。
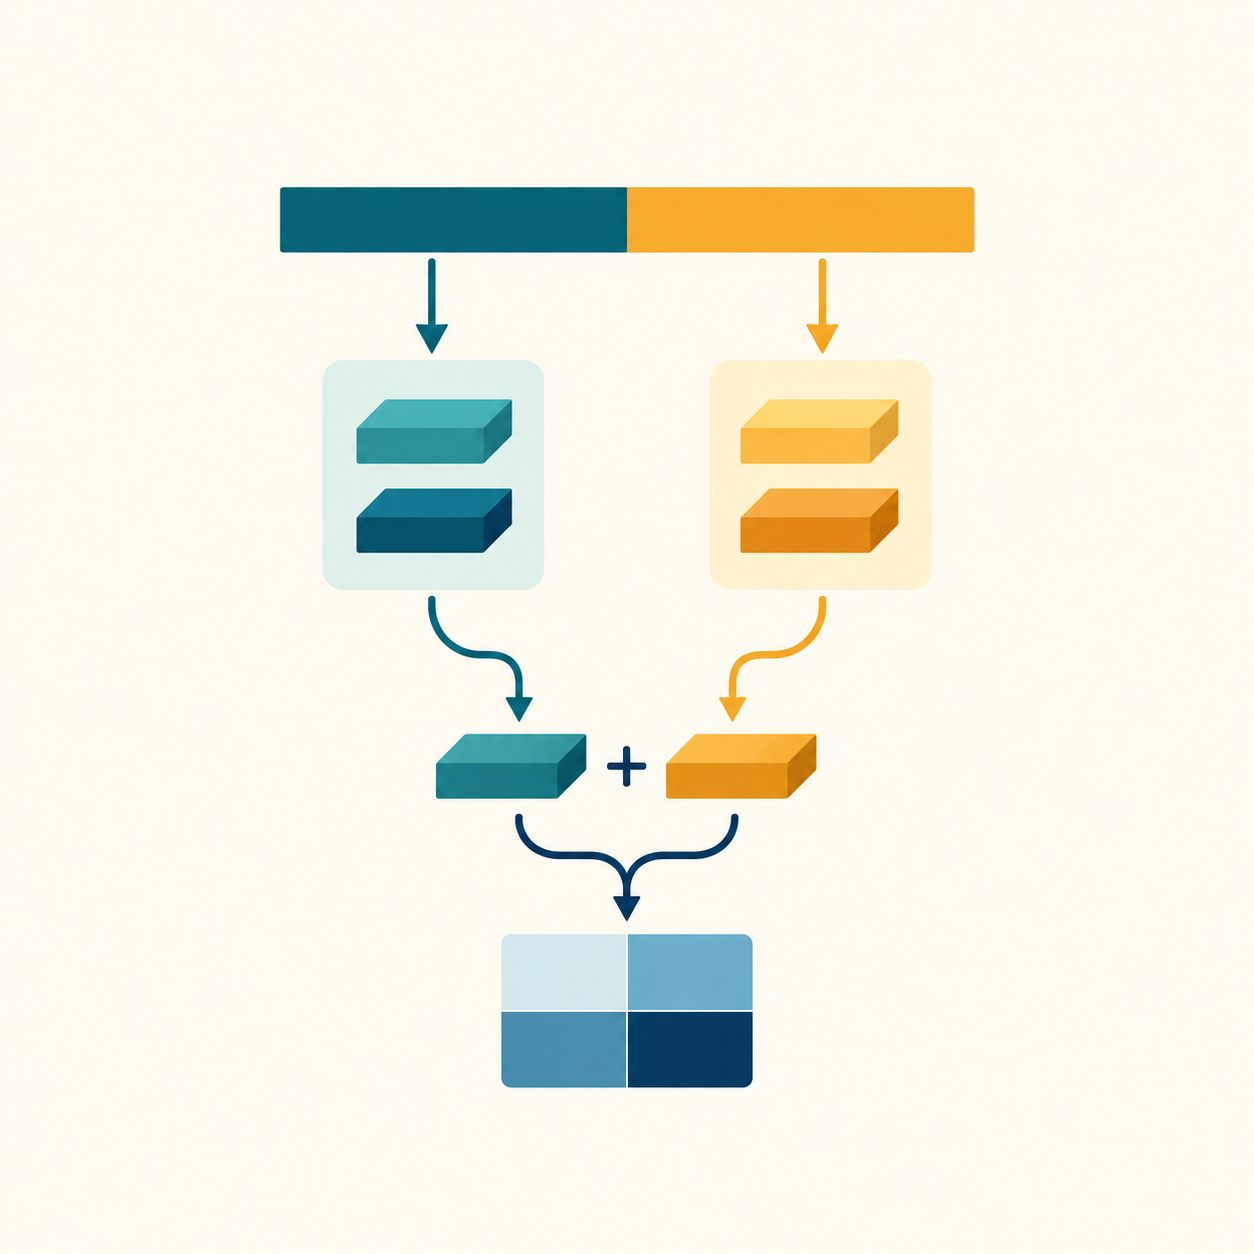
AI模型生成的概念插图:向量拆成两个子段,各自选择码字后汇总查表结果;不是真实索引结构、精确数值图或运行截图。
每一段都有自己的码本
前两维的码本A有A₀=(0,0)、A₁=(2,2);后两维的码本B有B₀=(0,0)、B₁=(4,0)。码字编号从0开始,编码时各子段选择平方欧氏距离最小的码字。码本是人为给定的,没有执行聚类训练。
原向量x=(1.8,2.2,3.7,0.2)。第一段到A₀、A₁的平方距离分别为8.08、0.08,选择A₁;第二段到B₀、B₁分别为13.73、0.13,选择B₁。因此代码是(1,1),解码后的近似向量为(2,2,4,0),总重建平方误差0.08+0.13=0.21。
这里的“乘积”指各子码本组合形成完整向量码本。两段各两种选项,共有2×2=4种组合;不是把两个坐标值相乘。每段编号理论上只需1位,但实际文件还有字节打包、共享码本等成本,不能拿这两个位直接宣称整个小索引只占两位。
查询保留原值,数据库只拿代码
给查询q=(1,1,3,0)。前段q₁=(1,1)到A₀、A₁的平方距离都是2,形成查表[2,2];后段q₂=(3,0)到B₀、B₁的平方距离为9、1,形成查表[9,1]。Faiss的ProductQuantizer接口也按子向量到各码字的平方距离组织这样的表。
查数据库x的代码(1,1),从第一张表取第1号值2,从第二张取第1号值1,相加得到近似平方距离3。这个数精确等于q到解码向量(2,2,4,0)的平方距离;而q到原x的真实平方距离是0.64+1.44+0.49+0.04=2.61。近似来源是数据库向量被码字替代。
同一个短码会抹平哪些差异
再加入y=(1.5,1.5,3,0.1)。它同样选择A₁和B₁,代码仍为(1,1),查表距离也为3。但q到y的真实平方距离只有0.25+0.25+0+0.01=0.51。y实际上明显更近,短码却让两者并列。
让AI核对时要保留三套量:原向量到码字的编码距离、查询到各码字的表、查询到原向量的精确距离。混在一起会把重建误差0.21错当检索距离,或把查表结果3误称为原向量的精确结果。还要统一使用距离平方,不能某张表开了平方根、另一张没有。
这种查询不量化、数据库量化的比较通常称为非对称距离计算。更多码字、更合理的子空间划分或候选精确重排可能减少误差,但都要付出相应成本;本文没有比较召回率与速度。代码相同这一反例说明,查表算得再准确,也不能恢复压缩时已经失去的区别。
资料核对日期:2026年10月2日。算例为原创教学设定,已用独立Python计算复核,不代表真实模型训练或性能测试。



