

让 AI 算 RANSAC 重试次数:六成点可靠,为何两点全可靠的机会不是三成六
在图像匹配或带离群点的回归中,RANSAC反复抽小子集拟合候选,再统计支持该候选的点。设置重试上限前,必须先写清一次怎样抽。小数据中,“内点比例的平方”可能高估两点都可靠的机会。
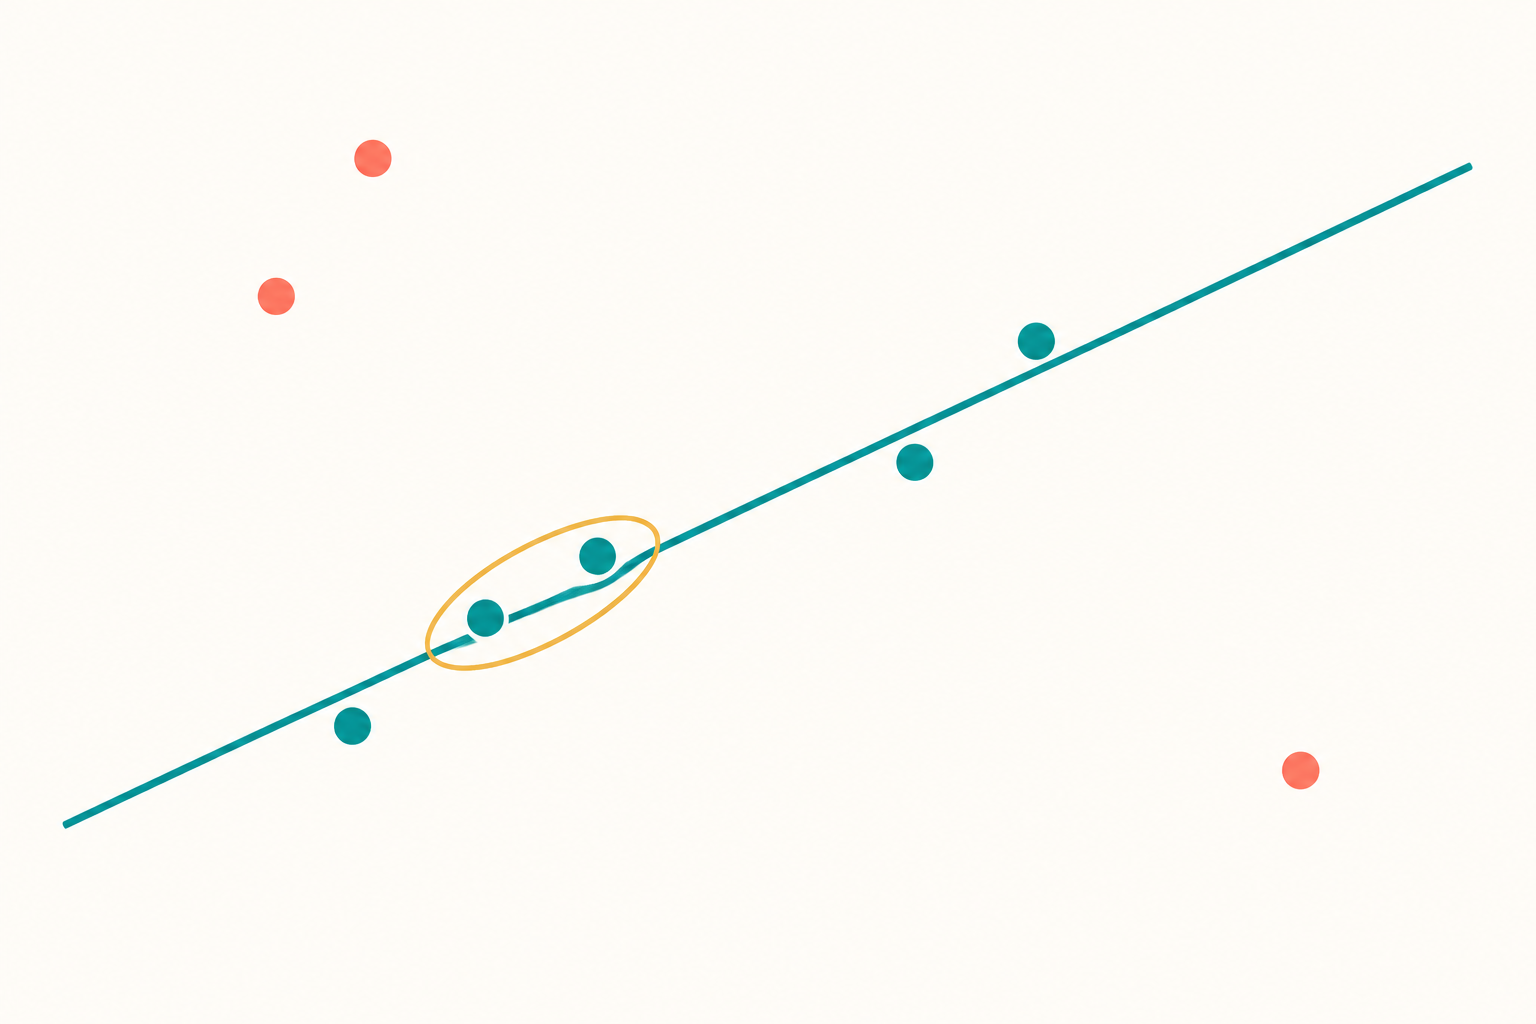
AI生成的概念示意图:少量候选点可提出一条模型,其他点负责检验支持范围;不是实测匹配结果或精确比例图。
五个点,十种两点组合
教学数据为A=(0,0)、B=(1,1)、C=(2,2)、D=(3,8)、E=(4,-3)。其中A、B、C来自目标直线y=x,另外两点视为离群点。每次从五点中等概率选两个不同点;一次结束后恢复完整候选池,下一次独立重抽。
五点共有C(5,2)=10种无序点对,全内点组合只有AB、AC、BC三种,因此单次成功概率q=3/10。也可按先后抽法计算:(3/5)×(2/4)=0.3。第二次抽样时总数和剩余内点数都变了。
把内点比例0.6直接平方得到0.36,等价于把两次是否为内点当成独立事件;这适合有放回抽样或在大总体下作为近似。本文一次内部明确无放回,所以不能照搬。一般精确式为C(I,s)/C(N,s),I是内点数、N是总点数、s是子集大小。
至少成功一次,要从全部失败倒算
在各轮独立重抽的约定下,连续k轮都没有全内点组合的概率为0.7的k次方。至少一次成功的概率就是1-0.7ᵏ。要达到99%,需k不小于ln(0.01)/ln(0.7),向上取整得到13轮。
12轮的成功概率约98.6159%,13轮约99.0311%,跨过要求。如果误用0.36,会算出11轮就够;但真实无放回单轮机制下,11轮只有约98.0227%,并没有达到99%。向上取整之前用错单轮概率,后面的精确小数救不了这个预算。
抽到干净子集,不等于最终模型必然正确
任取AB、AC或BC都会恢复本例的y=x。若把纵向残差阈值固定为0.1,三内点残差都是0,D与E分别为5和7。但真实数据的内点也可能含噪声,最小子集可能退化,阈值可能选错,其他错误模型也可能获得较大支持集。
因此99%只对应本文定义的“至少抽到一次全内点组合”,不能改写成99%的识别准确率。库里的停止规则还会使用当前估计的内点比例,并受到最大轮数、有效性检查和其他停止条件影响;应查看具体实现与运行记录。
让AI输出事件定义和边界检查
提示词可以写:“列出全部十种点对并标记全内点组合;分别计算12、13轮的成功率;说明轮内与轮间是否放回;把抽样成功与最终拟合正确分开。”本次独立枚举点对核对3/10,并用高精度数值复算重试界限。
如果I小于s,成功概率为零,再多轮也不能解决;若I=N且子集均有效,一轮就够。预算还要覆盖每轮拟合和全体残差检查成本。先用小例核对抽样语义,再把真实数据估计带进去,比只填写一个很大的max_trials更容易解释。
把抽样预算和支持集验收接起来
在实际匹配任务中,应让AI为每轮保留抽中的点ID、候选模型、有效性检查、全部残差和支持集大小。遇到重复坐标或几何退化时,某些全内点组合也可能无法估计模型;此时本文把全内点组合视为成功的事件就需要进一步收紧,不能继续原样使用三除以十。
若改成跨轮也不重复选择点对,连续失败事件就不再按零点七的幂计算。本例最多十轮可遍历全部点对,但这是一种不同的抽样设计。改变实现以后,先重新定义样本空间,再核算置信度;不能一边声称轮次独立,一边从待选清单中永久删除已经用过的组合。
资料核对日期:2026年10月2日。数据为原创教学设定,已用独立本地程序复核,未进行真实模型训练或生产效果测试。



