

Python bytes.hex 的分组方向:每两字节一组,为什么短组有时在开头有时在末尾
检查一段五字节数据,希望每两字节放一组。hex输出却把第一字节单独留在开头,而预期是最后一字节落单。bytes_per_sep除了指定组宽,还用正负号指定从哪端计算分隔位置;这种显示差异不表示报文内容或字节序发生了变化。
本例在Linux、CPython 3.12.14实跑。保存为demo.py,执行python3 demo.py。人工构造五字节packet,同时展示左起分组、右起分组和显式字段边界,全部操作都在内存;分隔符参数从Python 3.8开始支持。
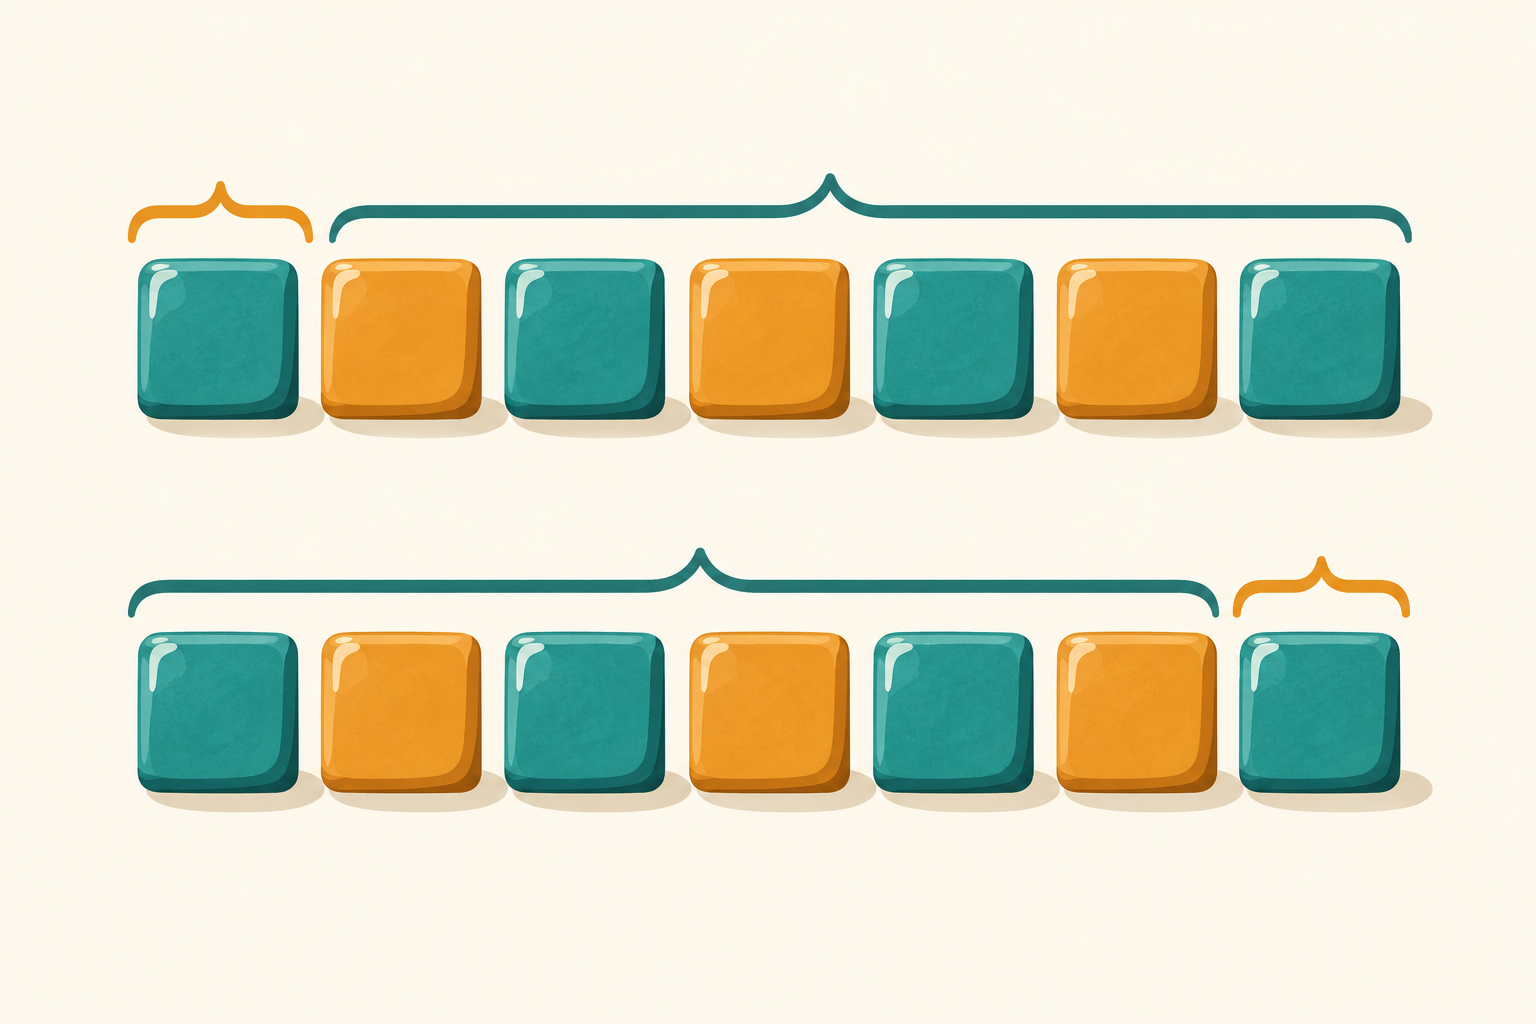
AI生成的概念示意图:两行方块顺序相同,短组分别留在左右两端;这是显示分组的比喻,不是报文格式规范。
完整程序与本地结果
完整可运行程序
packet = bytes([0x10, 0x20, 0x30, 0x40, 0x50])
right = packet.hex(" ", 2)
left = packet.hex(" ", -2)
assert right == "10 2030 4050"
assert left == "1020 3040 50"
print("groups from right:", right)
print("groups from left:", left)
assert bytes.fromhex(right) == bytes.fromhex(left) == packet
print("both restore original: True")

header, tail = packet[:1], packet[1:]
display = header.hex() + " | " + tail.hex(" ", -2)
assert display == "10 | 2030 4050"
print("explicit header boundary:", display)
custom = packet.hex(":", -2)
assert custom == "1020:3040:50"
print("custom separator:", custom)
try:
    bytes.fromhex(custom)
except ValueError:
    print("colon input: ValueError")
else:
    raise AssertionError("colon was accepted as whitespace")
assert bytes.fromhex(custom.replace(":", "")) == packet
print("known separator removed: True")
assert b"".hex(" ", 2) == ""
assert b"\x10".hex(" ", -2) == "10"
assert packet == bytes([0x10, 0x20, 0x30, 0x40, 0x50])
print("empty, short, unchanged checks: passed")
本次实际输出(以下为结果,不是程序)
groups from right: 10 2030 4050
groups from left: 1020 3040 50
both restore original: True
explicit header boundary: 10 | 2030 4050
custom separator: 1020:3040:50
colon input: ValueError
known separator removed: True
empty, short, unchanged checks: passed
正值从右计算,负值从左计算
packet依次包含十六进制10、20、30、40、50。传入组宽二,输出是10 2030 4050,末尾两组各占两字节,剩余一字节留在前面。组宽改为负二后,输出变成1020 3040 50,不满一组的部分移到右端。
分组单位是字节,不是十六进制字符。每个字节占两位文字,因此两字节一组通常显示四个十六进制字符。若把参数二误读成两个字符,就会在字段检查中错认一半宽度;先明确日志中的组宽定义,才能与协议表里的字节偏移对应。
从哪端对齐,取决于你正在核对什么
若一段数据以连续双字节字段开头,末尾可能留下零散字节,左起分组更容易沿着开头检查。若已知末尾是一串完整双字节字段,前面还有单独的短头,右起分组则可能更贴合尾部。两种写法都只是显示选择,不会自动理解字段语义。
示例进一步明确切出一字节header和后续tail,输出10 | 2030 4050。中间竖线由应用主动添加,表示已经按约定识别出的头部边界。这样比依靠总长度刚好形成短组更可靠:数据一旦增加可选字段,偶然对齐就可能不再成立。
空白分组可以还原同一串字节
right与left虽然文字不同,分别交给bytes.fromhex都恢复原始packet。断言同时验证两条还原路径与原数据相等,这比只看字符串长度更直接。十六进制显示可用来读日志,但做内容比较时最好还原为字节,避免把排版差异误认为数据变化。
fromhex在这里忽略ASCII空白。它仍要求有效的十六进制成对数字,不是通用的“从任意说明文字提取字节”工具。含有地址列、字段名、竖线或注释的完整日志,需要先按照明确格式解析,不能整行塞进函数并期待自动剔除杂项。
自定义冒号不属于可忽略空白
把分隔符改成冒号后,得到1020:3040:50,直接还原会抛ValueError。程序只对自己刚生成、格式已知的这一串文本移除冒号,再调用fromhex,结果才能成功往返。这一步说明显示格式与读取格式要配套设计。
对不受信任的外部文本,不宜不加检查就删除所有非十六进制字符。这样可能把拼写错误或字段混入隐藏掉,还原出一串看似合法但含义错误的数据。若接口允许冒号,应限定分隔位置、每组长度和总长度,并在发现其它字符时清楚报错。
组宽不是字段解析器,也不是字节交换
两个hex调用之后,packet仍与最初五字节逐项一致。负组宽只改变分隔起点,不会把字节倒过来,也不会替你把大端字段变成小端。需要把一组字节解释为整数时,应另行使用协议规定的解析方法与字节序。
末尾断言还覆盖空字节串和不足一组的一字节输入:空输入显示为空,短输入原样显示,不会自动补零凑齐组宽。如果接收端必须收到整组字段,补齐或拒绝都应属于单独的协议校验,不能从日志排版是否整齐推断报文已经有效。
实际排查时可以先打印无分隔的原始十六进制作为核对基准,再生成便于阅读的字段视图。两份表示各自服务一个目的,并用往返检查证明没有改变内容;调试输出就不容易因为视觉上更整齐而掩盖真正的字段边界。
参考资料
资料核验日期:2026年10月2日。以上输出来自固定输入的本地实跑,退出码为0。



