

用 AI 复算 Cohen kappa:同样九成标注一致,为什么分数会差这么多
检查训练标签或AI辅助标注时,两位标注者有九成记录选了同一类,听起来已经很一致。但如果两人几乎总选同一大类,这个比例与类别均衡时的九成不完全一样。Cohen kappa用各自的类别边际构造机会一致基线,因此两组九成可能得到不同分数。
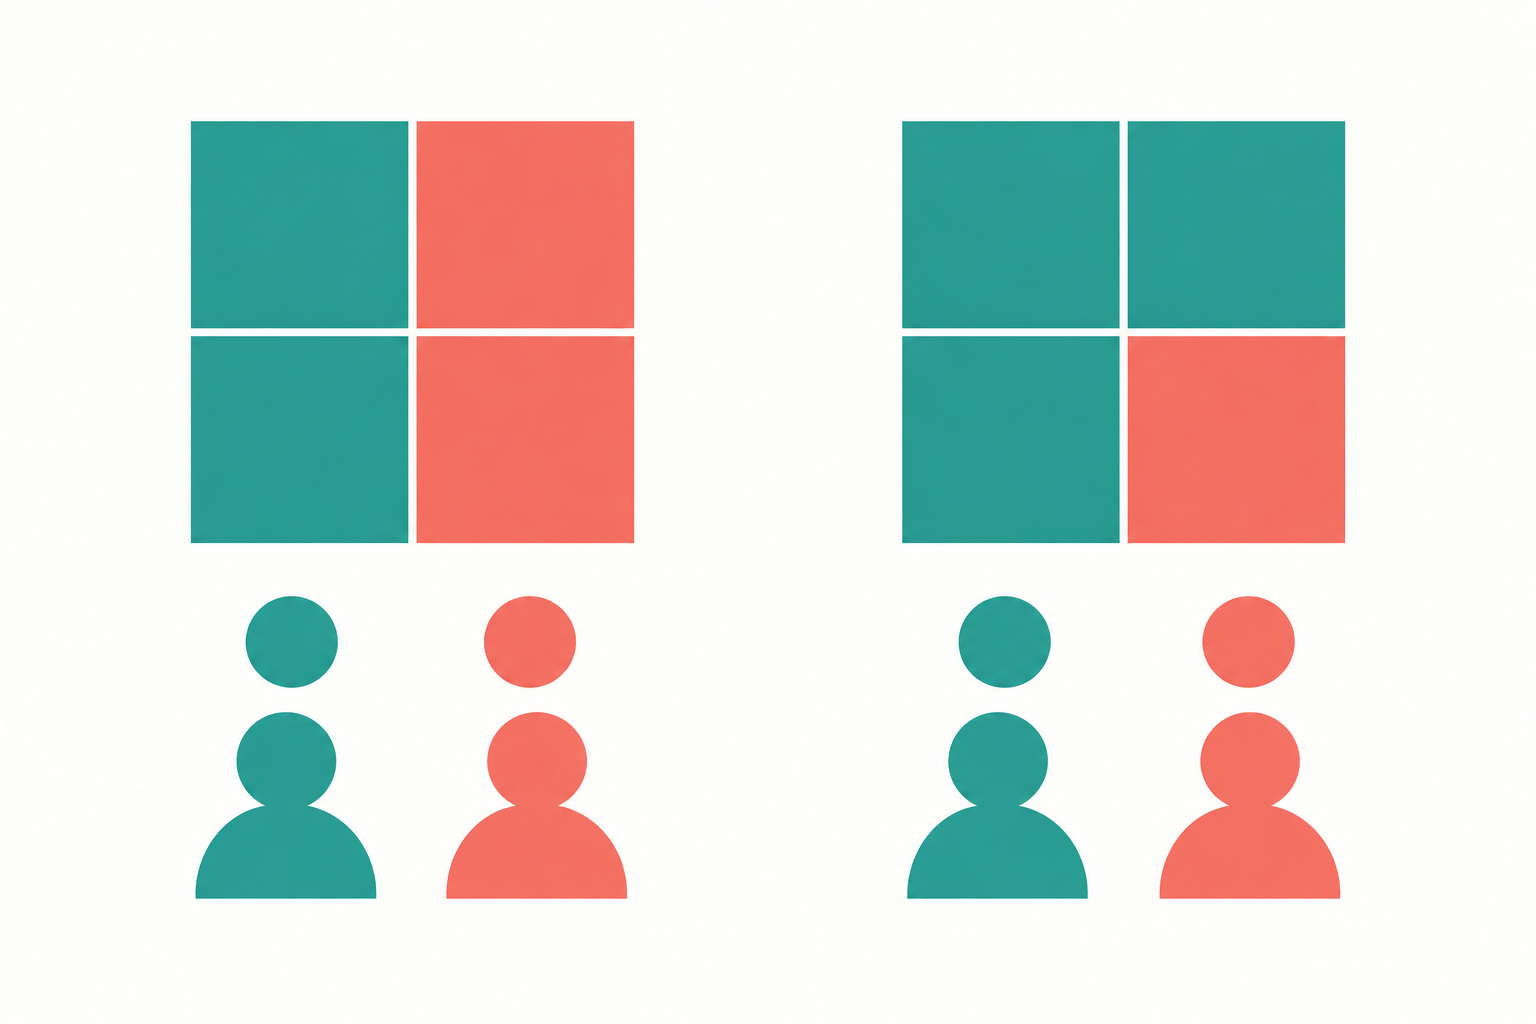
AI生成的概念示意图:类别占比会影响一致性比较;色块比例只提示概念,不是正文交叉表或真实标注统计。
先写出两位标注者的四个交叉格
第一份教学数据共20条,类别只有甲与乙。以标注者一为行、标注者二为列,四格为:都选甲9条,一选甲二选乙1条,一选乙二选甲1条,都选乙9条。因此观察一致率pₒ=(9+9)/20=0.9。
两位标注者各有10条甲、10条乙。按照各自边际概率独立选类,机会一致率pₑ=(10/20)×(10/20)+(10/20)×(10/20)=0.5。未加权kappa=(pₒ-pₑ)/(1-pₑ),所以本组为(0.9-0.5)/(1-0.5)=0.8。
仍然只分歧两条,但大类占比变了
第二份也是20条,四格改成:都选甲17条,一选甲二选乙1条,一选乙二选甲1条,都选乙1条。观察一致率仍为18/20=0.9,两种方向的分歧也各一条。
但两位标注者现在都选了18条甲、2条乙。机会一致率变为0.9×0.9+0.1×0.1=0.82。kappa=(0.9-0.82)/(1-0.82)=4/9,约0.444444。降低的分数来自不同的边际基线,而不是算丢了那18条一致记录。
机会基线不是实际随机标注的指控
pₑ是一套由边际比例构造的比较模型,不代表这两位实际在乱猜。第二组0.82也不是“已经证明82%的标签没有价值”。kappa衡量超过该机会基线的相对一致程度;它不会判断甲、乙哪一类才是真实答案。
即使两人完全赞同同一套错误规则,观察一致率也能很高。因此做AI标注质检时,仍需回到明确定义的标准答案或仲裁流程。把一位标注者叫作“真值”,不会自动使其判断正确;一致性与正确性需要分别建立证据。
让AI先还原名单,再交一个分数
可提示:“保留每条记录ID与两列标签;生成交叉表、行边际、列边际;计算观察一致率、机会一致率与未加权kappa;列出分歧ID,不给武断等级结论。”这样能发现漏行、错位与类别名称不统一,避免一个漂亮数字掩盖数据对应错误。
本次独立程序从两张表展开20条配对标签,再调用指标实现;同时使用有理数直接复算两种kappa,结果分别为4/5与4/9。交换两位标注者的位置时,行列互换,结果保持相同,这是可加入的对称性检查。
固定同一批样本,才方便比较变化
如果新旧版本用的样本群体不同,类别占比变化本身就能改变kappa。比较标注工具或规则修订时,应优先保留共同测试集,同时报告原始交叉表、各类比例和观察一致率。第二组分数较低,不能据此直接宣布某位标注者能力退步。
本例不使用样本权重,也不使用线性或二次加权kappa。若类别有明确顺序,可以讨论分歧严重程度,但那是另一个预先定义的评分选择,不能看结果后挑一个最高分来报告。多名标注者和缺失标签也需要对应的数据约定。
若两人把全部样本都选成同一类,则pₒ=pₑ=1,公式成为零除以零,无法由这个定义给出有效数值。不要把库的缺省值或替代值写成有统计含义的完美分数。遇到这种情况,应直接报告单一类别与缺少区分信息,再补充有代表性的评估样本。
资料核对日期:2026年10月2日。数据为原创教学设定,已用独立本地程序复核,未进行真实模型训练或生产效果测试。



