

GNU join 重复键实战:左边两行右边两行,为什么连接后得到四行
把用户清单和标签清单按第一列连接,输入各有两条同键记录,输出却多了一倍。若把join理解成“找到一个对应项就接上”,就会误以为工具重复了数据。实际上,同一连接键下的每一对输入行都能生成结果;重复键决定了连接的基数,而不只是一个可以忽略的格式问题。
本例在Linux、Bash 5.2.37与GNU coreutils 9.7实跑。固定小样本由printf生成,进程替换提供只读输入,不创建或改写业务文件。LC_ALL=C统一排序与字符比较环境;脚本需要Bash,不能直接当作通用sh脚本运行。
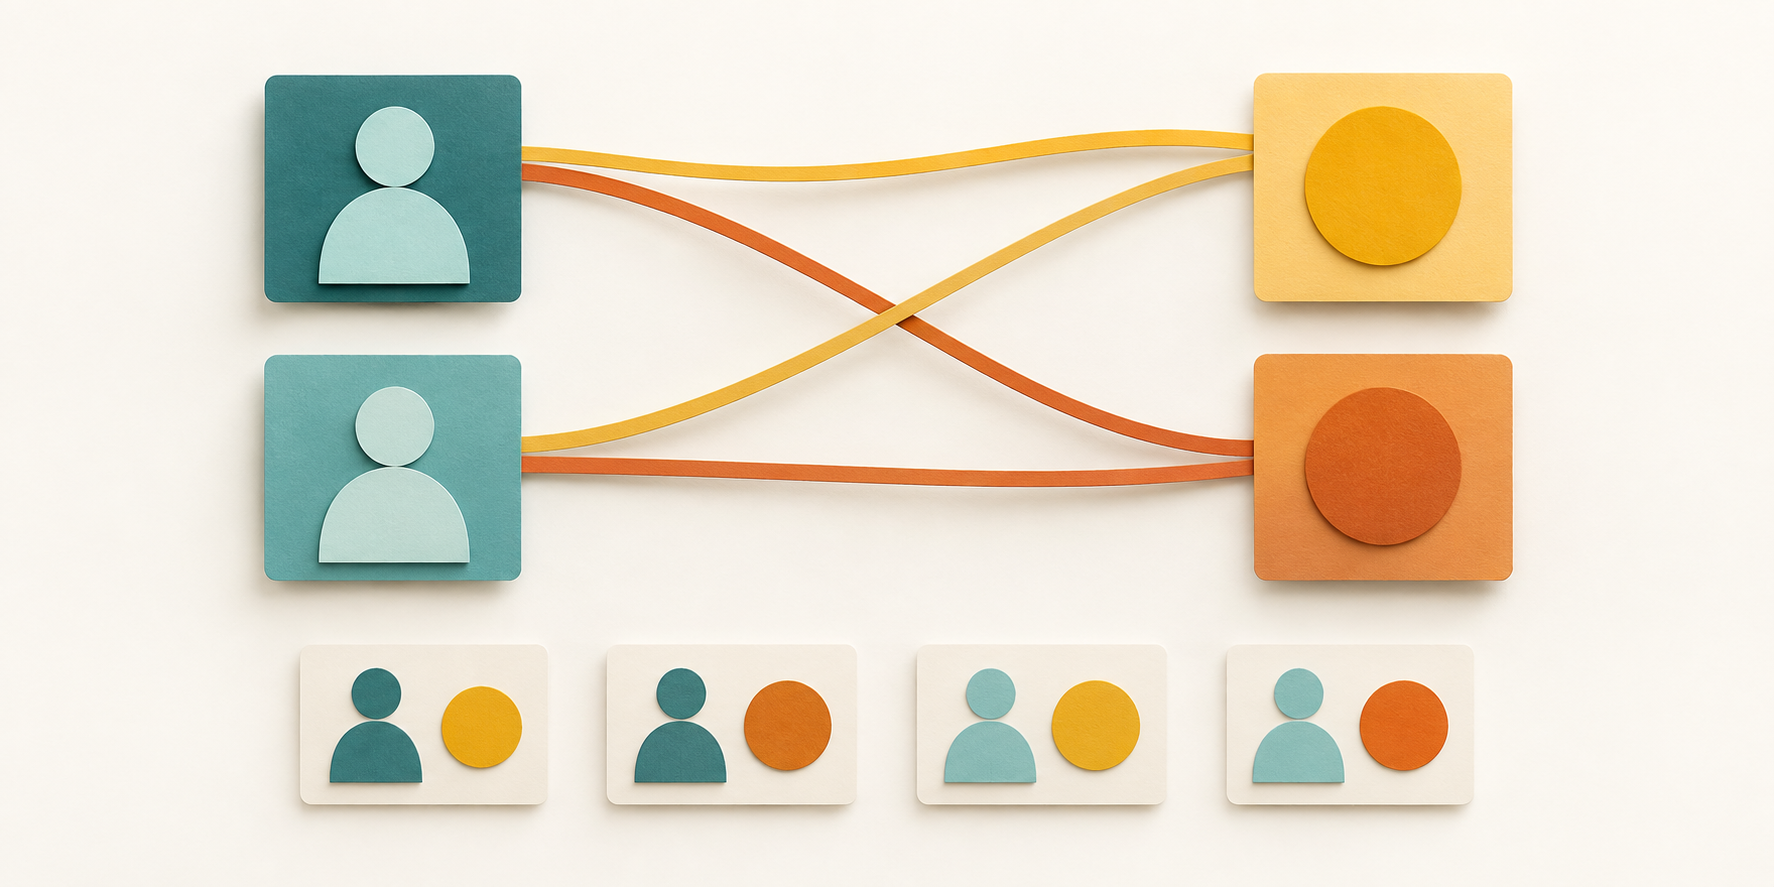
AI生成的概念示意图:左侧两张同色人物卡与右侧两张颜色卡逐一连线,形成四个独立组合;不是真实软件界面或运行截图。
完整程序与实际输出
保存为demo.sh,执行bash demo.sh。代码与输出分列如下。
#!/usr/bin/env bash
export LC_ALL=C
left() { printf '%s\n' 'a Alice' 'a Amy' 'b Bob'; }
right() { printf '%s\n' 'a red' 'a blue' 'c green'; }
printf '%s\n' '[duplicate key combinations]'
join <(left | sort -s -k1,1) <(right | sort -s -k1,1)
printf '%s\n' '[also retain unmatched rows]'
join -a1 -a2 -e NA -o '0,1.2,2.2' \
    <(left | sort -s -k1,1) <(right | sort -s -k1,1)
本次实际标准输出:
[duplicate key combinations]
a Alice red
a Alice blue
a Amy red
a Amy blue
[also retain unmatched rows]
a Alice red
a Alice blue
a Amy red
a Amy blue
b Bob NA
c NA green
先给每条输入独立身份
左表a键有Alice和Amy,右表a键有red和blue。输出分别为Alice-red、Alice-blue、Amy-red和Amy-blue,共四行。四行各自对应不同的一对源记录,所以不是同一行被打印四次。只按文本判断“重复”,会把有意义的组合错误去掉。
如果某键左侧有m行、右侧有n行,匹配部分最多体现为该组的m乘n个配对。本例用二乘二让关系一眼可见;在大清单里,一个意外的高频键就可能使结果迅速膨胀。连接前统计键频率,往往比连接后再清理重复更容易定位问题。
连接之前对相同的键排序
两边均用sort -s -k1,1按第一列排序,join默认也按第一列匹配。-s让同键行保持样本中的顺序,所以输出顺序稳定可读。若改成第三列连接,预排序也必须改到第三列,不能只修改join参数而沿用原有排序步骤。
本例字段内部没有空格,默认空白分隔足够表达记录。若名称可以包含空格,应选择双方共同的明确分隔格式,并在sort与join上一起配置。带引号与字段内换行的CSV还需要真正的CSV处理器;把逗号传给-t不会自动实现CSV转义规则。
未匹配行默认不出现在结果里
第一组看不到b Bob和c green,因为普通连接只输出有配对的行。第二组加-a1和-a2,让左右两侧未配对记录也留下来,便于检查资料缺口。-o明确输出连接键、左表第二列与右表第二列,避免字段结构跟着是否匹配发生变化。
-e NA给缺失输出字段提供显示值,于是得到b Bob NA和c NA green。NA只是本次展示约定;如果真实数据本身允许NA,就无法凭它区分缺失与真实内容。正式导出可以使用不会冲突的编码,或增加来源状态列,并在下游保留缺失含义。
先约定一对一还是多对多
若业务要求每个用户只有一条配置,就应在连接前验证配置表键唯一,发现重复后中止或交给明确规则处理。直接sort -u整行只会删掉完全相同的行,不会保证键唯一;随意保留第一条也可能丢掉较新的或更有效的记录。
本例的多对多连接是有意构造,不意味着所有重复键都该报错。标签组合分析可能恰好需要全部配对,账户配置关联则往往不需要。验收应同时核对行数、未匹配项和少量可手算的组合;不要因为命令退出零,就认定这次数据关联符合业务关系。
参考资料与验证记录
官方资料核验于2026年10月3日。本次完整程序退出码为0,标准错误为空。



