

JavaScript Intl.Collator 自然排序:数字、相等项与比较器边界
文件列表里的 file10.txt 排在 file2.txt 前面,通常不是排序坏了,而是默认字符串顺序没有把连续数字当作数量。Intl.Collator 可以根据语言规则比较文本,numeric 选项适合常见编号名称。本文用本地数组说明自然排序、相等项和比较器边界,示例使用支持 Intl 的现代 Node.js,不读取文件或调用外部服务。
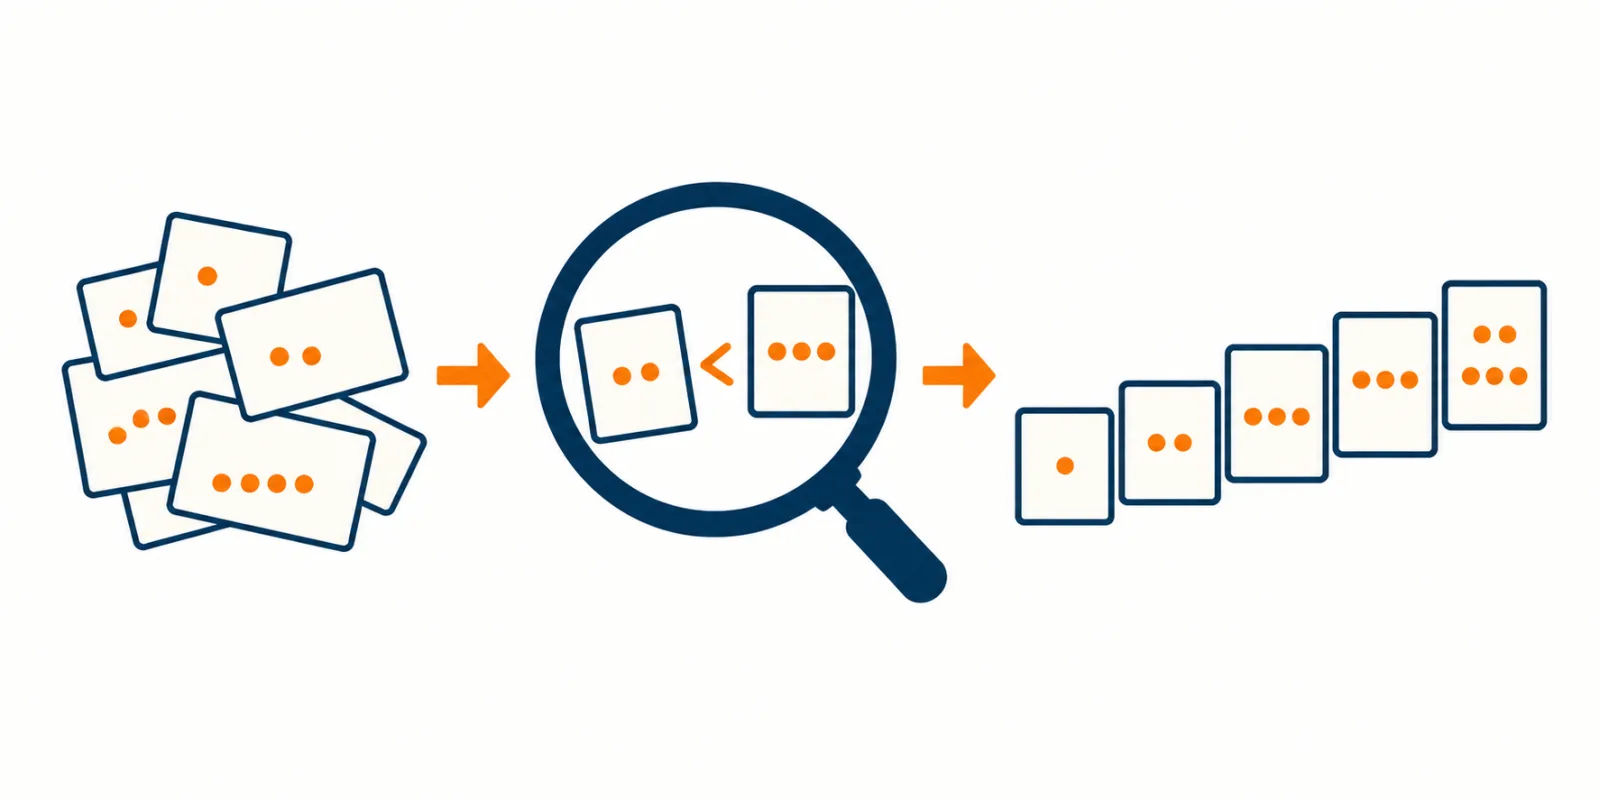
AI生成概念配图:带有不同数量圆点的卡片经过比较后有序排列。仅作概念说明,不代表实际界面或实测结果。
先固定比较规则,再排序
为一批数据创建一次 Collator,并复用它的 compare。显式指定 en,避免依赖机器默认语言;usage 选择 sort。numeric:true 让数字片段参与数值顺序,sensitivity:base 则按所选语言的基础字母层级比较,示例中的大小写被视为相等。中文姓名列表应另行确定语言与排序需求,不能直接照搬英文配置。
下面把代码保存为 collator_demo.cjs 后用 node 运行。业务编号只接受互不重复的正安全整数,名称只接受字符串;输入在排序前完成检查。先按名称比较,相等时用编号决定顺序,得到可解释的第二排序条件。
const assert = require('node:assert/strict');

const collator = new Intl.Collator('en', {
  usage: 'sort',
  numeric: true,
  sensitivity: 'base',
});
assert.equal(Intl.Collator.supportedLocalesOf('en').length, 1);
assert.equal(collator.resolvedOptions().numeric, true);

const rows = [
  { id: 3, name: 'file10.txt' },
  { id: 2, name: 'file2.txt' },
  { id: 1, name: 'file02.txt' },
  { id: 4, name: 'File2.txt' },
];
assert(rows.every(row => typeof row.name === 'string'
  && Number.isSafeInteger(row.id) && row.id > 0));
assert.equal(new Set(rows.map(row => row.id)).size, rows.length);

function compareRows(a, b) {
  const byName = collator.compare(a.name, b.name);
  return byName || (a.id - b.id);
}

const before = JSON.stringify(rows);
const sorted = [...rows].sort(compareRows);
assert.deepEqual(sorted.map(row => row.id), [1, 2, 4, 3]);
assert.equal(JSON.stringify(rows), before);
assert(collator.compare('file2.txt', 'file10.txt') < 0);
assert.equal(collator.compare('file2.txt', 'file02.txt'), 0);
assert.equal(collator.compare('file2.txt', 'File2.txt'), 0);

const tied = rows.filter(row => row.id !== 3);
const stable = [...tied].sort((a, b) => collator.compare(a.name, b.name));
assert.deepEqual(stable.map(row => row.id), [2, 1, 4]);

for (const a of rows) {
  assert.equal(compareRows(a, a), 0);
  for (const b of rows) {
    assert(Math.sign(compareRows(a, b)) === -Math.sign(compareRows(b, a)));
    for (const c of rows) {
      if (compareRows(a, b) < 0 && compareRows(b, c) < 0) {
        assert(compareRows(a, c) < 0);
      }
    }
  }
}
console.log(sorted.map(row => row.name).join(', '));
console.log('sorting checks passed');
只判断比较结果的正负
本次在 Node.js v24.19.0 中运行,输出依次为 file02.txt、file2.txt、File2.txt、file10.txt,随后打印检查通过。断言还覆盖原数组未变、名称相等、稳定排序及样本中的反对称与传递关系。有限样本不是数学证明,但能及时发现常见比较器错误。
compare 返回负数、零或正数,不承诺只能返回负一和正一。不要写成“结果等于负一才算小于”,也不要给 sort 返回布尔值。比较同一对元素应得到一致结果,不在比较过程中修改元素、读取变化中的时间或临时切换排序方向。降序可交换比较参数,同时明确第二条件是否也要反转。
相等不代表文本完全相同
本例配置下 file2、file02 与 File2 的名称比较可以相等,所以显式编号决定它们最终次序。现代规范要求稳定排序:比较结果为零时保留输入中的先后关系。稳定性并不能让顺序随机的上游数据自动一致;接口分页、导出或缓存若依赖固定顺序,应把唯一编号纳入排序契约。
示例复制数组后再调用 sort,因此原数组的排列保持不变;复制仍是浅复制,对象本身没有被复制。若后续修改名称,两个数组中的同一对象都会受影响。表格组件里尤其要区分“重新排列集合”和“编辑记录”,避免把排序函数写成数据清洗步骤。
自然排序有明确适用范围
数字排序针对文本中的数字序列,不是金额、带符号小数或语义版本的完整解析器。价格应先按约定格式解析并验证,版本号应按版本规范比较;不要因为文件编号样本正确,就推断负数、小数点和预发布标记也符合业务意义。缺失名称也应提前规定放置位置,不要任由隐式字符串转换决定。
不同引擎及排序数据版本可能改变某些文字的相对次序,即使 resolvedOptions 看起来相同。可读列表适合语言排序;需要长期一致的校验、签名或跨系统键顺序时,应定义独立的规范化和排序协议。上线验收应包含前导零、大小写、重音、中文、重复名称以及缺失字段,并记录实际运行环境。
如果列表由服务器分页,浏览器只能重排已经拿到的那一页,无法据此保证整个集合有序。应让负责分页的一端采用约定的比较规则,并在请求与响应中保持同一排序字段和方向,否则用户切页时仍可能看到编号跳跃或重复。
唯一编号只负责名称被判为相等时的次序,无法消除不同语言数据对主排序关系的差异。把这两层规则分别写进测试,会比只保存一张看起来正确的列表截图更容易发现升级后的变化。
参考资料
资料核验日期:2026年9月30日,UTC。



