

线性注意力的乘法重排:少存一张大矩阵,分母和因果前缀仍要对齐
长序列注意力会涉及大量查询与键的配对计算。线性注意力的一条思路,是先把键和值汇总成较小状态,再让查询读取状态。阅读或实现这类模块时,应先固定相似度函数,核对两种计算顺序是否等价,再检查因果范围和归一化。
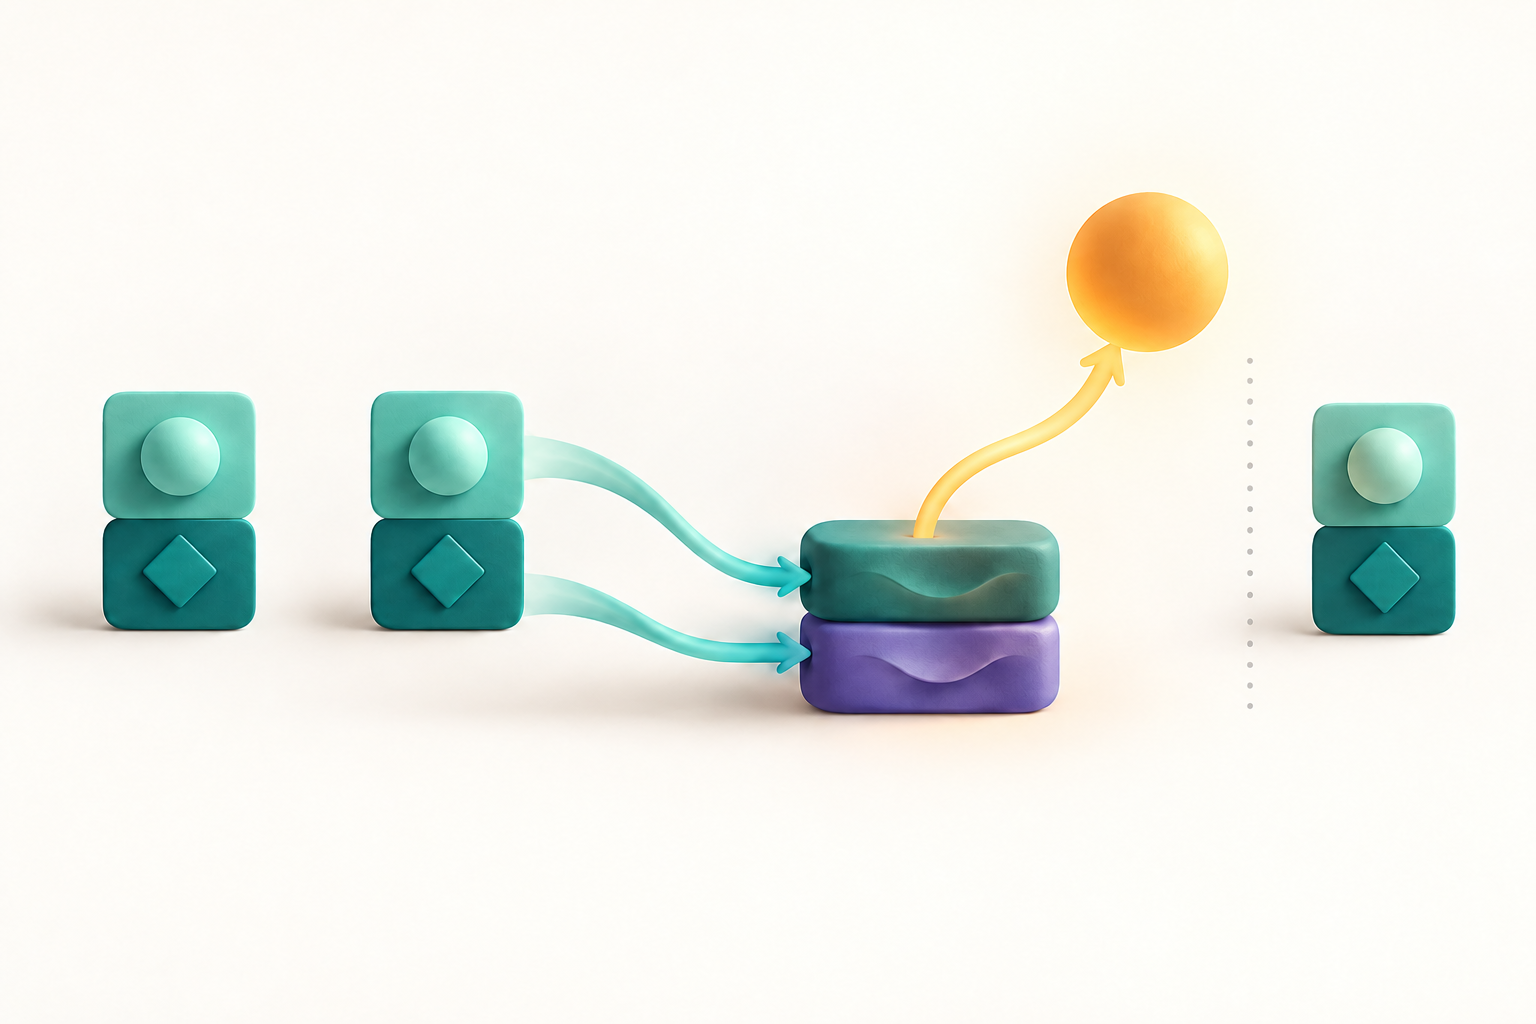
AI生成的概念示意图:历史键值逐步汇入状态,再由当前查询读取;不是运行截图或真实吞吐性能图。
固定一种核,再使用结合律
设相似度为φ(q)与φ(k)的点积,并要求本例的相似度非负、分母大于零。为让每步可手算,本文输入均非负,选恒等映射φ(x)=x。它定义的是此处的点积核注意力,不含指数变换。
查询q=(1,2),三个键分别为k₁=(1,0)、k₂=(0,1)、k₃=(1,1),标量值分别是2、4、8。查询与三键的相似度为1、2、3,除以总和6后,权重为1/6、2/6、3/6。加权输出为(2+8+24)/6=17/3。
现在先汇总S=Σφ(kⱼ)vⱼ,得到(10,12);再汇总z=Σφ(kⱼ),得到(2,2)。查询读取S得到分子q·S=34,读取z得到分母q·z=6,输出仍为17/3。分母也需要自己的汇总量,不能只缓存S。
省掉的是配对展开,不是归一化
对一批查询,分子可以由[φ(Q)φ(K)ᵀ]V改写为φ(Q)[φ(K)ᵀV]。这是矩阵乘法结合律;只要映射、输入和求和范围相同,实数运算下结果一致。实际浮点计算顺序改变后,通常应以容差比较。
如果映射维数为r,值向量维数为dᵥ,汇总矩阵S大小为r×dᵥ,z长度为r。固定这两个维数时,逐个接收键值的汇总工作随序列长度线性增长。本例值是标量,因此S和z总共只需四个数。
这个状态大小只描述该注意力汇总部分,不包括模型参数、其他层缓存或训练所需激活。短序列、较大的特征维度或不同实现也会改变实际收益,公式本身不能代替运行时间测试。
因果计算必须同时截断分子和分母
设三个位置的查询都为(1,2),并约定每个位置可读取自身及过去。第一步状态为S₁=(2,0)、z₁=(1,0),输出2。第二步加入第二个键值后,S₂=(2,4)、z₂=(1,1),输出10/3。第三步状态才到达前面的全量结果,输出17/3。
若第二步分子只用前两项,分母却误用全序列的6,就得到10/6=5/3。它甚至小于当前可见值2和4中的最小值,暴露了权重没有正确归一的问题。不能先做全局汇总,再仅把未来项从分子中去掉。
实现可递推更新Sₜ=Sₜ₋₁+φ(kₜ)vₜᵀ及zₜ=zₜ₋₁+φ(kₜ)。新序列必须重置状态;若业务要求不看当前位置,应先读旧状态再写入。任意复杂掩码也未必能表示成这个简单前缀。
可再做一个专门的泄漏测试:只把第三个值从8改为800,前两个位置的因果输出都应保持不变,第三个位置才发生变化。这个检查比单纯核对最终结果更敏感,因为最终一步本来就允许读取全部三个键值。另起一条序列时,应确认上一条的状态没有残留。
用softmax比较,确认没有换错目标
保持同样q、k和值,若按二维标准缩放点积注意力计算,把(1,2,3)除以√2后做softmax,权重约为(0.140029,0.283995,0.575975),输出约6.023843,与17/3不同。
差异来自相似度定义改变。softmax中的逐项指数不能靠普通乘法结合律挪到另一边;有限维映射若用来近似指数核,还要另报近似误差。验证代码时,可让AI交出逐对计算、汇总计算、因果前缀三条路径,先在同一种核下对齐。
最后补一个分母为零的测试,并明确报错、屏蔽或数值保护策略;若添加稳定常数,也要记录输出已发生相应变化。
资料核对日期:2026年10月3日。以上为原创教学数据,已用Python逐项复算,未进行模型训练或真实性能测试。
参考资料
Katharopoulos等:Transformers are RNNs,第3.2与3.3节



