

GNU uniq 相邻去重:相同记录为什么还会留下两份
一份事件日志里,同一个状态可能连续重复,也可能隔了几个事件再次出现。把整份文件交给uniq以后,明明相同的状态仍然出现两次,这通常不是命令漏查,而是需求与处理单位没有对齐。uniq围绕连续相同的记录段工作,它不保存所有历史值来判断某行是否曾经出现。要修正脚本,先确定要消除的是连续噪声,还是整个集合中的重复成员。
本例在Linux、GNU Coreutils 9.7与Bash 5.2.37实跑,LC_ALL固定为C。输入全部是单字节ASCII记录,每条都有换行,不涉及业务文件。在线GNU手册用于核对选项语义,不能将手册页显示的版本误写为本次实际安装版本。
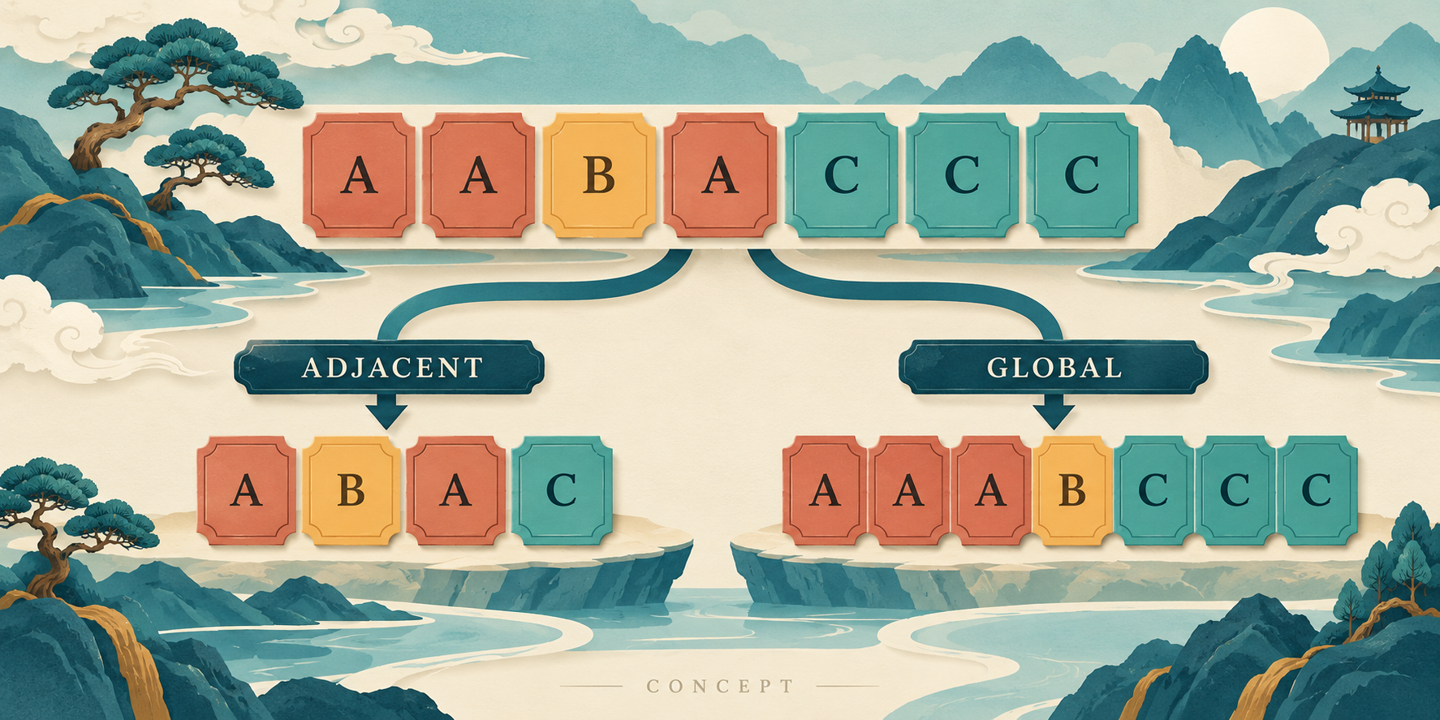
AI生成的概念示意图:不同颜色的记录票据先按相邻片段收拢,再与全局整理的路径对照,强调连续段和全局集合的区别;不是真实软件界面或运行截图。
完整程序与实际输出
保存为demo.sh,执行bash demo.sh。程序只使用固定测试输入,代码和本次输出分别列出。
#!/usr/bin/env bash
set -euo pipefail
export LC_ALL=C
records() { printf '%s\n' A A B A C C C; }
printf '%s\n' '[adjacent groups]'
records | uniq -c
printf '%s\n' '[single-line groups]'
records | uniq -u
printf '%s\n' '[repeated groups]'
records | uniq -d
printf '%s\n' '[global counts after sorting]'
records | sort | uniq -c
本次实际标准输出:
[adjacent groups]
      2 A
      1 B
      1 A
      3 C
[single-line groups]
B
A
[repeated groups]
A
C
[global counts after sorting]
      3 A
      1 B
      3 C
先给每个连续片段编号
输入顺序是A、A、B、A、C、C、C。对uniq来说,这不是三类字母,而是四个连续片段:两个A、一条B、一条A、三个C。遇到B以后,第一个A片段已经结束;后来再遇到A会开启新片段,命令不会回头把它和早先那一段合并。因此默认输出会保留A、B、A、C,两个A各代表一次状态出现。
加上-c只是把每个连续片段的长度写出来,没有扩大比较范围。实际输出里的两行A分别标成二和一,恰好证明它统计的是段长。若用这份结果计算某用户全日请求量,可能把同一用户拆成很多行;但若要查看服务状态连续持续了多少个采样点,这种分段结果反而正合适。
这一区别也决定了处理成本。相邻比较无需维护所有已见键,适合按顺序处理较长输入;全局去重则需要排序、索引或集合等额外组织。不要为了让输出“看起来只出现一次”就随手排序,时间序列里的先后关系本身可能就是分析对象。
两个容易被名字误导的选项
uniq -u并不是通常口语中的“每个值保留一份”。它只输出长度为一的连续片段。本例得到B和后来的A,而早先连续出现两次的A被过滤掉。于是一个全局出现三次的值,仍然可能进入-u结果。若把它当作“整份清单里只出现一次的用户”,筛选条件就已经错了。
uniq -d选择长度大于一的片段,并为每个这样的片段保留一个代表。本例得到A和C。若同一个值在不同位置各形成重复片段,它可以在-d结果里再次出现。-d回答“哪些连续段发生过重复”,并不自动回答“全局有哪些重复值”。
三个需求可以明确命名:压缩连续片段、列出所有不同值、筛选全局只出现一次的值。先写清目标,再选命令,比凭选项字母联想更可靠。验收时尤其要放入“前面重复、后面单独再出现”的样本,因为只有相邻重复的整齐数据无法暴露这类混淆。
什么时候应当先排序
最后一组把同样输入先交给sort,再用uniq -c。相等整行聚在一起以后,A的计数变成三,B是一,C是三。这时片段与全局键才重合。若只要每个不同整行的一份,可考虑sort -u;若需要出现次数,则排序后再计数更直观。两种方案都会改变原始顺序,输出不能再当作事件回放。
排序规则和比较规则必须协调。示例在整个脚本开头导出LC_ALL=C,而不是只给管道左侧某个命令设置环境。这样排序与相邻比较都处在同一规则下。生产脚本若更换语言区域,应重新验收带重音字母、大小写和空白的记录,不要把本例ASCII的结果推广为语言学意义上的相同。
只按部分字段排序,还要检查去重究竟比较什么。sort使用键选项时,“键相同”可能包含内容不同的整行;uniq若仍比较整行,并不会自动继承sort的键定义。跳过字段、忽略大小写或截断比较宽度也都改变了等价关系,应该把业务键明确写进测试,而不是让一条长管道暗中决定。
把去重规则写成可验收的契约
本例七条记录已经覆盖连续重复、隔开后重复以及真正单次三种情况。再加上空输入、单行输入、末尾没有换行和含空白的行,就能形成一套小而有效的回归样本。核验时同时看输出内容、顺序和计数之和:未过滤的相邻计数总和应等于原记录数,排序后的全局计数也应保持这个总和。
若业务要求保留首次出现的顺序,应选维护已见集合的处理方式,或在数据库里明确计算首次位置后再排序。代价是需要保存更多状态;若数据规模很大,还要决定内存上限和外部排序方案。uniq本身不会免费提供这一语义,把工具边界讲清楚比叠加更多选项更重要。
写回文件时也要保留原输入,先输出到独立结果文件再验收。不要用同一路径同时作为输入和shell重定向目标,重定向可能在命令读取前就清空文件。本教程刻意只走标准输入输出,便于反复试验。确认规则后再接真实日志,能避免用一次不可逆覆盖来验证对命令的猜测。
对于实时状态流,保留隔开后再次出现的A往往正是正确结果:它说明系统离开过状态A,后来又回来。若先排序再去重,这段转移信息将永久消失。对库存编码清单则相反,出现位置通常不重要,归并全局相同编码才符合需求。工具没有替你选择业务模型,比较范围应由使用结果的人先明确。可以把本文输入画成四段,再由业务方说明究竟要保留几段或几个值;这比只问“要不要去重”更容易得到准确答案。
参考资料与验证记录
官方资料核验于2026年10月3日。本次完整程序退出码为0,标准错误为空;例子验证的是上述固定输入与运行环境,不表示所有平台和版本的输出细节完全一致。



