

Python itertools.compress:选择器已经用完,为什么源数据又被取走一项
有一条数据流和一串选择标记,compress可以按标记筛出需要的元素。但选择器只有两项时,数据流结束过滤后却可能已经走过第三项。若后面还要继续消费同一个迭代器,这个差异就会造成一条记录看似凭空消失。过滤结果只描述哪些元素被产出,并不完整描述输入被拉取了多少次;理解这个边界,才能安全地拼接流式处理阶段。
本例在Linux与CPython 3.12.14上实跑,只使用程序内的固定测试数据,不调用网络服务。文中区分公开API含义与本次解释器的具体观察;替换实现或升级版本时,应保留样本重新验收。
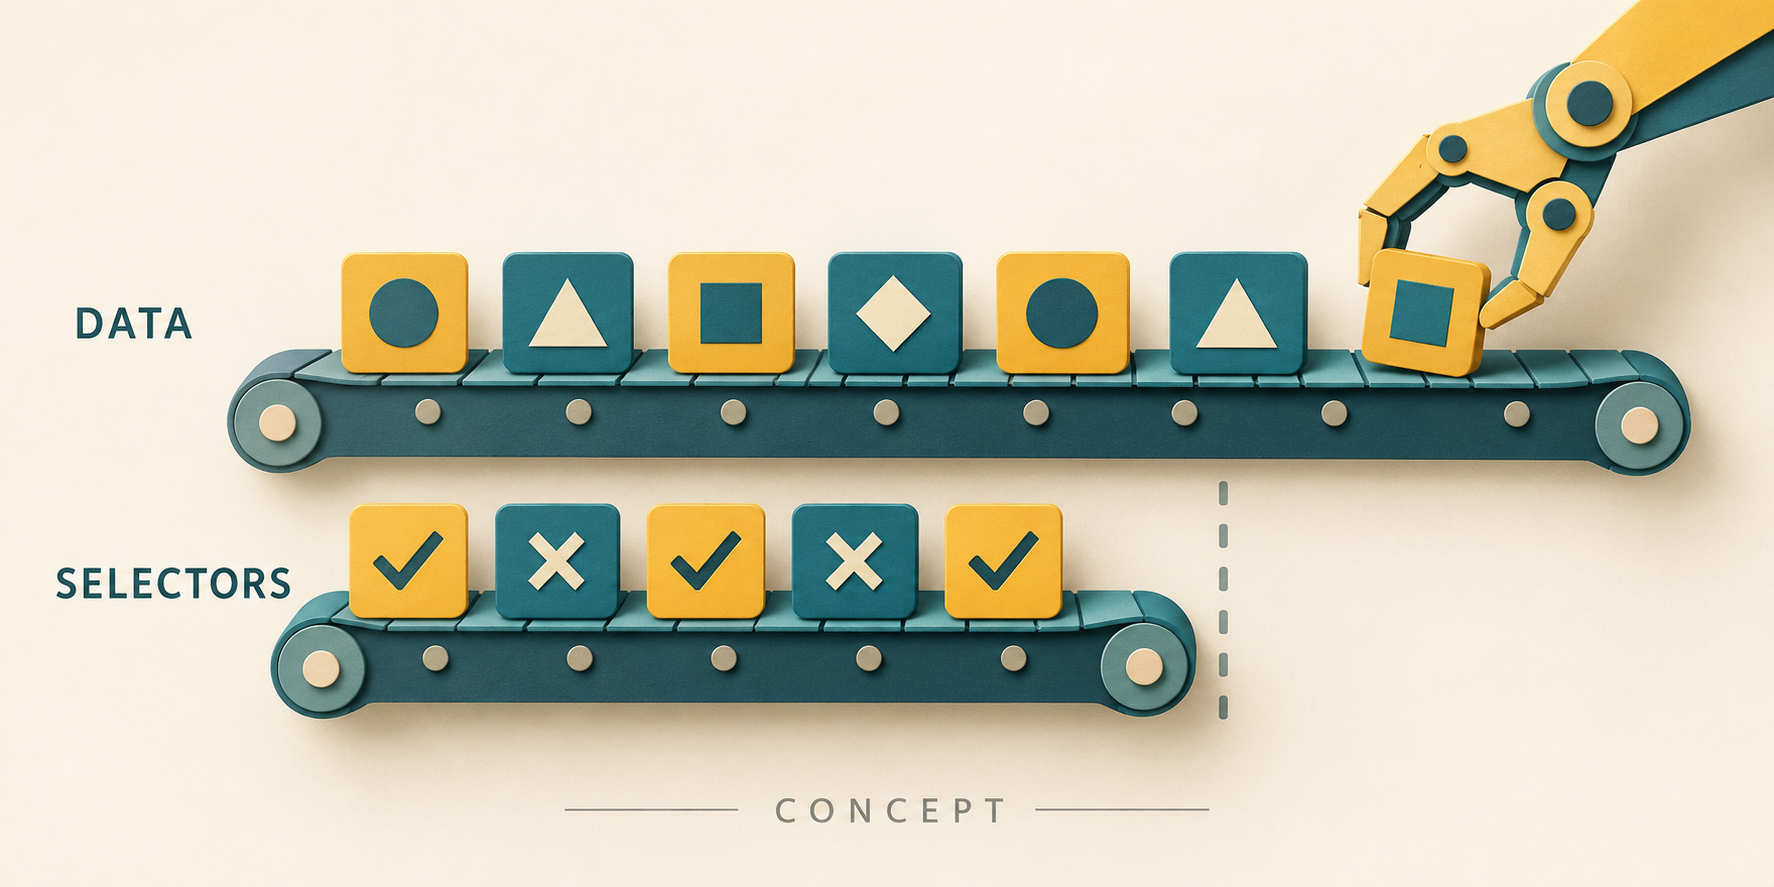
AI生成的概念示意图:数据轨道比选择标记轨道更长,机械手在标记耗尽边界拿起下一枚数据卡片,表示产出和消耗的差别;不是真实软件界面或运行截图。
完整程序与实际输出
保存为demo.py,执行python3 demo.py。程序只使用固定测试输入,代码和本次输出分别列出。
from itertools import compress

def traced(values, seen):
    for value in values:
        seen.append(value)
        yield value

seen = []
data = traced('ABCDE', seen)
print('selected:', list(compress(data, [1, 0])))
print('pulled by compress:', seen.copy())
print('remaining:', list(data))

seen = []
data = traced('ABCDE', seen)
selectors = [1, 0]
selected = []
for flag in selectors:
    value = next(data)
    if flag:
        selected.append(value)
print('selector-first:', selected)
print('pulled by explicit loop:', seen.copy())
print('remaining:', list(data))
print('truthiness:', list(compress('XYZ', [[], 'false', 0])))
本次实际标准输出:
selected: ['A']
pulled by compress: ['A', 'B', 'C']
remaining: ['D', 'E']
selector-first: ['A']
pulled by explicit loop: ['A', 'B']
remaining: ['C', 'D', 'E']
truthiness: ['Y']
用观察器记录每一次拉取
traced在产生一个值之前,先把它写入seen列表。源数据是ABCDE,选择器是列表中的一和零。把compress完全转成列表后,筛选结果只有A:第一项选择A,第二项拒绝B。这部分并不意外,重要的是此时seen已经记录A、B、C,而不是只有前两项。
接下来继续读取原始data,得到D和E。C既没有出现在筛选结果里,也没有留在剩余流中,因为它已经被compress从源头取出,只是在随后发现选择器耗尽时没有对应标记可以处理。程序在读取剩余流之前复制seen用于打印,防止后续list(data)继续追加记录而混淆此前边界。
官方文档给出的概念模型按data、selectors顺序配对,在任意一侧耗尽时停止。停止之前为了探测下一对,可能已经成功拉取前一侧。本文关注CPython 3.12.14的实际消耗行为,不应把“只多读一个”的观察改写成所有自定义迭代器、所有实现都必须遵循的资源承诺。
为什么输出列表无法解释输入进度
零选择标记会消耗对应数据但不产生输出,因此即使没有额外探测,输出长度也不能用来推算源位置。一个很长的全假选择器可以让结果为空,却已经读取大量数据。只有记录每次拉取,或由处理协议显式维护计数,才能知道上游推进了多少。
这一点对普通列表通常影响不大,因为重新遍历列表可以从头创建新迭代器;对文件、生成器或消息消费接口却可能很关键。再次调用iter(data)不会自动让一个已经使用的迭代器回到起点。处理链若希望后续阶段接着读,必须把消费责任与边界协议一起设计,而不是只把data变量继续传下去。
还应区分拉取与确认。本文traced仅写一份观察日志,没有外部副作用。若真实迭代器在next时已经确认消息、移动远端游标或触发昂贵解码,多读一个就可能有实际成本。compress不提供事务回滚或推回元素的接口,因此不能代替具有显式确认语义的队列消费者。
让选择器先行可以改变哪条边界
第二组显式循环先从selectors取标记,进入循环体后才next(data)。选择器耗尽时,循环不会再进入,因此data只消耗A与B,剩下C、D、E。筛选结果仍是A,说明相同结果可以来自不同消费轨迹。是否值得写这个稍长的循环,应取决于后续是否还需要保留源流,而不是只比较代码行数。
这个循环不是一个完备的通用替代品。示例假设数据至少与选择器一样长;若数据先耗尽,next(data)会抛出StopIteration,并且当前选择标记已经被取走。要用于生产,需要定义短数据时是报错、停止还是补位,再给出对应实现。调整拉取顺序能保护某一侧的边界,却不能自动解决所有长度不一致问题。
若两侧都是已知长度的容器,可以在处理前校验长度,或明确只处理双方共有范围。若是一次性流,提前探测完整长度本身又会消费输入。缓存可以换来可回看能力,但需要内存或磁盘空间。没有一种通用写法能够在完全不保存状态的同时,让两个任意流都无限可退回。
选择器使用真值,不是文字布尔解析
最后一行把空列表、字符串false和数字零作为选择器。只有Y被保留,因为非空字符串false在Python中为真。compress不会理解配置文件里的“false”应该代表关闭,也不会要求标记必须是布尔类型。选择器来自JSON、CSV或环境变量时,应该先做明确类型与值校验。
如果业务只允许True和False,可以在入口拒绝其他类型;如果允许零和一,也应该明确是否接受其他非零数字。任意对象的真值测试还可能调用自定义方法,这意味着选择器判断也可能抛出异常。输入读取、真值判断和结果产出是连续的过程,中途失败时不应假定数据流仍停在失败前的位置。
回归测试至少包括空选择器、全假、全真、选择器较短、数据较短和真值异常。每组分别断言筛选结果、被拉取记录与剩余内容。只断言结果等于某个列表,恰好会漏掉本文演示的消费边界;为一次性输入编写测试时,观察副作用往往和检查返回值同样重要。
在接口层面,可以把“筛选并耗尽输入”与“筛选前若干项并保留余下输入”设计成不同函数,避免同一函数暗含两种期望。前一种适合普通批量变换,后一种需要明确返回剩余迭代器或缓冲对象。让消费保证成为接口说明的一部分,能够减少后续维护者误把惰性工具当作无副作用视图。
如果数据与标记来源于同一个外部批次,最好保留共同的记录编号,而不只依赖位置配对。上游某一侧漏掉一项时,compress仍可能正常结束,却把后续标记用于错误记录。长度校验只能发现数量差异,不能证明身份对齐;关键任务应把标记和数据绑定在同一结构中传递。
参考资料与验证记录
官方资料核验于2026年10月3日。本次完整程序退出码为0,标准错误为空;例子验证的是上述固定输入与运行环境,不表示所有平台和版本的输出细节完全一致。



