

Python DictReader 的长短行:已经读成字典,为什么缺列和多列都没报错
导入CSV时,把每行转换成字典很方便,但字典已经返回不意味着列数与表头一致。少一列可能被补入默认值,多一列可能被收集到额外键下,而显式空字段又是另一种情况。若脚本只取id和qty,就可能让不完整记录进入后续计算。下面把语法解析、行形状和字段内容分开验收。
本例在Linux、CPython 3.12.14实跑。仅使用固定测试数据;文件示例由临时文件上下文自动清理,不访问网络或已有业务文件。
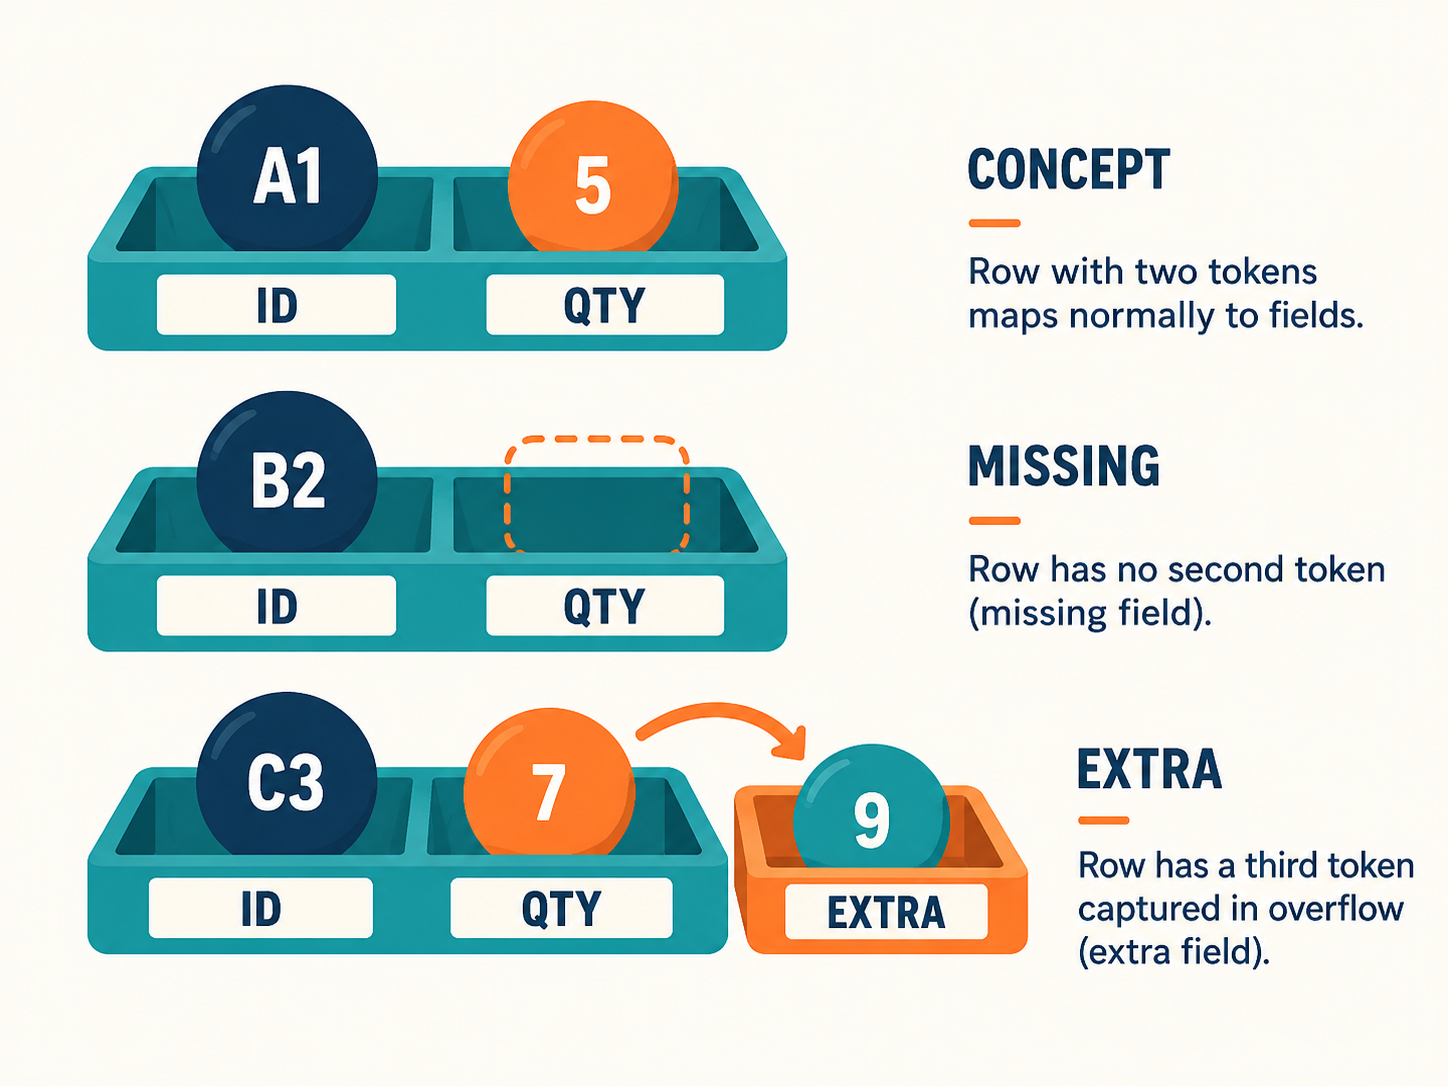
AI模型生成的概念示意图:两格托盘分别展示正常行、缺少第二格和多出一个字段的溢出区,强调列数与字段内容需要分别检查;不是实拍、软件界面或运行截图。
完整程序与实际输出
保存为demo.py,使用Python 3.12运行python demo.py。以下输出来自本次执行,代码中的检查和打印可一起复现。
import csv
import io

text = 'id,qty\nA,2\nB\nC,3,extra\nD,\n'
missing = object()
extra_key = object()
reader = csv.DictReader(io.StringIO(text, newline=''),
                        restkey=extra_key, restval=missing)
assert reader.fieldnames == ['id', 'qty']
for row in reader:
    absent = [name for name in reader.fieldnames if row[name] is missing]
    extras = row.get(extra_key, [])
    if absent or extras:
        print('reject:', row['id'], 'missing=', absent, 'extra=', extras)
    else:
        print('accept shape:', row['id'], 'qty=', repr(row['qty']))
本次实际标准输出:
accept shape: A qty= '2'
reject: B missing= ['qty'] extra= []
reject: C missing= [] extra= ['extra']
accept shape: D qty= ''
先让异常行可见
示例表头为id、qty。A有两个字段,B只有一个,C有三个,D则在逗号之后保留空字段。DictReader按表头映射可以对应的值,多出来的部分放到restkey指定的键下,缺少的部分用restval指定的值补足。这是允许不齐整数据被表达出来的机制,并不负责决定业务该接受还是拒绝。
我们给restval使用一个新建object作为哨兵,判断时使用is。因为CSV的正常字段会读成字符串,这个独立对象不会和输入中的空串、文字None或某个特殊标记撞值。给restkey也使用独立对象,可避免真实表头刚好叫extra时与保留键冲突。两者都只在内存中用来验证,不能直接当作对外JSON的数据结构。
输出显示B缺qty,C多extra;A与D通过行形状检查。这里特意把通过文字写成accept shape,避免让读者误以为D的空数量已经满足业务要求。若qty必须为非空整数,还要在结构合格以后进行空串检查、数值转换、范围约束与业务规则判断。
缺字段与空字段不能共用一个默认值
B这一行根本没有第二个字段,D则提供了第二个字段,只是内容为空。它们在上游表单、数据补发和错误提示中可能代表不同问题。如果直接用空串作为restval,就把二者压成了同一个值;后续无法知道是源文件缺列,还是用户有意留空。应先保存差异,再按明确规则决定是否允许合并处理。
同样,多出来的字段不应悄悄丢弃。它可能来自导出版本升级,也可能是未正确引用的逗号。如果多出的字段本来为空,仍然代表多了一列,不能只检查这些额外字符串是否为真。示例检查的是额外列表是否非空,列表中哪怕只有一个空字符串,也会被识别为多字段。
本程序使用StringIO与固定文本,没有把逗号手工split。实际CSV还可能包含引号包围的逗号和换行,这些应由csv解析器按方言规则处理。真实文件应按官方建议以newline为空字符串打开,再明确编码;列数校验建立在解析后的字段上,不应直接数原始行里的逗号。
表头是另一道必须确认的契约
示例读取fieldnames后,断言它恰好等于预期列表。这同时确认字段名和顺序,并让演示输入的约束清晰可见。生产入口不应依赖可被优化启动移除的assert来拒绝外部数据,而应使用普通条件判断并抛出或记录明确的验证错误。例子里的assert只是对固定测试夹具的自检。
如果容许表头顺序改变,应改为验证所需字段集合,同时单独拒绝重复列名。重复表头在字典表示中会造成同名键覆盖,不能等映射完成以后才试图恢复被覆盖的值。缺少表头、空表头、意外新增字段以及全空文件,也都应有事先约定的处理策略。
错误报告可以保存逻辑记录编号与reader.line_num,但二者不要混为一谈。一个包含引号换行的CSV记录可能跨越多行物理文本。对外提示最好同时说明当前记录序号及已读取的物理行位置,并避免把含个人信息的整条原始记录未经筛选写进普通日志。
通过校验之后再安排写入
对小文件,可以先完整解析和校验,再集中写入;对大文件,可以分批校验并使用事务或暂存区。关键是定义遇到坏行时整批失败、跳过坏行还是等待人工确认,不要让解析器的默认宽容行为替你做决定。若已经写入前面的有效行,再发现后面列数错误,单独抛出异常并不会自动撤销先前的外部操作。
这四行样本适合作为回归测试的核心,再补上多余空字段、重复表头和带引号换行的记录。结果应同时验证被接受的形状、被拒绝的原因以及空值是否仍可区分。CSV转换成字典只是入口,结构明确后,后面的类型和业务验证才有可靠基础。
资料与验证范围
官方文档核验于2026年10月3日。本次程序退出码为0,标准错误为空。输出只证明文中固定输入在所列环境的结果,不能替代生产数据、平台差异与并发压力测试。
Python 3.12官方文档:csv.DictReader



