

Python itertools.batched 的尾批:每组设为二,为什么最后仍只有一个元素
给接口批量提交记录时,经常把数据按固定上限分组。itertools.batched可以省去手写分片循环,但参数二表示每批最多两个元素,并不承诺输入总数一定是二的倍数。最后一组不足时,Python 3.12的默认行为是原样交出短元组;既不会补空值,也不会自动报错。
本例在Linux、CPython 3.12.14实跑。仅使用固定测试数据;文件示例由临时文件上下文自动清理,不访问网络或已有业务文件。
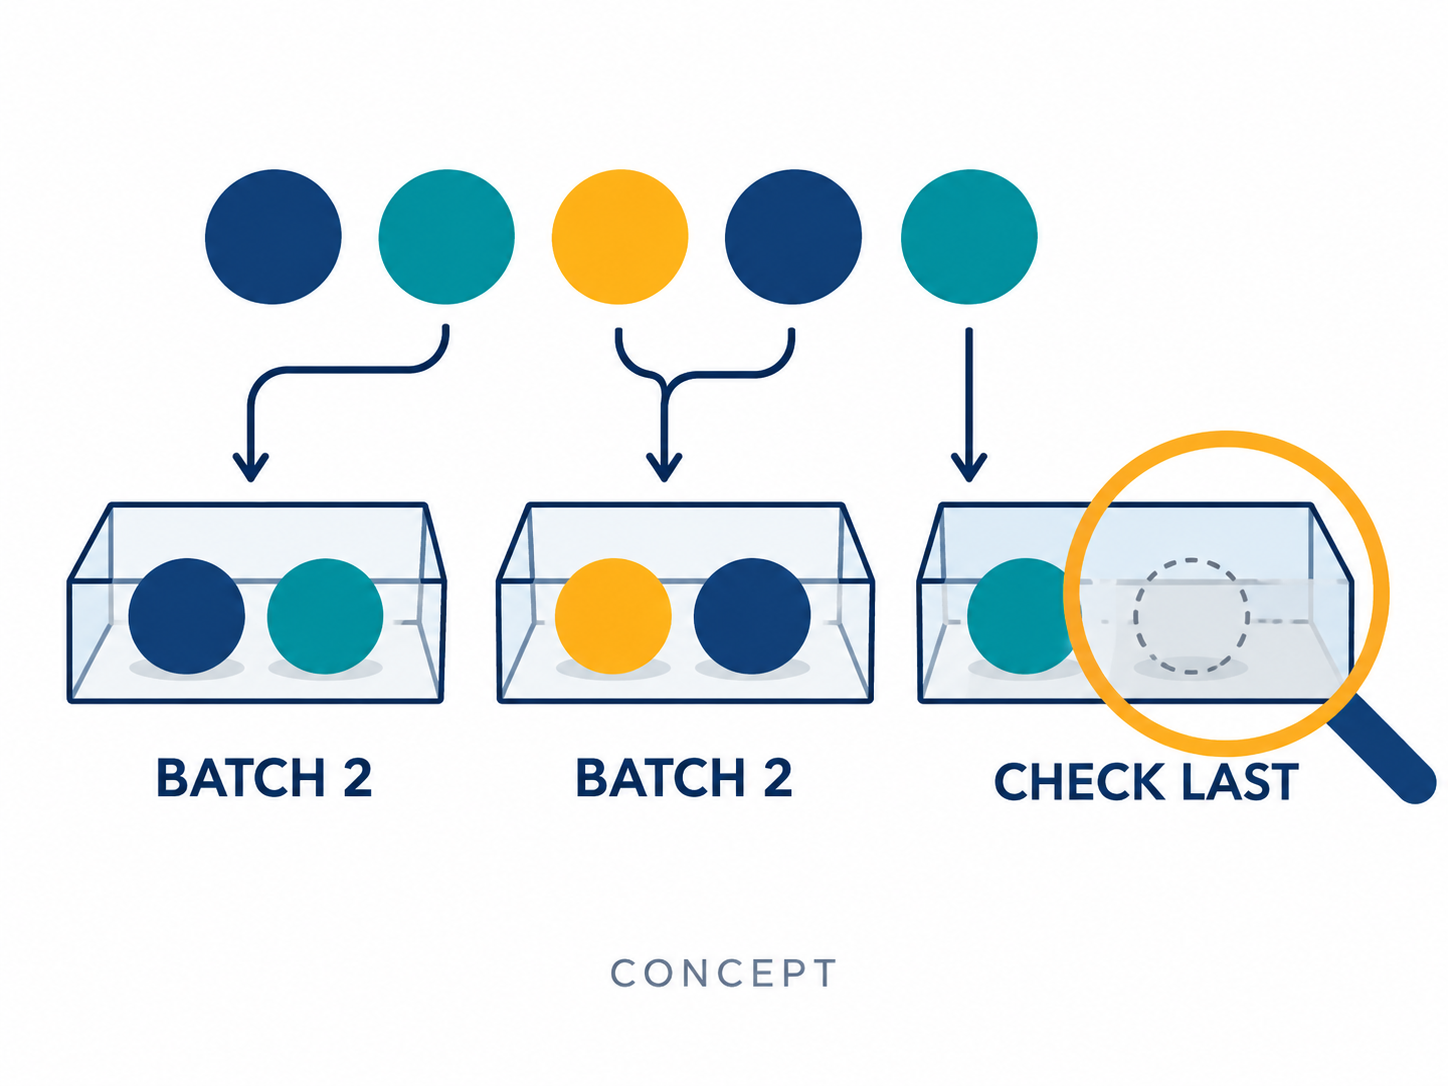
AI模型生成的概念示意图:五个元素依次装入三个两格托盘,末尾只有一枚元素,放大镜提醒检查短批而不是假设自动补齐;不是实拍、软件界面或运行截图。
完整程序与实际输出
保存为demo.py,使用Python 3.12运行python demo.py。以下输出来自本次执行,代码中的检查和打印可一起复现。
from itertools import batched

seen = []
def source():
    for value in range(5):
        seen.append(value)
        yield value

chunks = batched(source(), 2)
print('before reading:', seen)
print('first:', next(chunks))
print('consumed:', seen)
print('remaining:', list(chunks))
print('empty:', list(batched([], 2)))
try:
    list(batched([1], 0))
except ValueError as error:
    print('invalid size:', type(error).__name__)
for index, chunk in enumerate(batched(range(5), 2), start=1):
    if len(chunk) != 2:
        print('reject incomplete:', index, chunk)
        break
    print('validated batch:', index, chunk)
本次实际标准输出:
before reading: []
first: (0, 1)
consumed: [0, 1]
remaining: [(2, 3), (4,)]
empty: []
invalid size: ValueError
validated batch: 1 (0, 1)
validated batch: 2 (2, 3)
reject incomplete: 3 (4,)
一次只取够当前批次的输入
示例用source生成五个数字,并把每次实际产生的数字写入seen。创建batched之后,seen仍是空列表;调用一次next才得到0、1,并使seen变成这两个元素。这个观察把构造迭代器与真正消费数据分开,说明创建分批入口本身没有把整份输入先读完。
继续把剩余批次转成列表,得到2、3以及只含4的元组。每批都是一个独立元组,但元组里面若装的是可变对象,仍然只是保存那些对象引用,不能把分批当作深拷贝。示例使用整数,是为了只观察数量与顺序,不混入对象所有权的问题。
惰性处理适合较长输入,因为无需为全部批次一次性分配容器。但每个已产出的批次仍然要持有相应元素;如果消费者把所有批次保存到列表,最终照样会占用整份数据的内存。节省内存来自按需处理和及时释放,而不是仅仅使用一个叫迭代器的接口。
尾批处理应由数据契约决定
如果接口允许每次最多二百条,最后七条通常是一批正常请求;如果输入本来表示成对的坐标,最后只剩一个元素就意味着结构不完整。这两种业务不能共用“总是忽略最后不足一组”的策略。应在分批前写清楚:允许短批、拒绝短批、补位,还是保留到下一次数据到来。
程序末尾给出显式长度验证:每拿到一批就检查len,遇到不满二的第三批打印拒绝信息并停止。检查发生在获得该批次之后,因此构成尾批的元素已经从输入迭代器里取走。如果需要把它留给下一阶段,应自己保存这份短元组,不能期待重新读取原生成器就能找回。
补位也需要明确的哨兵及规则。把缺少的成员随手补成None,会与输入本来允许的None混淆;给金额补零可能改变平均值或业务含义。若任务要求每组严格完整,拒绝并指出哪批缺少多少成员,通常比生成一个看起来整齐但语义不明的容器更可靠。
严格校验不等于事务性执行
输出里前两批先显示validated batch,第三批才被拒绝。如果实际循环在验证每批后立即写数据库或发送请求,前两批的外部操作可能已经完成。后面发现短批并不会把这些操作撤销。整份输入必须全有或全无时,需要先完整验证,或使用事务、暂存与可恢复的提交协议。
Python 3.12提供batched,但本次环境没有后续版本新增的strict参数,因此程序只展示可以直接在3.12运行的显式检查,不把更高版本的文档能力冒充成本地实测。升级解释器后若改用内建严格选项,仍要检查异常发生时已经消费多少输入、前面的业务操作是否已经产生副作用。
输入生成器自身也可能在形成某一批时抛出异常。那不是“正常的最后短批”,而是源数据读取失败,应与数量不足分别记录。捕获过宽的异常并继续处理,可能让半批已经消费的数据失去去向;错误处理需要结合输入可否重读、是否有稳定记录编号和提交进度来设计。
边界测试要包含空输入与非法批量
本例还验证空输入返回空列表,以及批量大小为零抛出ValueError。数量参数应在用户入口检查为正整数,必要时设置业务上限,避免一次构造过大批次。输入总数为零、刚好一批、整倍数和多出一项,是最基本的四种数量样本。
验收不应只比较最终扁平化内容,也要检查每批长度、批次数、输入消费时机以及短批策略。把所有输出元组依次展开后,应当保留原来的元素顺序与数量;若业务主动丢弃或补位,也应在日志和结果统计里单独说明。这样的批处理规则才能从小样例平稳扩展到真实数据流。
资料与验证范围
官方文档核验于2026年10月3日。本次程序退出码为0,标准错误为空。输出只证明文中固定输入在所列环境的结果,不能替代生产数据、平台差异与并发压力测试。
Python 3.12官方文档:itertools.batched



