

C51把回报投回固定网格:概率没丢,均值与方差会怎样变
分布强化学习把随机回报表示为一整份分布,而不只保存一个期望。C51的类别表示使用固定回报支撑点;一次Bellman目标经过奖励平移和折扣缩放,落点往往不再位于原网格,于是需要把概率投回去。最容易写错的地方,是把“落点移动”和“质量重新分配”当成同一件事。
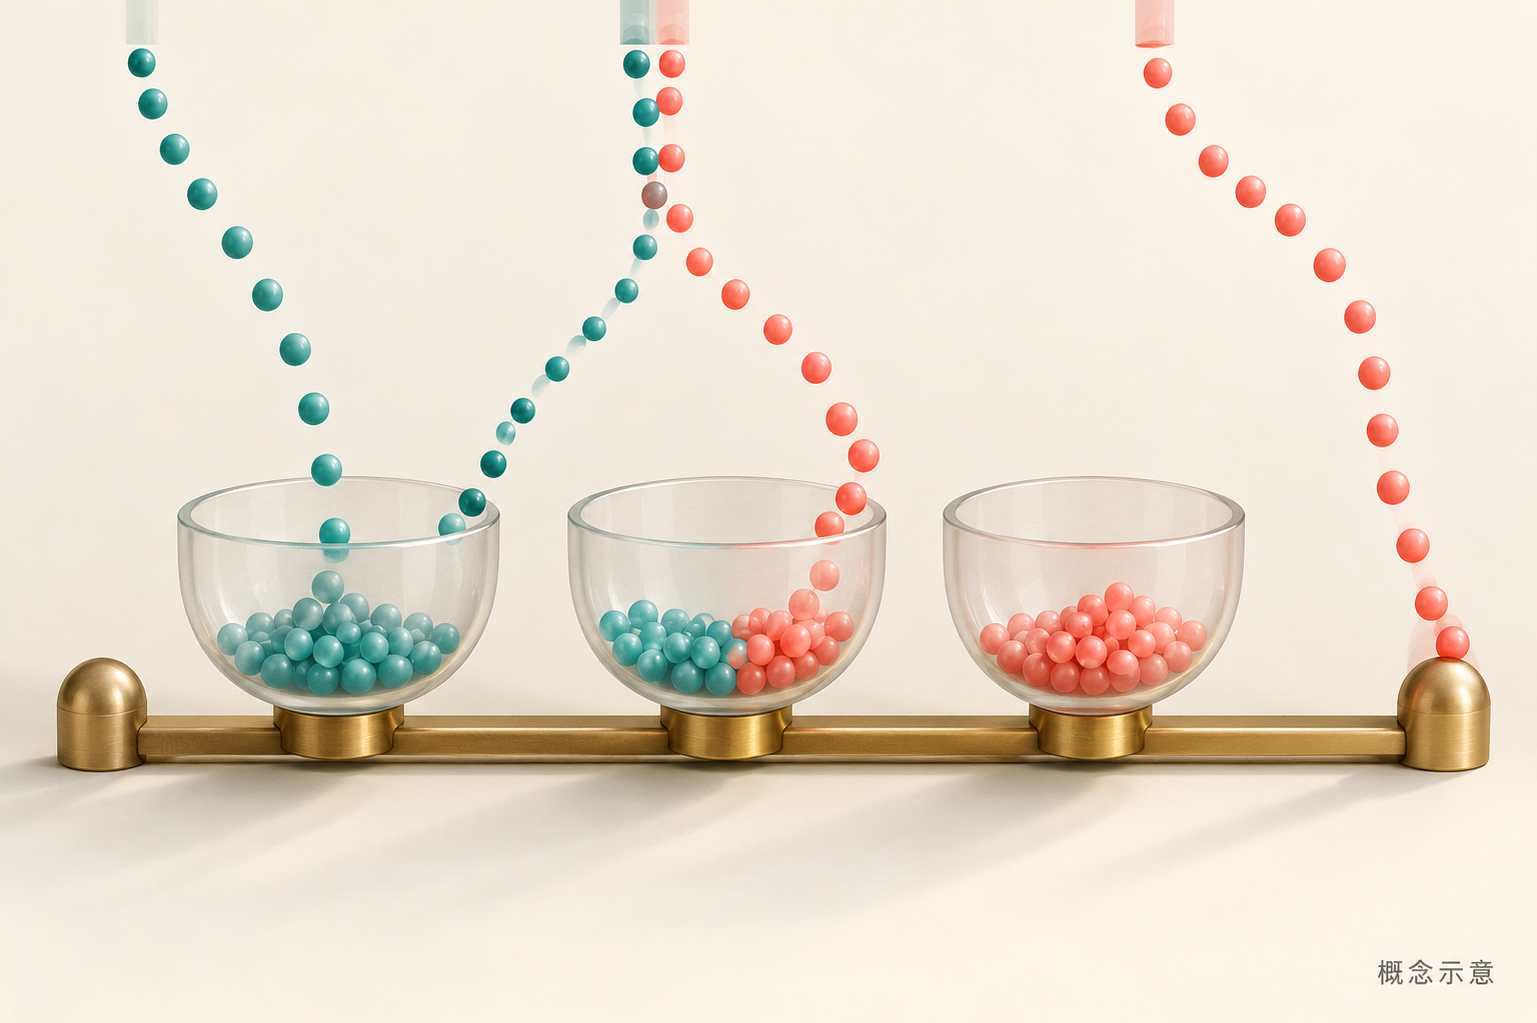
AI生成的概念示意图,展示概率流分到相邻容器及边界截断;不是实际软件、真实训练数据或按比例数值图。
三个支撑点已经足够看清完整流程
为了便于手算,这里使用三个原子z=(−1,0,1),而不是名称C51中常用的51个原子。它们的概率为p=(0.2,0.5,0.3),总和为1,原期望为0.1。固定某个下一动作的这份分布,再取即时奖励r=0.25、折扣γ=0.5。
变换后的三个位置为r+γz,即−0.25、0.25、0.75,概率仍分别为0.2、0.5、0.3。注意先移动的是横轴位置,不能直接把概率乘以折扣;概率总量没有因为未来奖励打折而减少。
对−0.25上的质量0.2,按距离分到−1与0:左侧得到0.2×0.25=0.05,右侧得到0.2×0.75=0.15。对0.25上的质量0.5,分到0与1,分别为0.375和0.125。对0.75上的质量0.3,分到0与1,分别为0.075和0.225。
把相同格点上的贡献相加,最终得到m=(0.05,0.60,0.35)。三个数之和为1,期望为−0.05+0.35=0.30,恰好等于0.25+0.5×0.1。这个等式是所有落点都在范围内、采用相邻线性分配时的一阶矩性质,不是任意量化方法都具有的保证。
期望相同,不表示整份分布相同
变换后、投影前的二阶矩为0.2×0.0625+0.5×0.0625+0.3×0.5625=0.2125。减去均值平方0.09,方差为0.1225。投影后的二阶矩为0.05+0.35=0.4,方差变成0.31。
这次网格化增加了离散程度。直观上,一个原本确定落在两个格点之间的原子,被替换成两个不同回报值上的随机质量;它们的加权中心不变,二阶矩却更大。把“保持均值”写成“保留了全部回报不确定性”会夸大这一步的精度。
更极端的测试是只有一个原子位于0.5、质量为1。投回0和1后,各得0.5:原分布方差为0,投影后方差为0.25。网格越粗,这种表示误差可能越明显,因此选择支撑点数量不能只看张量尺寸。
越界以后,一阶矩也不再保持
保持原概率和γ=0.5,把奖励改成r=1。变换后的位置为0.5、1、1.5,原本的目标期望为1.05。但固定范围仍只有[−1,1],1.5必须先被截到1。随后投影结果为(0,0.1,0.9),期望为0.9。
差掉的0.15,恰好来自0.3质量从1.5被压回1,损失0.3×0.5。概率没有消失,均值却因支撑范围不足发生偏移。训练日志只检查概率和为1,无法发现这种长期贴边的回报截断。
实际选择上下界时,要结合奖励尺度、折扣与任务时长。在有界奖励和无限折扣回报条件下,可以先推导粗略的理论范围;但改变奖励裁剪、回合规则或折扣以后,旧支撑点未必继续合适。本文没有替任何环境给出通用的默认区间。
整数落点不能按两次零权重处理
实现通常先把目标位置换算成网格坐标b,再取l=floor(b)、u=ceil(b)。若b恰好为整数,l与u相等。机械地分别乘(u−b)和(b−l),两项都是零,会把这份质量完全丢掉。正确处理应把全部质量加到那个单一格点,或使用数学上等价、已覆盖该边界的实现。
终止转换尤其容易触发这个问题。若γ=0且奖励恰好为0,所有目标原子都落到中心0,输出必须是(0,1,0),而不是全零向量。奖励恰好位于上下界时也应作为单格点测试,不能只拿小数位置调通程序。
让AI协助实现时,先给它四条独立断言
第一条是非负与质量守恒;第二条是在无截断条件下比较投影均值与r+γE[Z];第三条是检查整数落点;第四条是用上述越界例明确允许均值改变,并核对改变数值。另写一个逐原子、逐邻居的慢速参考函数,再比较向量化实现,可以发现索引累计覆盖而非相加的错误。
最后要分清表示和决策。得到回报分布后,如果仍按期望最大的动作行动,并不会自动变成风险厌恶策略。投影只是分布学习链条中的一步;动作选择、目标网络、交叉熵训练与终止语义仍需分别验证。三个原子的教学实验足以查这些边界,却不能说明某个游戏上增加原子数量一定提升回报。
资料核对日期:2026年10月3日。数值均为原创教学设定,使用本地独立程序复算;未进行真实模型训练或生产性能测试。
参考资料
Bellemare等:A Distributional Perspective on Reinforcement Learning,第4节



