

Python untokenize 往返边界:词元完全相同,为什么源码空格和返回类型仍然变了
写源码改写器时,先切成词元、再原样拼回,看上去应该什么都没改。但版本控制却出现一堆空格差异,写文件时还可能因bytes和str类型不一致而报错。问题在于词元往返和字节往返是两份不同契约:前者保住语言片段及其顺序,后者还要求每个空白字符和编码字节都不变。
本文在Linux、Python 3.12.14中使用固定样本实跑。官方文档核验于2026年10月3日;在线文档显示的补丁版本可能不同于这里记录的实际解释器。程序不访问真实业务数据,也不连接远程服务。
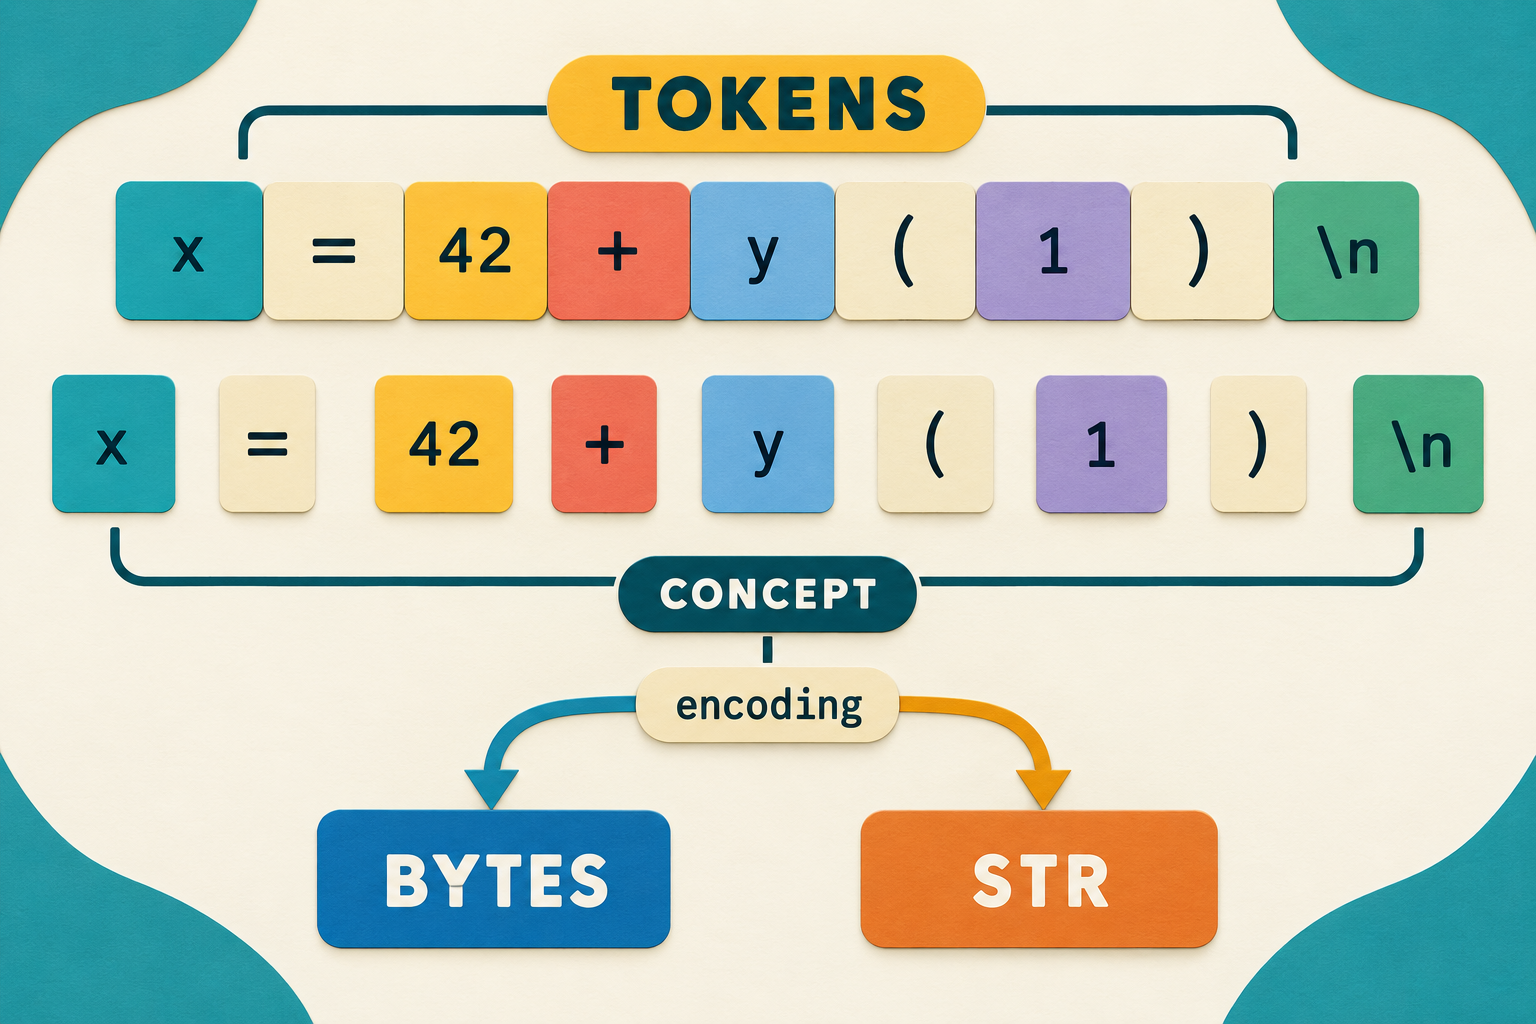
AI模型生成的原创概念图:两排词元保持相同内容但间距不同,编码标记把返回结果分为字节和字符串;用于解释程序模型,不是软件截图、测试截图或实拍照片,精确行为以程序和实际输出为准。
完整程序与实际输出
将下面程序保存为tech12.py,执行python tech12.py。预期出现的异常已在例子里处理;退出码为零才表示本次演示正常完成。
from io import BytesIO, StringIO
from tokenize import tokenize, generate_tokens, untokenize

source = b"total=1+2  # note\n"
pairs = [(item.type, item.string) for item in tokenize(BytesIO(source).readline)]
rebuilt = untokenize(pairs)
again = [(item.type, item.string) for item in tokenize(BytesIO(rebuilt).readline)]
print("original=", repr(source))
print("rebuilt=", repr(rebuilt))
print("same_bytes=", source == rebuilt)
print("same_tokens=", pairs == again)
print("with_encoding=", type(rebuilt).__name__)

text_pairs = [(item.type, item.string)
              for item in generate_tokens(StringIO(source.decode("utf-8")).readline)]
text_result = untokenize(text_pairs)
print("without_encoding=", type(text_result).__name__)
compile(rebuilt, "<roundtrip>", "exec")
print("compile=ok")
本次实际标准输出:
original= b'total=1+2  # note\n'
rebuilt= b'total =1 +2 # note\n'
same_bytes= False
same_tokens= True
with_encoding= bytes
without_encoding= str
compile=ok
先决定到底要比较哪一种相等
原始输入是total=1+2,等号和加号两侧没有空格,注释前留了两个空格。程序主动把词元对象缩减成类型和字符串二元组,再交给untokenize。因此返回值没有义务复现原列位置;本次输出在一些运算符周围增加空格,同时改变注释前的间距。same_bytes为假是预期观察,不是数据必然损坏的证明。
接着程序重新分词,再比较两份二元组序列,same_tokens为真。这个比较对应官方承诺的核心层次:词元类型和词元字符串往返相同。若你的工具只要求在指定词元上做安全替换,这一层很有用;若工具目标是最小差异补丁,光有这层保证就不够,需要另外保留原文本位置与未改动片段。
注释也是需要关注的源码信息
本例使用tokenize而不是只构建抽象语法树,一个原因是词元流里包含注释信息。程序保留了注释词元,因此文字note没有被删掉;但是注释前的空格不因此得到逐字节保留。审查输出时应把“注释还在”“注释位置合适”和“原始排版不变”分开验收,不能只做一次执行结果比较。
更复杂的源文件还可能含多行字符串、显式续行、缩进层级和非ASCII内容。一个简单样本通过,不足以证明任意源码改写器都安全。建议先对原程序建词元清单,再明确哪些词元允许变化,最后用样本覆盖不同换行与缩进形态。修改数字或名称时也要注意作用域和语义,词法正确不代表业务行为保持不变。
ENCODING词元决定返回数据的类型
字节入口tokenize会产出ENCODING词元,本例保留它,所以untokenize返回bytes。第二条路径把原文解码为字符串,再使用generate_tokens;这一入口不产生ENCODING词元,返回结果因此是str。两条路径的区别不只是读取参数类型,它还一路影响最终写文件时应使用二进制模式还是文本模式。
处理已有源文件时,应提前规划编码与换行的保存策略。不要看到结果是bytes就随手调用str,那会得到带b前缀的表示形式,而不是解码后的源码;也不要对str重复编码再用文本流写入。把输入字节、Unicode字符串、词元序列和输出字节四个阶段画清楚,类型检查通常就能在边界处阻止混用。
编译验证是必要的下一关,但不是最终保证
程序最后只编译重建源码,不执行它;compile=ok证明当前样本在该解释器中仍然满足语法要求。实际改写工具可以在写入前做这一步,并把结果输出到独立文件,再检查差异和运行原项目测试。对未知来源代码,仅做词法或语法分析不应成为允许执行它的理由。
本次具体空格布局属于Python 3.12.14的观察结果,不宜写成所有版本永远固定的格式化规范。如果需要统一代码样式,应选择明确的格式化策略;如果需要精确保留排版,则选支持保留源码细节的表示方式或基于原片段的补丁。工具名称里有“逆操作”,并不等于它承诺恢复所有输入字节。
验证记录与参考资料
本次完整程序退出码为0,标准错误为空。具体空格布局属于当前解释器的观察结果;词元往返相同不等于原始字节和排版逐字恢复。



