

TCP 消息分帧实战:用 Python 长度前缀解析器处理拆包与合并读取
客户端发送两条消息,服务端一次 recv 收到一条半,通常是应用对 TCP 的边界作了错误假设。TCP 提供有序字节流,应用必须自己定义消息结束的位置。把一次 send 对应到一次 recv,在本机测试中偶尔成立,也不足以成为协议约定。
AI生成概念示意图,非真实界面
先把线上的格式写清楚
本例规定每帧为四字节无符号长度,随后跟随指定数量的负载字节。长度只计算负载,不包含消息头;字节序固定为网络字节序,也就是大端。Python struct 的 !I 对应这个四字节格式。中文需先编码,再对字节求长度,不能拿字符串字符数填写消息头。
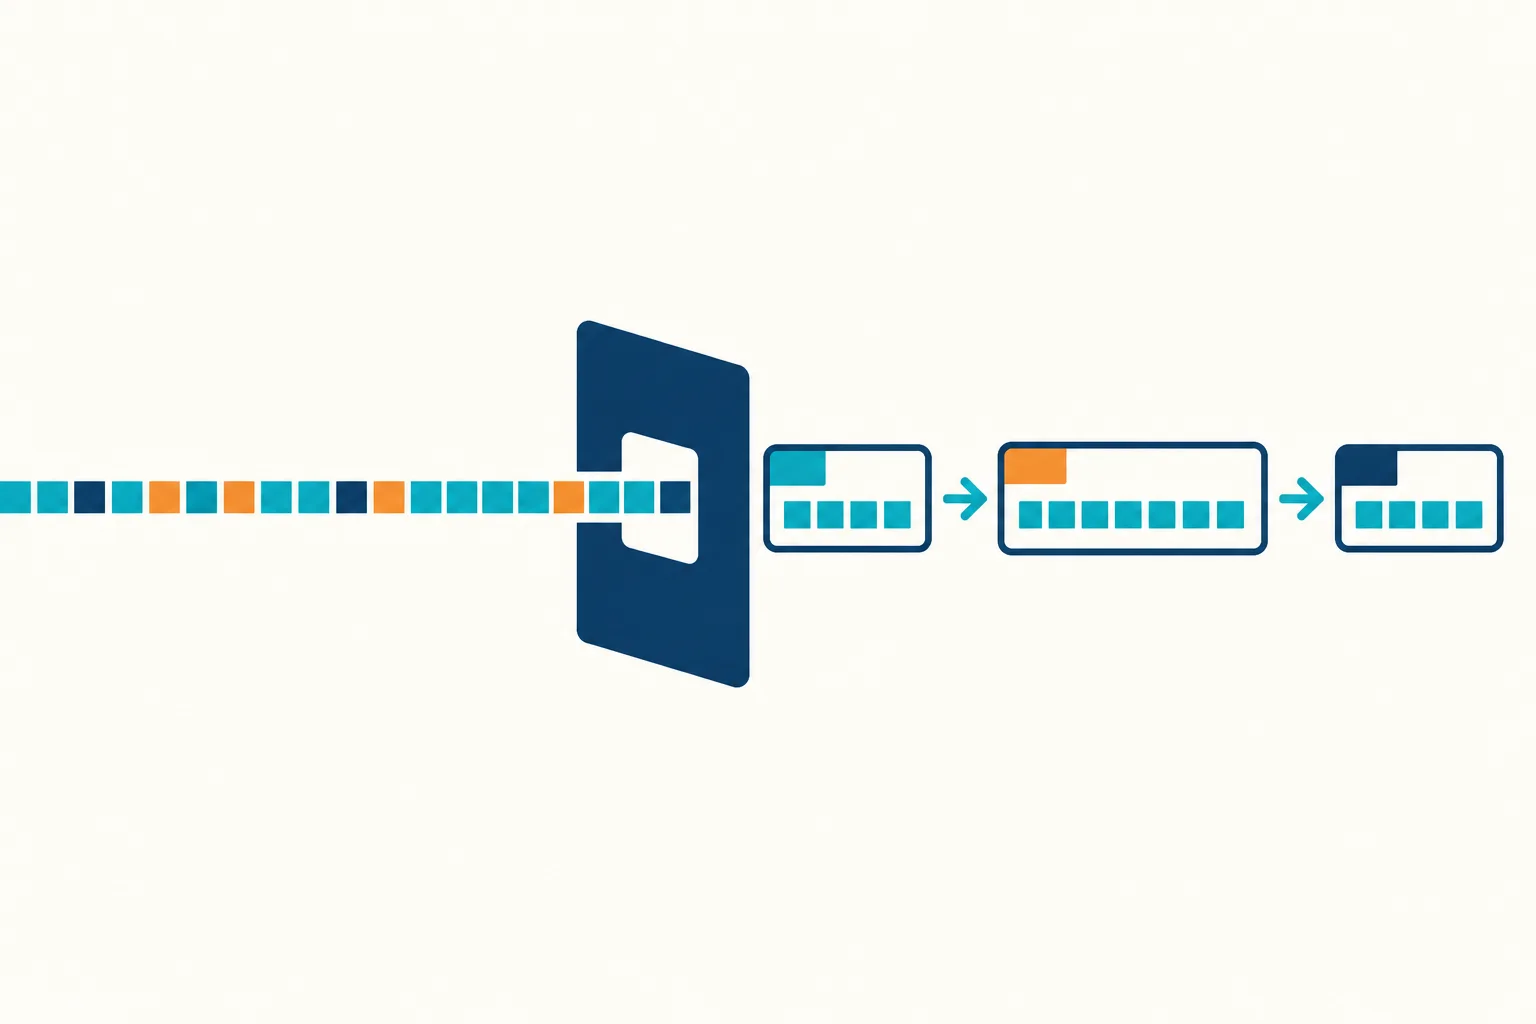
为了把协议错误与网络环境分开,实验只在内存中生成确定性字节块,不连接任何外部地址。第一、第二块连消息头都收不全,第三块刚好解析出第一帧,第四块同时完成后面两帧。这样的输入能稳定覆盖边界,比反复调整网络延迟等待故障出现更容易验收。
缓存未完成部分,循环取出完整帧
把完整代码保存为 frames-demo.py,用 Python 3 执行。feed 先追加新字节,头不足四字节就等待;头完整后先检查长度上限,负载不足继续等待。每取出一帧就移除对应字节,再查看缓冲区是否还有下一帧。这里最大负载设为 64 字节,仅用于小型演示。
import struct

MAX_FRAME = 64

def encode_frame(payload):
    if len(payload) > MAX_FRAME:
        raise ValueError('frame too large')
    return struct.pack('!I', len(payload)) + payload

class FrameParser:
    def __init__(self):
        self.buffer = bytearray()

    def feed(self, chunk):
        self.buffer.extend(chunk)
        messages = []
        while len(self.buffer) >= 4:
            size = struct.unpack('!I', self.buffer[:4])[0]
            if size > MAX_FRAME:
                raise ValueError('frame too large')
            end = 4 + size
            if len(self.buffer) < end:
                break
            messages.append(bytes(self.buffer[4:end]))
            del self.buffer[:end]
        return messages

    def finish(self):
        if self.buffer:
            raise ValueError('truncated frame')

payloads = [b'hi', '中文'.encode('utf-8'), b'']
wire = b''.join(encode_frame(item) for item in payloads)
parser = FrameParser()
chunks = [wire[:1], wire[1:3], wire[3:8], wire[8:]]
received = []
counts = []
for chunk in chunks:
    batch = parser.feed(chunk)
    counts.append(len(batch))
    received.extend(batch)
parser.finish()
assert received == payloads
assert counts == [0, 0, 1, 2]
print('frames per chunk:', counts)
print('messages:', [item.decode('utf-8') for item in received])

for cut in range(len(wire) + 1):
    parser = FrameParser()
    result = parser.feed(wire[:cut]) + parser.feed(wire[cut:])
    parser.finish()
    assert result == payloads
print('all split positions:', len(wire) + 1)

for label, data in [('partial header', wire[:2]),
                    ('partial payload', wire[:5]),
                    ('oversized', struct.pack('!I', MAX_FRAME + 1))]:
    parser = FrameParser()
    try:
        parser.feed(data)
        parser.finish()
    except ValueError as error:
        print(label + ':', error)
    else:
        raise AssertionError(label + ' should fail')
检查成功路径,也检查结束位置
frames per chunk 应为 [0, 0, 1, 2],messages 应依次为 hi、中文和空字符串。空负载仍有四字节消息头,是本协议允许的合法消息。解析器用缓冲区长度判断是否有头,不用负载内容的真假判断“有没有消息”,因此不会把空消息悄悄丢掉。
样本线上数据共二十字节,all split positions 应为 21,表示遍历所有两段切法后仍得到同样三帧。最后三行分别报告 partial header: truncated frame、partial payload: truncated frame、oversized: frame too large,说明消息头和负载都能在结束时接受完整性检查。
真实连接中,收到非空字节就交给对应连接的解析器;recv 返回空字节表示接收方向到达 EOF,此时调用 finish。超时表示在期限内没有等到数据,不能直接当作一条消息结束。如果缓冲区仍有半帧,应用应按协议报告截断,而不是把剩余内容强行交给业务代码。
长度限制之外,还有资源限制
消息头来自对端,不能先按它声明的巨大长度分配内存,再检查是否合法。本例尽早拒绝超过上限的帧;遇到这类错误应丢弃解析器并结束对应会话,避免继续解释已经失去可信边界的流。上限需要根据业务负载决定,不能直接把演示值照搬到生产服务。
最大帧长也不能限制所有内存占用:一次传入的块本身可能很大,调用者也可能无限积累已解析消息。接入 socket 时还需限制读取块大小、排队长度和等待时间,并让下游逐步消费。本例删除 bytearray 前部便于教学,大流量场景可考虑读取游标,减少反复搬移数据。
手动验收可改成逐字节喂入,再把所有帧一次喂入,两次结果都应相同;把中文负载换成恰好 64 字节,再试 65 字节,检查边界是否明确。分帧成功只证明字节边界被识别,负载中的文本编码、字段格式和业务权限仍应在后续阶段分别验证。



