

SQLite UNION 合并结果:两笔内容相同的记录,为什么只剩下一笔
先确定重复行是否代表同一件事
把两个站点的库存动作放到一份报表里,看起来只需要拼接查询。可是两笔独立动作可能恰好具有相同商品和数量。如果查询只投影这两列,再用 UNION 合并,它们就可能被压成一行。报表仍能正常生成,合计却已经少算,之后再加求和函数也无法恢复被丢掉的记录。
合并前要先说清每一行表示什么:是一笔发生过的动作,还是一种不重复的商品数量组合。前者通常需要保留每次出现,后者才需要整行去重。选择操作符应当跟随这个含义,不能只根据某个写法更短,或者一次查询看起来更快来决定。
建立两份故意相同的输入
下面使用 Python 标准库建立内存数据库,不需要数据库服务器,也不会写入业务文件。本文在 Python 三点十二、SQLite 三点五十三点一验证。东站有三笔动作,其中两笔完全相同;西站有两笔,其中一笔又与东站相同。这个安排能够同时检查单一来源内部与不同来源之间的重复。
代码对同一组输入运行两种合并,再增加来源列观察结果。最后补上空值和文本数字的边界。所有需要展示稳定顺序的查询都在最终结果上明确排序,断言也只比较有完整排序条件的多行结果,避免把偶然输出顺序写成程序约定。
AI概念配图,非真实界面
import sqlite3

db = sqlite3.connect(':memory:')
try:
    db.executescript("""
        CREATE TABLE east(seq INTEGER, sku TEXT, qty INTEGER);
        CREATE TABLE west(seq INTEGER, sku TEXT, qty INTEGER);
        INSERT INTO east VALUES (1, 'A', 2), (2, 'A', 2), (3, 'B', 1);
        INSERT INTO west VALUES (1, 'A', 2), (2, 'C', 3);
    """)
    all_rows = db.execute("""
        SELECT 'east' AS source, seq, sku, qty FROM east
        UNION ALL
        SELECT 'west', seq, sku, qty FROM west
        ORDER BY source, sku, seq
    """).fetchall()
    unique_rows = db.execute("""
        SELECT sku, qty FROM east
        UNION
        SELECT sku, qty FROM west
        ORDER BY sku, qty
    """).fetchall()
    tagged_rows = db.execute("""
        SELECT 'east' AS source, sku, qty FROM east
        UNION
        SELECT 'west', sku, qty FROM west
        ORDER BY source, sku, qty
    """).fetchall()
    assert len(all_rows) == 5
    assert sum(row[3] for row in all_rows) == 10
    assert unique_rows == [('A', 2), ('B', 1), ('C', 3)]
    assert sum(row[1] for row in unique_rows) == 6
    assert len(tagged_rows) == 4
    assert db.execute('SELECT NULL UNION SELECT NULL').fetchall() == [(None,)]
    assert db.execute('SELECT NULL UNION ALL SELECT NULL').fetchall() == [(None,), (None,)]
    typed = db.execute("SELECT 1 AS value UNION SELECT '1' ORDER BY value").fetchall()
    assert typed == [(1,), ('1',)]
    print('all rows / sum:', len(all_rows), sum(row[3] for row in all_rows))
    print('unique rows / sum:', len(unique_rows), sum(row[1] for row in unique_rows))
    print('rows with source:', len(tagged_rows))
    print('type and NULL checks passed')
finally:
    db.close()
看数量,再看为什么会少
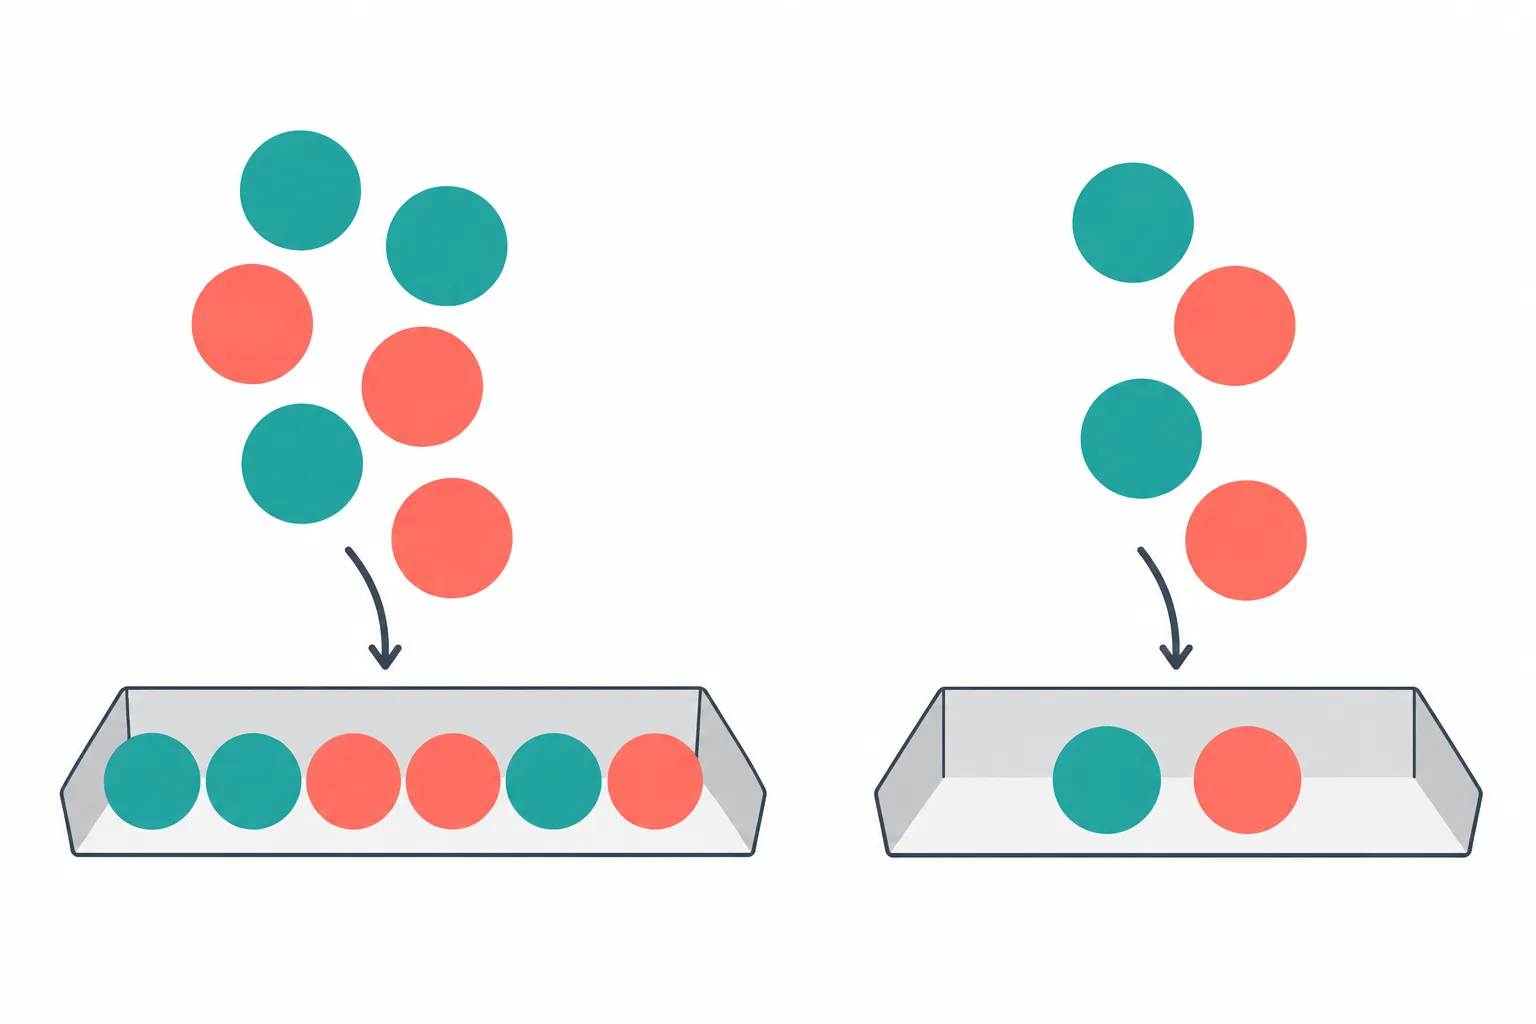
输出显示保留全部记录时有五行,数量之和为十;整行去重后只剩三行,合计变成六。去重不关心记录来自哪个文件,也不知道两次相同动作是否真的重复提交。它只比较查询输出的各列,因此在选择列的那一刻,能够区分业务事件的信息就可能已经被舍弃。
增加来源列后,东站与西站的相同内容能够区分,但东站内部那两笔仍然合并,最终只有四行。来源标签有助于追溯,却不是事件唯一编号。若目标是删除真正重复的业务事件,应先确定可靠的业务键与冲突规则,再围绕那个键处理,不能把整行相同直接解释为同一事件。
列数相同,还要保证每一列的含义相同
复合查询要求两边返回相同列数,列按照位置对应。左边的第二列是数量,右边的第二列却是单价,即使某些值能够被存放在同一结果列里,业务上仍然错位。应在两个分支中显式列出字段,必要时统一单位与转换规则,再做合并和汇总。
空值例子只说明复合查询的去重规则:两个空值会被当作重复值。它不是普通条件表达式比较空值的规则。另一个例子保留整数一和文本字符一,说明不要指望合并顺便替你完成类型清洗。导入数据时应先核对来源类型,再决定是否显式转换,避免无效文本被转换成看似合理的数值。
排序与性能在语义确定之后再处理
UNION ALL 表达的是保留所有行,不能据此约定报表一定先显示东站再显示西站。示例把排序放在最外层,并包含来源、商品与序号;其中序号只用于本次展示,不冒充跨系统的业务键。真实分页还需要稳定且足以区分行的排序条件。
需要消除重复值时,数据库必须完成相关比较,可能带来额外工作;具体开销仍取决于查询计划和数据分布。不能为了省一次去重就无条件改成保留全部,也不能为了“保险”在所有合并处都加去重。先用能手算的小样本确认行数和合计,再用实际规模的数据检查资源消耗。
验收时至少保留三类样本:来源内部相同、来源之间相同,以及内容相同但事件标识不同。把预期行数写进测试,并分别检查合并后的行与汇总值。这样能在报表还很小的时候发现信息损失,不必等业务总量对不上再反查整条数据链路。



