

Python quantiles 分位数:同一组数据,inclusive 与 exclusive 为什么给出不同切点
先固定方法,再比较数字
比较两份任务耗时报告时,平均值完全相同,四分位数却不同,不一定是谁算错了。有限数据的分位数需要约定每个观测值对应的位置,再计算中间切点。Python 标准库 statistics.quantiles 提供 inclusive 和 exclusive 两种方法,默认使用后者。只记录“计算了分位数”,还不足以让别人复现结果。
本文在 Python 3.12.14 上验证,用十、二十、三十、四十、五十这五个虚构秒数演示算法。数据没有实际业务含义,也不用于估计某个系统的真实响应表现。先选容易手算的小数组,是为了看清位置计算,而不是证明五条记录足以形成稳定的高分位指标。
两种端点约定怎样移动切点
inclusive 把排序后最小值放在百分之零,最大值放在百分之百。五个数对应零、二十五、五十、七十五和一百,因此四分位切点正好是二十、三十、四十。exclusive 的位置按序号除以样本量加一计算,同样五个数被放到六分之一至六分之五,中间位置需要插值。
以第一个四分位点为例,exclusive 的百分之二十五落在十与二十之间的正中间,得到十五;第三个切点同理得到四十五。两种方法的中位数都是三十,这并不能证明其他切点也相同。quantiles 的 n 表示等概率区间数,返回的是 n 减一个切点,并不是把原数组直接切成 n 个列表。
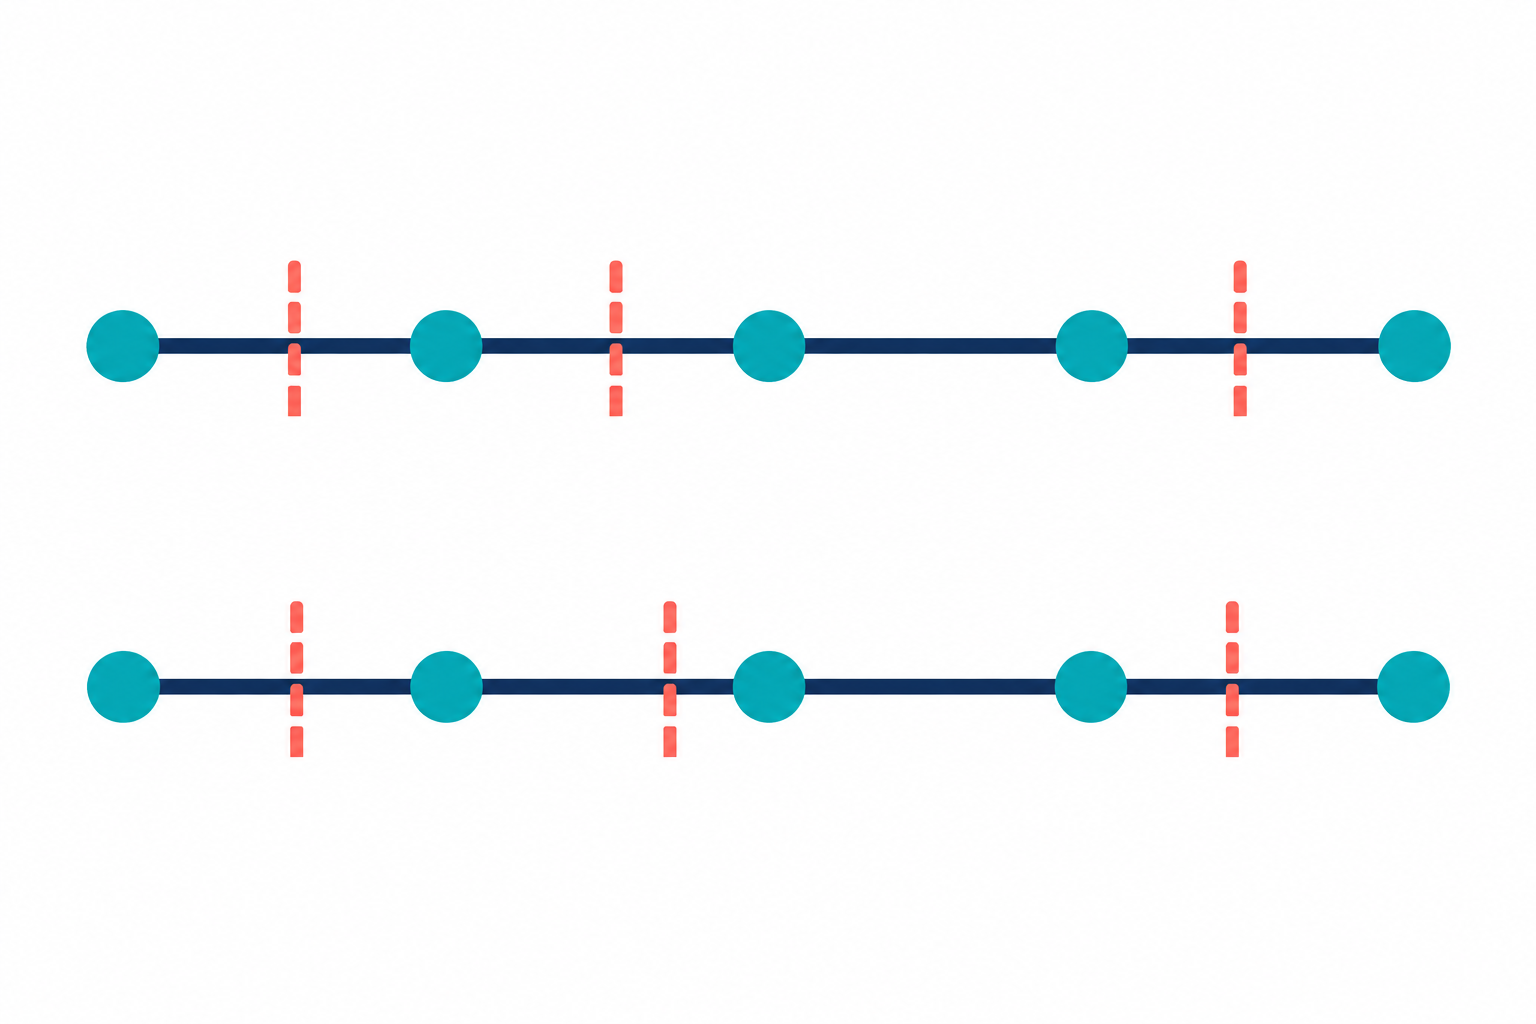
AI概念示意图:同一组观测点在不同位置约定下得到不同切点,图中位置仅作概念说明。图片用于解释概念,不是运行截图。
from statistics import quantiles
from math import isfinite

data = [10, 20, 30, 40, 50]
assert len(data) >= 2 and all(isfinite(x) for x in data)
exclusive = quantiles(data, n=4, method="exclusive")
inclusive = quantiles(data, n=4, method="inclusive")
assert exclusive == [15.0, 30.0, 45.0]
assert inclusive == [20.0, 30.0, 40.0]
print("exclusive:", exclusive)
print("inclusive:", inclusive)
assert quantiles(reversed(data), n=4, method="inclusive") == inclusive

p90_ex = quantiles(data, n=10, method="exclusive")[-1]
p90_in = quantiles(data, n=10, method="inclusive")[-1]
assert p90_ex == 54.0 and p90_in == 46.0
print("p90:", p90_ex, p90_in)
print("maximum observation:", max(data))
超过最大观测值,不等于样本里有那一条
运行后先得到十五、三十、四十五,以及二十、三十、四十两组结果。反转输入顺序的断言仍通过,因为函数会按数值位置计算。后半段故意把区间数改为十,观察百分之九十切点:exclusive 给出五十四,inclusive 给出四十六,而实际最大观测值只有五十。
五十四来自当前方法在小样本上的外推,不能描述成“有一次任务耗时五十四秒”。也不要发现超出范围就随手截成最大值,然后仍沿用原来的方法名称。若需要的是实际观测值或固定比例位置处的一条记录,应另行定义选择规则,并给它一个能区分插值分位数的名称。
让指标口径能够重算
官方文档把 exclusive 用于来自更大总体、可能尚未观察到两端极值的样本;inclusive 用于描述总体数据,或已包含总体极值的数据。实际团队还可能有既定的指标标准,应该先对齐口径,而不是从两个答案里选一个更符合预期的。记录方法、样本量、时间范围、单位和缺失值处理,才足以进行跨工具比较。
输入中的 NaN 可能让排序和统计结果出乎意料,正式计算前应按明确规则拒绝或处理它,而非静默丢掉不喜欢的数据。这个小脚本仅接受预设有限值,并对关键结果作断言。要分析真实高分位表现,还需更多代表性数据;把 n 调大只增加切点数量,并不会凭空增加观测信息或提高可信度。



