

SQLite FTS5 搜索边界:短语、前缀与中文连续文字怎样变成不同的匹配
全文搜索不是把输入当成一个子串
给资料库加上 MATCH 查询后,输入两个词可能命中顺序颠倒的句子,输入一段中文里的两个字却找不到。先不要急着扩大索引或调整排序:全文搜索先把内容拆成词元,再解释查询表达式,结果由这两层共同决定。要理解命中范围,最有效的起点是一组结果已知的小样本。
下面在 Python 3.12.14、SQLite 3.53.1 上验证,运行环境已启用 FTS5。把代码保存为 demo.py 执行即可,数据库只在内存中存在。创建虚拟表若提示没有 fts5 模块,说明当前 SQLite 构建缺少该能力,应先核对实际连接所用版本和编译配置,不是修改搜索词就能解决。
六条记录分别改变一个条件
前三条分别把 red、green 相邻排列、隔开排列、倒序排列;第四条只包含 greenhouse。第五条是连续的中文教程,第六条在中文和教程之间插入空格。所有查询按 rowid 排序,保证打印结果便于对照;这个顺序只是实验编号顺序,不代表相关性排名。
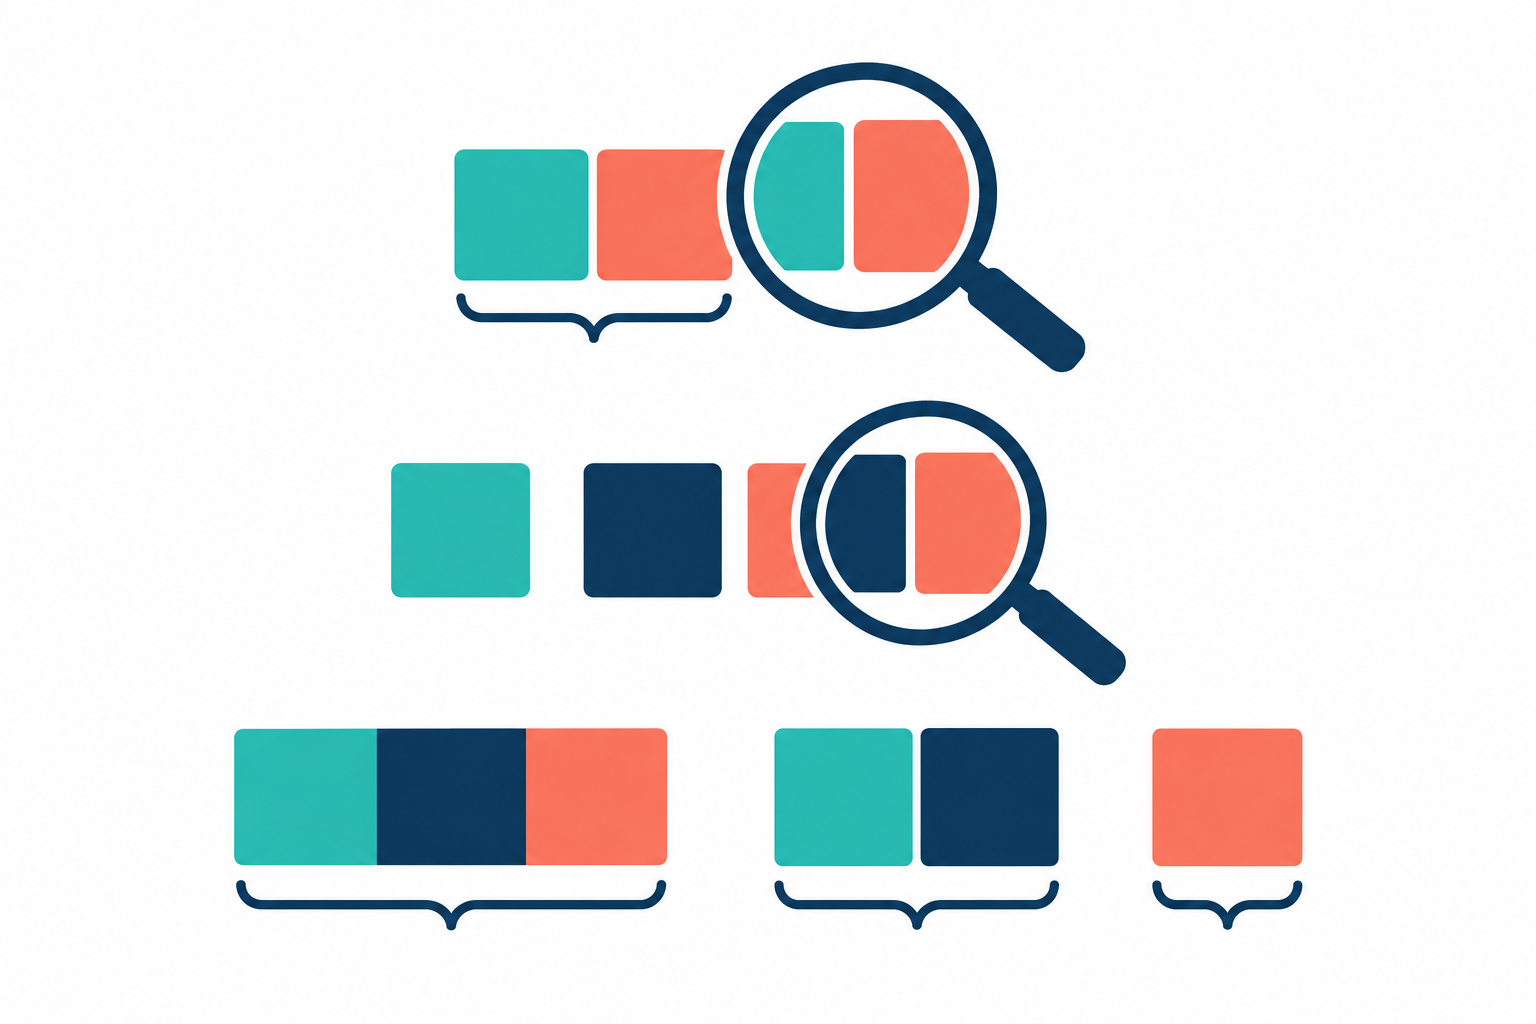
AI概念示意图:相邻词块、被隔开的词块与连续长块形成不同匹配条件。图片只表达词元关系,不是搜索结果截图。
import sqlite3

connection = sqlite3.connect(":memory:")
try:
    connection.execute(
        "CREATE VIRTUAL TABLE notes USING fts5(body, tokenize='unicode61')")
    texts = ["red green", "red blue green", "green red", "greenhouse",
             "中文教程", "中文 教程"]
    connection.executemany("INSERT INTO notes(body) VALUES(?)",
                           [(text,) for text in texts])
    cases = [
        ("red green", [1, 2, 3]),
        ('"red green"', [1]),
        ("green*", [1, 2, 3, 4]),
        ('"green*"', [1, 2, 3]),
        ("中文", [6]),
        ("教程", [6]),
        ("中文教程", [5]),
    ]
    for query, expected in cases:
        actual = [row[0] for row in connection.execute(
            "SELECT rowid FROM notes WHERE notes MATCH ? ORDER BY rowid",
            (query,))]
        assert actual == expected, (query, actual)
        print(repr(query), "->", actual)
finally:
    connection.close()
同样两个单词,短语约束更严格
red green 命中一、二、三号,因为这里空格分开的查询项按隐式 AND 组合,只要求都出现。带双引号的 "red green" 只命中一号,因为它要求分词后的相邻顺序。这个短语条件仍针对词元,不是要求原文每个空白或标点逐字一致。先理解这一点,才能决定搜索框要提供什么含义。
green* 命中一到四号,星号把 green 变为前缀条件,所以 greenhouse 也通过。把星号放进双引号,变为 "green*",本例只命中一到三号:星号交给 unicode61 处理后不再是查询层的前缀操作符。查询语法引号与 Python 字符串引号分属不同层次,例子把两者完整保留,便于直接比较。
支持Unicode,不代表自动理解中文词界
中文和教程分别只命中六号,完整的中文教程只命中五号。使用此处的默认 unicode61 规则时,连续汉字被视为连续词元字符,示例中的四个字形成一个词元;它不会按语义自行拆出两个词。加入空格能改变这个样本的词界,但不应因此给所有中文原文盲目插空格。真实项目需要按检索目标选择预分词或合适的分词器,并让文档与查询处理保持一致。
SQL 参数绑定防止输入改变外围 SQL,却不会把 MATCH 参数里的搜索语法取消掉。若产品只接受普通文字,应明确构造什么查询表达式,并为引号、空输入和特殊符号安排验证。这个实验只使用固定查询,不是一段直接接收任意搜索框输入的完整方案。
不要拿六行数据推断百万篇文档的速度,也不要把前缀匹配当成任意位置的子串匹配。上线前可以把业务中容易混淆的词、连续中文、标点和大小写加入同一份预期结果表,先验收命中集合,再评价相关性与性能。这样即使将来更换分词配置,也能看见哪些旧查询的语义已经变化。



