

Python takewhile 的边界元素:前半段读完后,第一条正文为什么不见了
分隔位置已经被读取了一次
文本开头是注释,后面才是正文,用 takewhile 取出连续注释很自然。可如果随后继续遍历同一个输入迭代器,正文第一行可能已经丢失。判断一行“不再属于注释”必须先取到这一行;takewhile 用它决定结束,却不会把它放回数据源。
这个行为特别容易藏在小型日志解析器里:测试只核对注释列表正确,便误以为余下内容也一定完整。下面用 Python 3.12.14 对同一组五行数据做两次独立实验,分别检查前缀和剩余内容。保存为 demo.py 后运行 python demo.py,无需安装第三方包。
需要保留边界时,自己接住它
第一段直接使用 takewhile,随后把原迭代器转成列表,观察 title 到哪里去了。第二段 split_prefix 显式遍历:符合条件的行进入前缀列表,第一次不符合的行则用 chain 与尚未读取的输入串接。返回的剩余部分由这条边界行开头。
辅助函数没有重新扫描整个输入,也没有试图让任意迭代器倒退。它只暂存已收集的前缀,以及至多一条被提前读出的边界行。额外的三组断言覆盖空输入、全是前缀、第一条就是正文,防止解决常见例子后又漏掉两端条件。
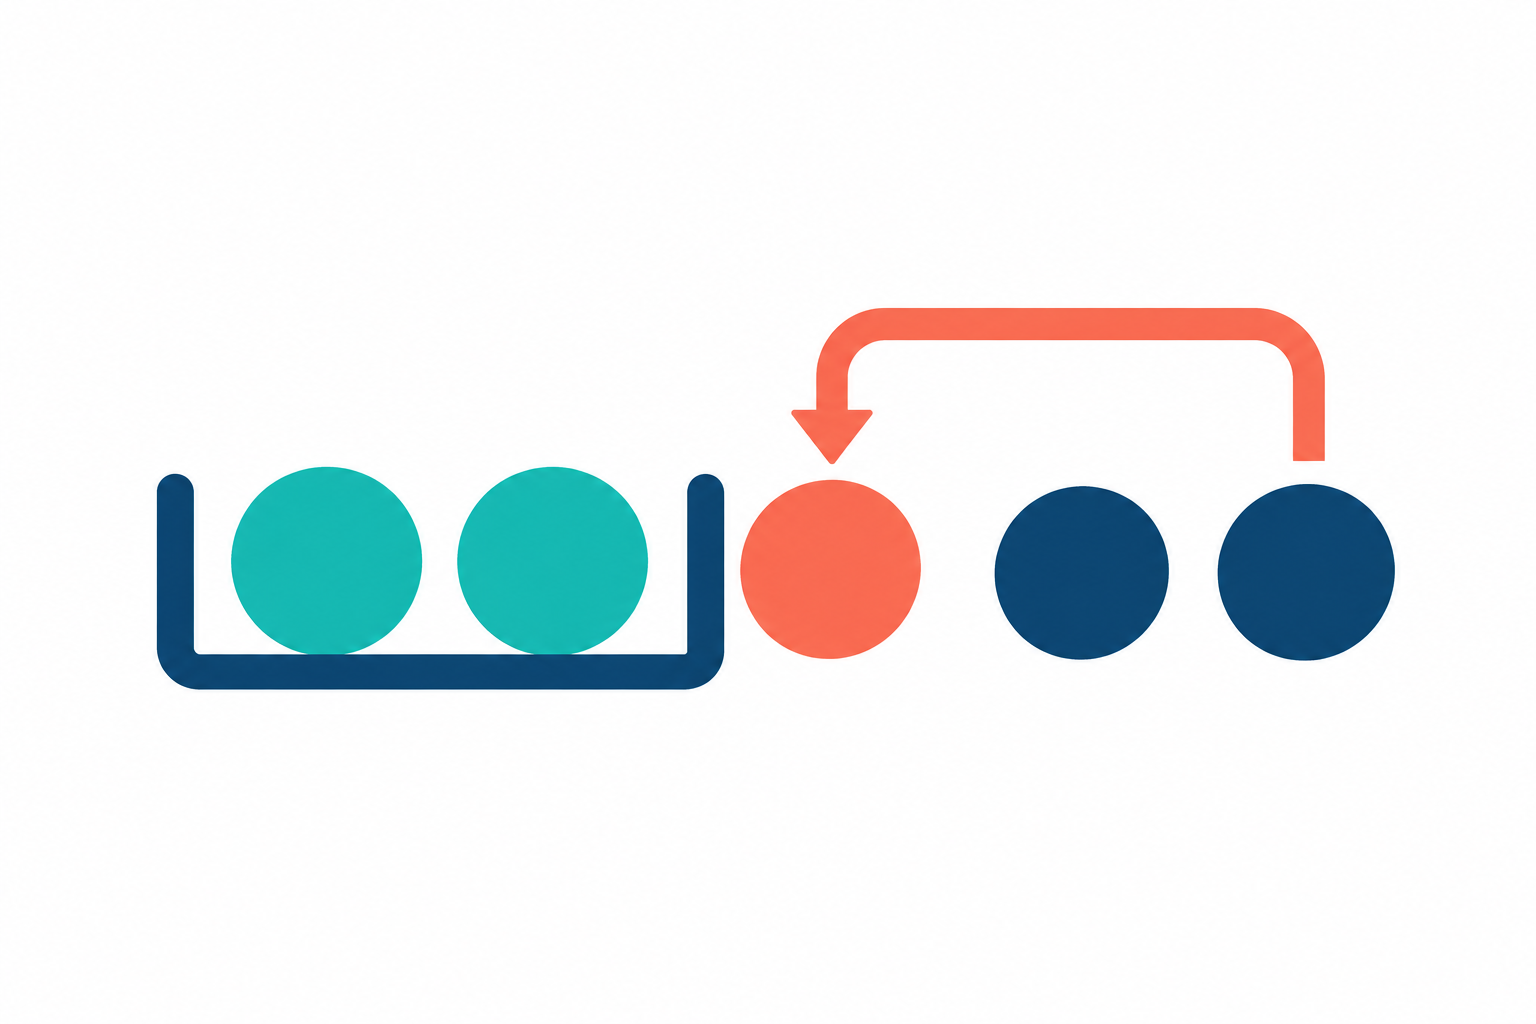
AI概念示意图:前缀托盘外的一条边界记录,需要由后续队列明确接住。图片只说明概念,不是运行截图。
from itertools import chain, takewhile

lines = ["#a", "#b", "title", "row1", "row2"]
source = iter(lines)
prefix = list(takewhile(lambda line: line.startswith("#"), source))
remainder = list(source)
assert prefix == ["#a", "#b"]
assert remainder == ["row1", "row2"]
print("broken:", prefix, remainder)

def split_prefix(iterable, predicate):
    source = iter(iterable)
    prefix = []
    for item in source:
        if not predicate(item):
            return prefix, chain((item,), source)
        prefix.append(item)
    return prefix, iter(())

prefix, rest = split_prefix(lines, lambda line: line.startswith("#"))
remainder = list(rest)
assert prefix == ["#a", "#b"]
assert remainder == ["title", "row1", "row2"]
print("fixed:", prefix, remainder)

for data, expected_prefix, expected_rest in [
    ([], [], []),
    (["#a"], ["#a"], []),
    (["title"], [], ["title"]),
]:
    prefix, rest = split_prefix(data, lambda line: line.startswith("#"))
    assert (prefix, list(rest)) == (expected_prefix, expected_rest)

assert list(takewhile(lambda n: n > 0, [1, 2, 0, 3])) == [1, 2]
print("boundary cases: 4 passed")
不要把前缀筛选当成全局过滤
broken 打印的前缀是两条注释,后续却从 row1 开始。title 既不在前缀里,也不在继续消费的列表里,说明它已经被判断操作取走。fixed 则让 title、row1、row2 全部出现在剩余部分,两个输出共同证明修正保住了数据边界。
takewhile 在第一个不合格项出现后就结束,不会越过它再寻找后面的合格项。本例另用 [1, 2, 0, 3] 验证这一点:结果只有 [1, 2],不会把末尾的 3 加回来。若需求是找出整个输入中所有合格元素,应采用过滤逻辑,而不是把它误当作同一种操作。
条件函数也应尽量只观察元素。为了找到停止处,它必然会检查首个不合格项;如果条件函数顺便写日志、计费或改变外部状态,这些动作不会因为元素未被返回就自动撤销。测试时可以单独记录条件函数见过哪些输入。
明确谁拥有剩下的迭代器
split_prefix 返回的 rest 与原输入共享同一个剩余迭代器。拿到 rest 后应只通过它继续消费,不能又从外部读取原输入,否则两个消费者会争抢后续元素。示例每次都从原始列表创建新迭代器,两个实验之间没有共享游标。
本实现会把整个前缀存成列表,因此适合有限且不太大的头部区域。如果输入可能永远满足条件,函数将一直等待分界并累积内存,需要额外设置行数或字节预算。这是解析协议的限制,不能仅靠换一个迭代工具解决。
生产测试除了检查提取到什么,还应检查留给下一阶段什么。只要处理流程被拆成头部和正文、元信息和记录,就值得给第一条边界数据一个明确归属,并用一个很短的样本证明它既不会丢,也不会重复。



