

SQLite instr 定位分隔符:零、空值和一基位置怎样决定拆分结果
一列备注按第一个冒号分成名称和内容,查询先用 instr 找位置,再交给 substr。普通样本没问题,缺少冒号的记录却可能被当成另一种合法拆分。原因是查找结果不仅是一串数字:它还包含“没找到”和“输入缺失”两种状态,必须先判断,再把有效位置用于截取。
先明确结果中的三种含义
instr 返回第一次出现的位置,从一开始计数;完全找不到时返回零,任一参数为 NULL 时返回 NULL。因此位置一表示就在开头,不能当成未找到。它也不会自动找到最后一个分隔符;如果正文自己含冒号,第一次出现之后的全部内容仍应保留下来。
下面保存为 demo.py,运行 python demo.py。六条合成记录覆盖中间、开头、末尾、缺失、空串和空值。查询先为查找结果取名,再分别输出状态和左右两段。只有位置大于零才做拆分,这样调用方可以区分空字段与根本没有成功识别的记录。
import sqlite3

db = sqlite3.connect(":memory:")
try:
    db.execute("CREATE TABLE sample(id INTEGER PRIMARY KEY, value TEXT)")
    db.executemany("INSERT INTO sample VALUES (?, ?)", [
        (1, "甲:乙:丙"), (2, ":首"), (3, "尾:"),
        (4, "没有分隔符"), (5, ""), (6, None),
    ])
    rows = db.execute("""
        WITH located AS (
            SELECT id, value, instr(value, ':') AS p FROM sample
        )
        SELECT id, p,
            CASE WHEN p IS NULL THEN 'null-input'
                 WHEN p = 0 THEN 'missing' ELSE 'found' END,
            CASE WHEN p > 0 THEN substr(value, 1, p - 1) END,
            CASE WHEN p > 0 THEN substr(value, p + 1) END
        FROM located ORDER BY id
    """).fetchall()
    assert rows == [
        (1, 2, "found", "甲", "乙:丙"),
        (2, 1, "found", "", "首"),
        (3, 2, "found", "尾", ""),
        (4, 0, "missing", None, None),
        (5, 0, "missing", None, None),
        (6, None, "null-input", None, None),
    ]
    for row in rows:
        print(row)
    text = "甲:乙"
    blob = text.encode("utf-8")
    assert db.execute("SELECT typeof(?), typeof(?)", (text, blob)).fetchone() == ("text", "blob")
    positions = db.execute("SELECT instr(?, ?), instr(?, ?)",
                           (text, ":", blob, b":")).fetchone()
    assert positions == (2, 4)
    suffixes = db.execute("SELECT substr(?, ?), substr(?, ?)",
                          (text, positions[0] + 1, blob, positions[1] + 1)).fetchone()
    assert suffixes == ("乙", "乙".encode("utf-8"))
    assert db.execute("SELECT instr(?, NULL)", (text,)).fetchone() == (None,)
    print("text/blob positions:", positions)
    print("matching representations: suffixes verified")
finally:
    db.close()
第一条得到左侧“甲”和右侧“乙:丙”;第二条左侧为空,第三条右侧为空,两者都属于 found。没有冒号与空字符串属于 missing,原值为空则属于 null-input。这些状态比一律返回两个空串更有用,后续校验可以准确指出输入缺失还是格式不符。
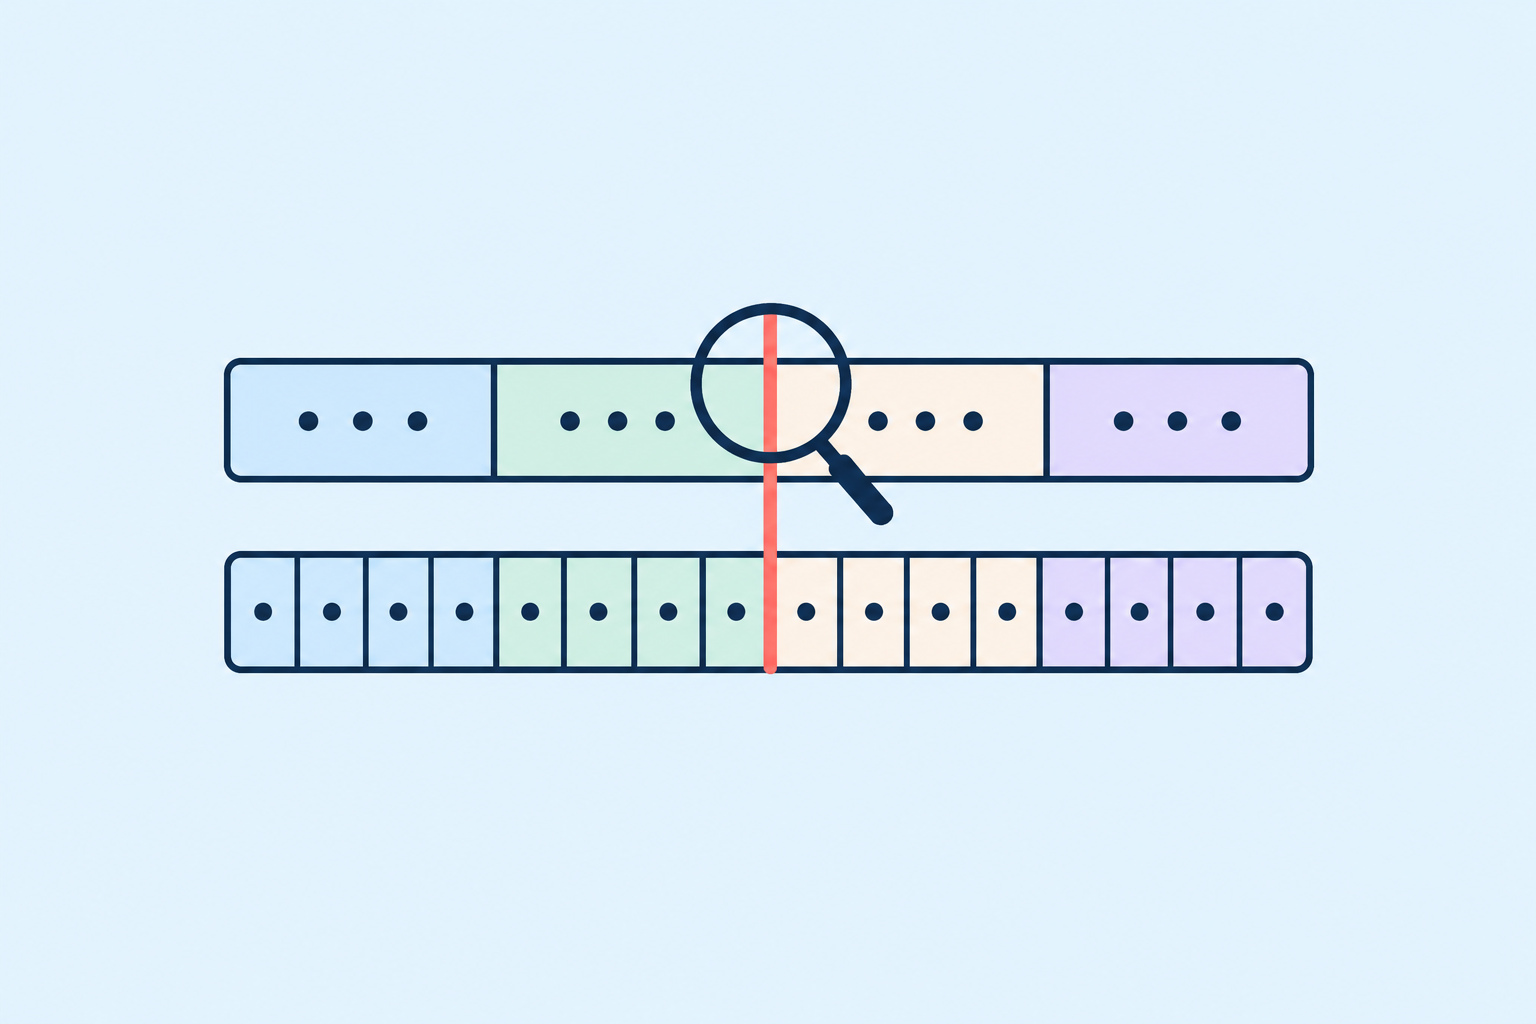
AI生成概念示意图:查找先确定目标出现的位置,位置需要和被搜索的文本或字节序列对应。
把一基位置交给对应的截取接口
SQL 中 substr 的正起点同样从一开始,所以左段从一取到分隔符之前,长度写为 p-1;右段从 p+1 开始。末尾冒号之后没有内容,得到空串是合理结果。如果把位置交回使用零基下标的语言,还应在接口边界明确转换,不能在多个层里反复减一。
本例把未命中的左右段留为 NULL,同时保留 status。不要先将位置中的 NULL 替换成零,再期待后面还能够区分两类输入。原始状态一旦合并,报错信息、统计数量以及后续修复队列都可能丢失依据。是否接受空名称和空内容,则由具体格式另行规定。
两个参数都为 BLOB 才按字节搜索
代码后半段把同一份文字明确编码成 UTF-8,再将 bytes 绑定给查询。文本里的冒号位于二,二进制序列里的冒号位于四。关键是查找与后续截取使用同一种表示:文本结果交给文本 substr,BLOB 位置交给 BLOB substr,不要把其中一个位置套到另一份数据。
这里直接绑定编码后的 bytes,使测试不依赖数据库文本转 BLOB 时采用的编码。检查类型的断言也提醒我们,参数的实际存储类别会影响函数行为。不要仅凭列名带有 text 或某个值看起来像文字,就认为两个实参必然都按预期方式参与搜索。
对于业务格式,分隔符还应是明确的非空值。空查找串虽然可以被函数接受,却不表示发现了一个实际字段边界,通常应该在查询入口拒绝。若分隔符包含多个字符,右段起点也不能继续机械地只加一,应按同一表示下的分隔符长度移动。
这套写法适合只按第一个固定分隔符拆分的简单字段。带引号、转义或嵌套结构的数据需要自己的解析规则,连续调用 instr 无法自动理解这些结构。保留六类输入及文本、二进制两个断言,就能在改查询时检查拆分契约是否仍然成立。
资料核对日期:2026年10月2日(北京时间)。示例在 Python 3.12.14、SQLite 3.53.1 中独立运行。



