

SQLite HAVING 不写 GROUP BY:三条输入为什么最后只剩一行或零行
想在待办数量达到门槛时返回一个汇总,查询写了 count 和 HAVING,却没有 GROUP BY。它并不会为每条任务分别做一次门槛判断:这是整体聚合,所有经过筛选的输入共同形成一份统计,条件决定这份统计是否进入结果。
先过滤输入,再决定保留汇总
下面的表只有三条任务,其中两条为 open,一条为 done。WHERE 先决定哪些任务参与统计;count 计算这批输入的数量;HAVING 再检查这个数量。因此把门槛从二改成三,变化的是唯一汇总行能否留下,不是从两条任务中再删一条。
保存为 demo.py,运行 python demo.py。SQLite 从三点三十九开始允许没有 GROUP BY 的聚合查询使用 HAVING,代码先检查底层库版本。查询通过占位符绑定状态和阈值,整个例子只使用独立内存库,不依赖表中记录的读取顺序。
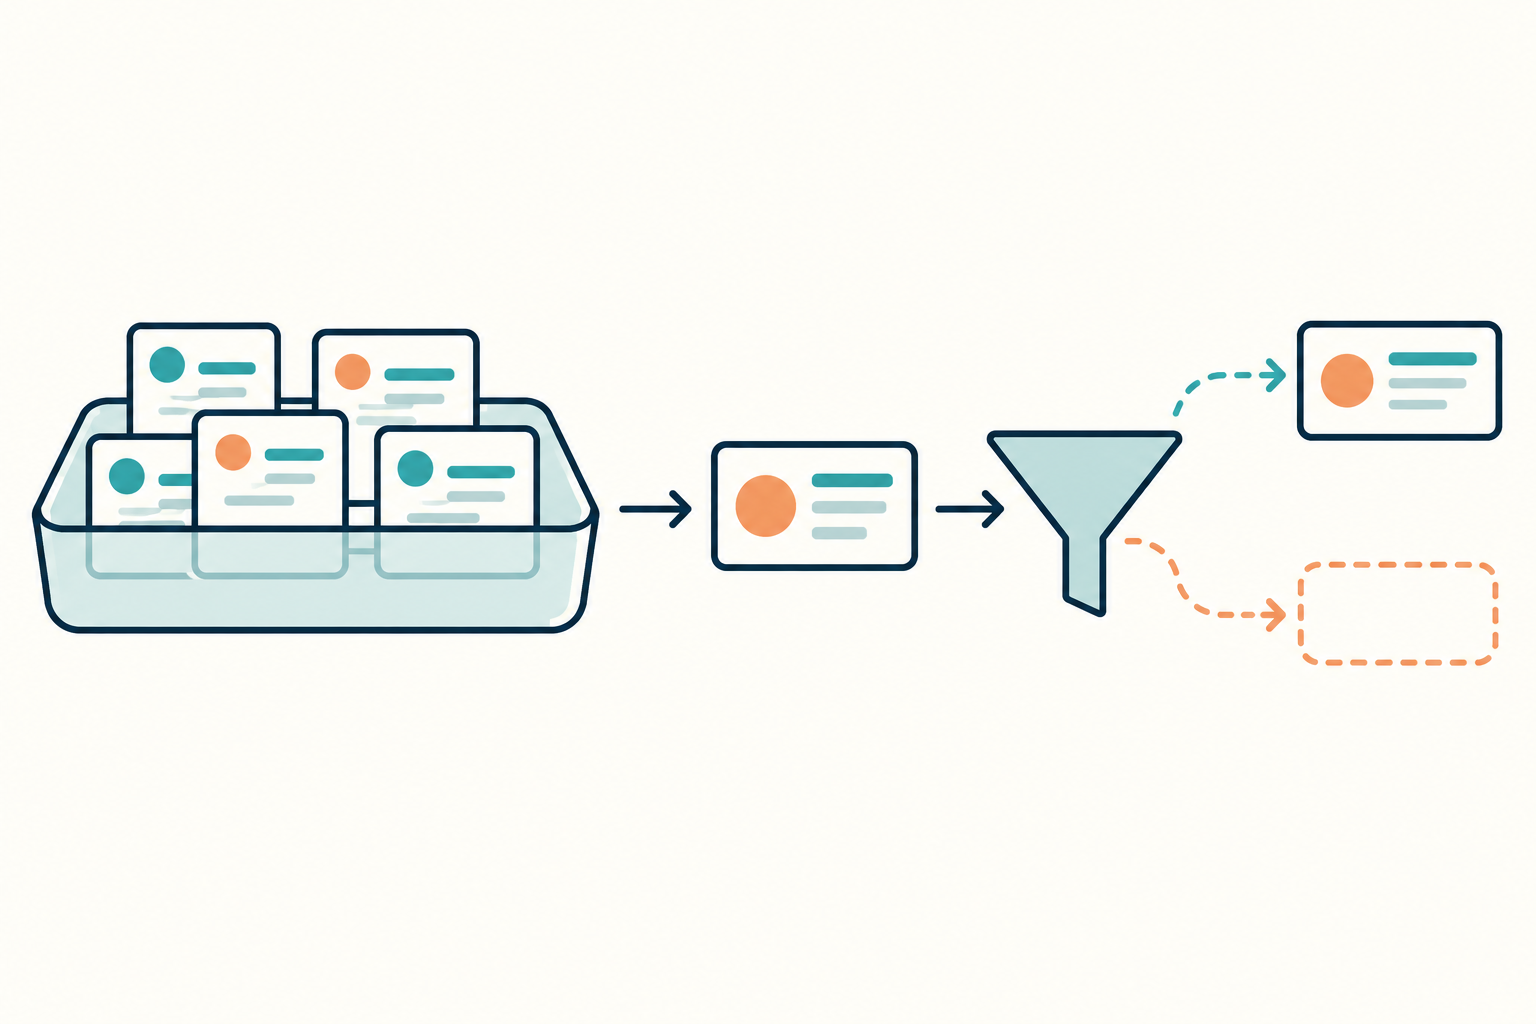
AI概念示意图:全部合格输入先形成一份汇总,再由组条件决定是否输出这份汇总。
import sqlite3

assert sqlite3.sqlite_version_info >= (3, 39, 0)
db = sqlite3.connect(":memory:")
try:
    db.execute("CREATE TABLE task(id INTEGER PRIMARY KEY, state TEXT)")
    db.executemany("INSERT INTO task VALUES(?, ?)",
                   [(1, "open"), (2, "open"), (3, "done")])
    def summary(minimum):
        return db.execute("""
            SELECT count(*) FROM task
            WHERE state = ?
            HAVING count(*) >= ?
        """, ("open", minimum)).fetchall()

    passed, blocked = summary(2), summary(3)
    assert passed == [(2,)] and blocked == []
    print("threshold two:", passed)
    print("threshold three:", blocked)

    zero = db.execute("""
        SELECT count(*) FROM task WHERE state='missing'
        HAVING count(*) = 0
    """).fetchall()
    grouped = db.execute("""
        SELECT state, count(*) FROM task WHERE state='missing'
        GROUP BY state HAVING count(*) = 0
    """).fetchall()
    assert zero == [(0,)] and grouped == []
    print("empty input, whole group:", zero)
    print("empty input, explicit groups:", grouped)

    try:
        db.execute("SELECT id FROM task HAVING id > 1").fetchall()
    except sqlite3.OperationalError as error:
        assert "non-aggregate" in str(error)
        print("non-aggregate HAVING: rejected")
    else:
        raise AssertionError("non-aggregate HAVING unexpectedly accepted")
finally:
    db.close()
threshold two 返回包含整数二的一行;threshold three 返回空列表。后者表示汇总被条件排除,不能解释为当前有零条待办。两次查询的输入没有变化,差异完全来自汇总通过门槛的要求。
零条输入也要区分查询结构
第三个查询先筛选不存在的状态,输入集为空;整体 count 仍可算出零,且满足 HAVING count 等于零,所以返回一行零。第四个查询加上按状态分组,空输入没有形成任何状态组,最终就没有行。这个对照说明空输入与空结果并不是同一个条件。
如果调用方总要显示待办数,即使低于门槛也不能缺少字段,通常应直接查询 count,再由应用决定是否显示提示。若接口约定只有达到门槛才返回汇总,则可以让 HAVING 表达筛选,并把没有结果行作为明确分支处理。
使用 fetchone 时,空结果会得到 None,一行计数零则得到含零的元组。不要通过元组里第一个数的真假去替代结果是否存在;先判断有没有行,再读取计数,才能保留“未通过条件”和“统计为零”的区别。
没有分组列,不代表没有聚合
末段故意去掉 count,只选择 id,然后使用 HAVING。当前 SQLite 将它拒绝为非聚合查询。允许省略 GROUP BY 的前提在这里是聚合查询,不能把 HAVING 当成可以随处替换 WHERE 的另一种行过滤写法。
条件如果涉及原始任务属性,例如只统计某种状态,应放在输入过滤步骤;条件如果涉及整批的数量或合计,应放在聚合之后。把条件挪到不同阶段,会改变参与统计的行,不能因为两段 SQL 都能运行就认为结果等价。
本例只输出聚合值,不在汇总旁随手带上一条任务编号。整体统计如果再夹入未聚合的普通列,就会引入那一列究竟来自哪条输入的问题。需要明细和总数同时展示时,应另行设计明确的结果结构。
阈值测试至少选取刚好达到、差一条和没有输入三种情况。只试门槛明显较低的样本,容易把“一定返回一行”误当成接口保证;加上条件不通过的样本,才能发现调用方有没有错误地直接索引第一行。
这里的分阶段说明描述查询含义,并不要求引擎按相同物理步骤逐个执行。优化器可以选择不同计划;验收要看输入范围、统计值与最终行数是否符合约定,不要把概念上的执行顺序当作性能承诺。
参考资料
资料核对日期:2026年10月2日(北京时间)。示例在 Linux、Python 3.12.14、SQLite 3.53.1 中独立运行。



