

JavaScript 后行断言:同样的贪婪分组,为什么在左边少拿了一个字符
把两个捕获组移进后行断言,表达式仍然匹配成功,但第一个组从 ab 变成 a,第二个组从 c 变成 bc。不是贪婪规则失效了,而是断言从当前位置向左检查,右侧的组先获得匹配机会。判断分组结果时,必须把方向一起带进推演。
本文在 Node.js v24.19.0 执行。代码保存为 demo.mjs,通过 node demo.mjs 运行。样本只有三个英文字母,避免把 Unicode 位置单位或复杂输入混进这个实验;所有捕获内容与匹配位置都用断言确认。
同一段字符,从两个方向分配
正向表达式从开头开始,第一个组尽量取到 ab,再把 c 留给第二组。后行断言位于结尾,从这里向左求证前文,右边的第二组先尽量取到 bc,剩下 a 才归第一个组。两边都贪婪,只是先处理的部分不同。
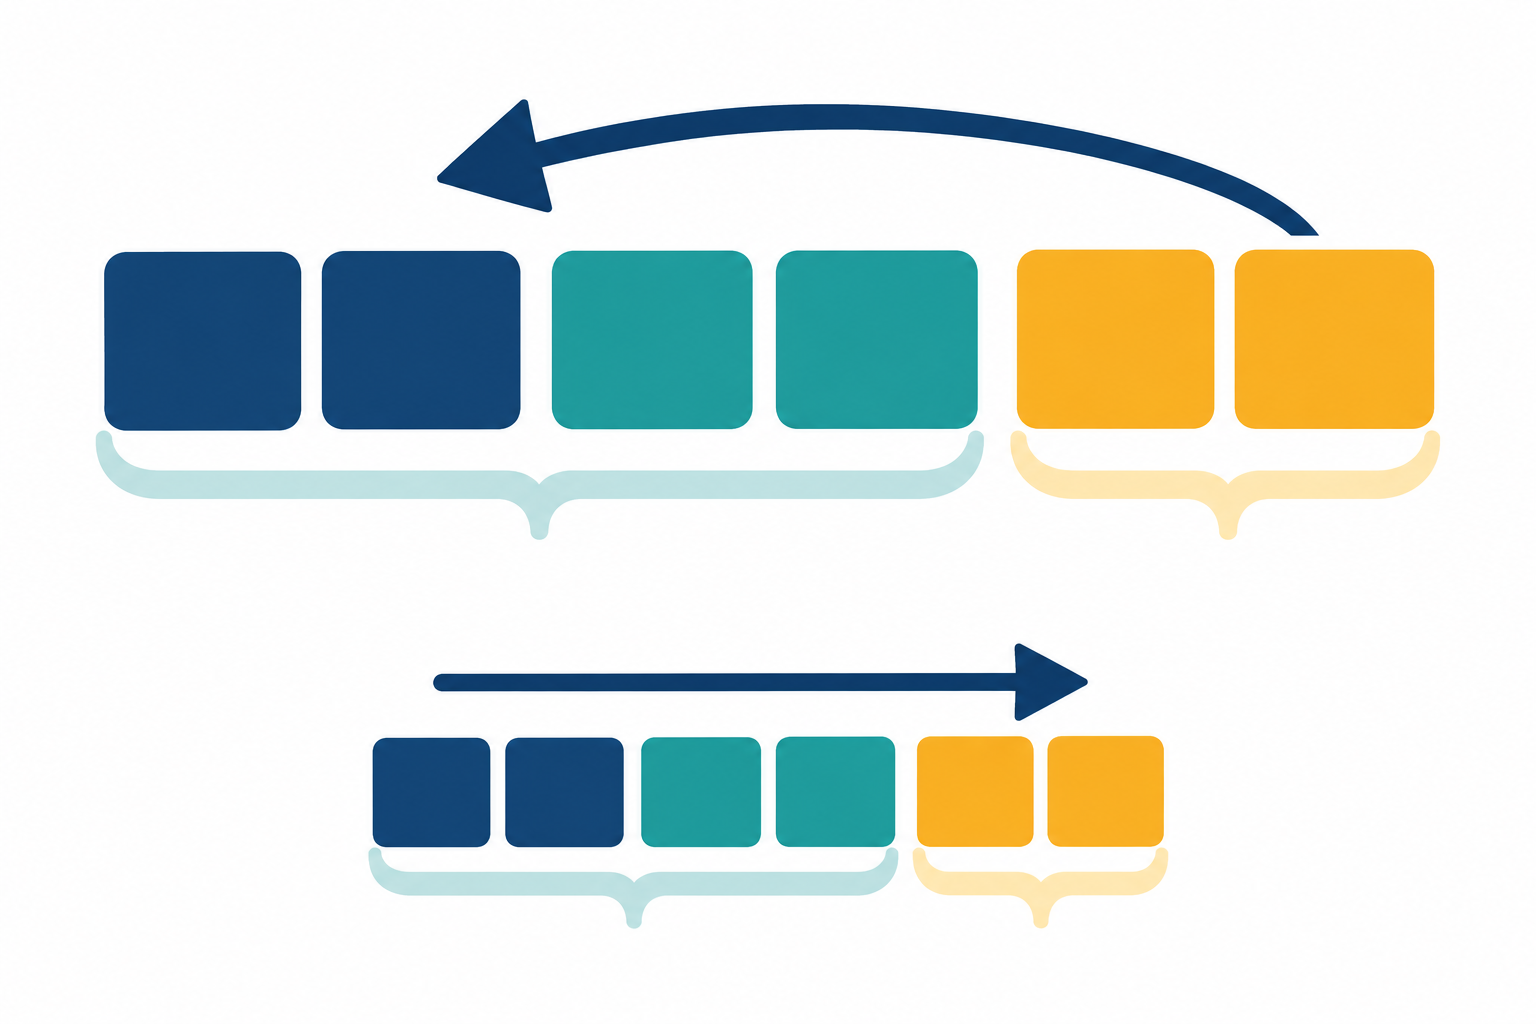
AI概念示意图:两行图块由相反方向的箭头检查,括号表示分组;图形展示匹配方向,不对应精确的运行数据。
import assert from 'node:assert/strict';

const forward = /^([ab]+)([bc]+)$/.exec('abc');
const behind = /(?<=([ab]+)([bc]+))$/.exec('abc');
assert.deepEqual(forward.slice(1), ['ab', 'c']);
assert.deepEqual(behind.slice(1), ['a', 'bc']);
assert.equal(behind[0], '');
assert.equal(behind.index, 3);
console.log('forward:', forward.slice(1).join(','));
console.log('behind:', behind.slice(1).join(','));

const repeatedForward = /([ab])+c/.exec('abc');
const repeatedBehind = /(?<=([ab])+)c/.exec('abc');
assert.equal(repeatedForward[1], 'b');
assert.equal(repeatedBehind[1], 'a');
console.log('repeated:', repeatedForward[1], repeatedBehind[1]);

const amount = /(?<=USD )\d+/.exec('USD 12');
assert.equal(amount[0], '12');
assert.equal(amount.index, 4);
assert.equal(/(?<=USD )\d+/.exec('EUR 12'), null);
console.log('amount:', amount[0], 'index:', amount.index);
逆向检查不会倒写捕获文字
输出 forward 为 ab,c,behind 为 a,bc。第二个组拿到的仍是原文顺序的 bc,而不是 cb。匹配方向影响搜索及分配,捕获结果仍是一段原文子串。不要为了“修正逆向”再把字符串反转,否则会把正确内容改坏。
后行断言本身不消耗字符。第一组实验的完整匹配是空字符串,位置在原文末尾三;它可以拥有非空捕获组,却仍不把这些字符包含在完整匹配里面。若只打印捕获值,很容易误以为整个 abc 都已被表达式消费。
另一个例子检查 USD 和空格之后的数字,完整匹配为十二,位置为四。前面的标识参与验证,却不进入匹配文本。把这个模式用于替换时,默认替换的也是完整匹配部分,不能未经测试就认为断言检查过的前缀也会被删掉。
重复捕获保存哪一次也受方向影响
正向的重复单字符组最终保留 b,后行断言里的相同重复组保留 a。一个捕获槽不会自动收集每次重复的历史;这里留下的是对应方向上最后一次捕获的内容。需要每个片段时,应让各片段成为独立匹配,或采用显式扫描逻辑。
分组编号仍由表达式中的括号结构决定,不会因为从右向左匹配就重新编号。排查时建议同时写出整个匹配、每组内容和预期位置,而不是仅断言“结果不为空”。匹配成功但分配不同,常常比完全匹配失败更难被简单测试发现。
不要把贪婪理解成全局寻找最大总长度后随意分组。引擎按规则尝试并回溯;相邻组能够接受的字符重叠时,方向和结构都会影响哪一组得到边界字符。把组改成惰性也会改变尝试顺序,应重新验证完整样本。
迁移表达式时保留最小反例
JavaScript 支持这里使用的可变长度后行断言,但其他正则引擎可能要求固定长度,或在捕获细节上使用不同规则。跨语言复制之前,应查目标引擎文档并运行同一组断言,不能只看括号语法相似就认为结果完全相同。
如果需求只是提取一个明确前缀后的值,简单的前缀加捕获组也可能更容易读。使用后行断言时,把“检查前文但不消费”的必要性写清楚。至少保留相邻贪婪组、重复组以及前缀不匹配三个样本,让未来的正则改动有可复核的边界。



