

Python enumerate 的起始编号:标签从十开始,为什么第一条数据仍没有跳过
导入一份带表头的名单,想让第一条数据标成第二行,于是写 enumerate(rows, start=2)。结果表头仍然被处理,只是贴上了编号二。另一个常见问题是把分页起始编号设成十一,随后拿这个编号访问只有三项的当前页列表,程序立刻越界。两种错误都把显示标签当成了读取位置。
enumerate 每次从输入中拿到一个元素,再配上递增计数;start 决定计数的初值,没有跳过输入的含义。下面用普通列表和一次性迭代器分别验证。保存为 demo.py 后运行 python demo.py,不需要文件、网络或第三方包。
先复现编号正确、数据却错误的情况
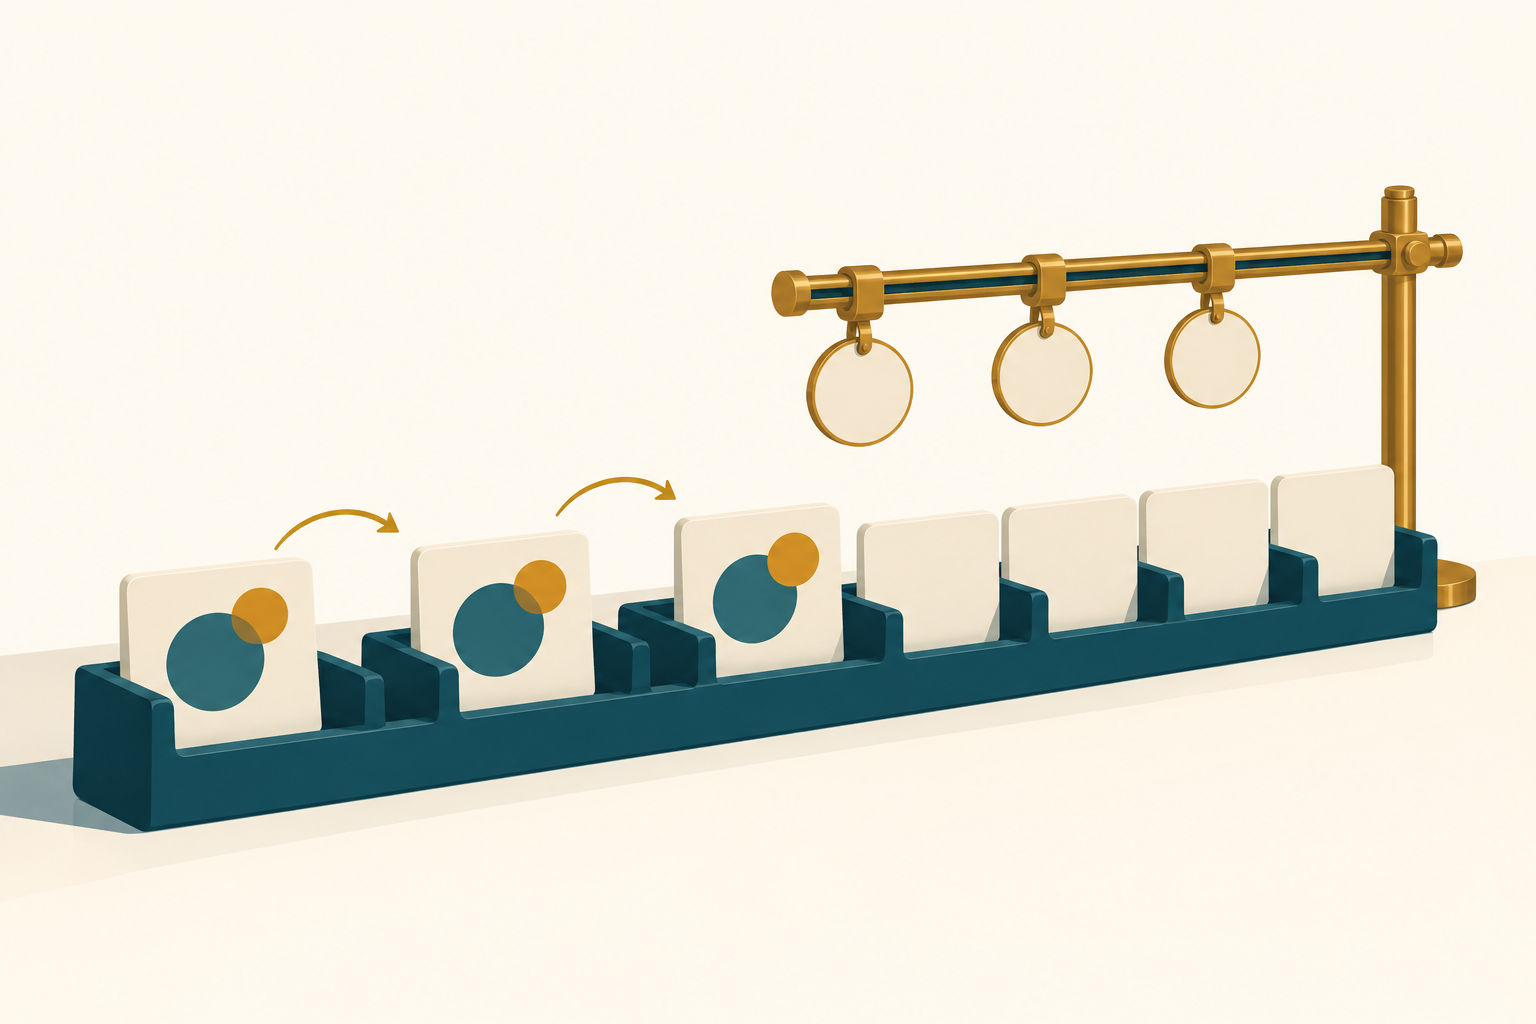
AI概念示意图:完整数据队列仍在原处,上方标签轨道独立改变起点。图片不是运行截图。
rows = ["name", "Ada", "Lin"]
wrong = list(enumerate(rows, start=2))
assert wrong[0] == (2, "name")
print("labels only:", wrong)

stream = iter(rows)
assert next(stream, None) == "name"
correct = list(enumerate(stream, start=2))
assert correct == [(2, "Ada"), (3, "Lin")]
print("header skipped:", correct)

page = ["Ada", "Lin", "Kai"]
try:
    for display_no, value in enumerate(page, start=11):
        _ = page[display_no]
except IndexError:
    print("display number is not a list index")
else:
    raise AssertionError("expected IndexError")

base = 10
pairs = [(base + index + 1, page[index])
         for index, value in enumerate(page)]
assert pairs == [(11, "Ada"), (12, "Lin"), (13, "Kai")]
print("page labels:", pairs)

lines = ["", "Ada", "", "Lin"]
physical = [(n, value) for n, value in enumerate(lines, 1) if value]
compacted = list(enumerate((value for value in lines if value), 1))
assert physical == [(2, "Ada"), (4, "Lin")]
assert compacted == [(1, "Ada"), (2, "Lin")]
assert list(enumerate([], 100)) == []
print("physical:", physical)
print("compacted:", compacted)
第一行输出 [(2, "name"), (3, "Ada"), (4, "Lin")] 的等价 Python 表示:表头 name 没有消失。随后显式取走表头,再枚举剩余迭代器,才得到第二行 Ada、第三行 Lin。next 的默认值只处理空输入;代码仍核对表头名称,防止把格式不符的第一条业务记录悄悄丢掉。
页内索引和全局显示号各用一个变量
三条分页数据对应列表索引零、一、二,显示号十一、十二、十三。用 start=11 以后返回的数字是标签,不会把原列表变成从十一开始索引的容器。反例故意捕获 IndexError,修复则从零枚举,以 index 访问当前页,用 base 加 index 加一生成显示号。
如果循环只需要打印编号和元素,直接使用 start=base+1 很清楚,完全不必再回到列表查一遍。只有确实要同步修改另一个同长度列表时,才保留页内索引,并核对两个集合是否仍一一对应。变量名用 display_no 与 index,比统一叫 i 更容易在审查中发现混用。
过滤发生在编号前后,含义也会变化
最后两组断言处理带空行的原始文本。先枚举再过滤,留下的号码是原始物理行号二和四;先过滤再枚举,号码是整理后记录序号一和二。它们都能运行,却回答不同问题。错误报告通常需要原始行号,整理后的展示清单则可能需要连续序号,应按读者要回到哪里寻找数据来选择。
如果数据来自 CSV 解析器,一条记录内部可能包含带引号的换行,所以“记录序号”又未必等于文本的物理行号。不要仅凭 enumerate 的数字就宣称它准确指向文件某一行。遇到此类格式,应使用解析器提供的位置信息,并用多行字段样本核验。
把跳过与重新编号写成两个动作
跳过固定数量的输入,需要切片或显式消费迭代器;只想改变标签,则设置 start。对于已经读过部分内容的迭代器,enumerate 从当前位置继续,不会回到开头。空输入无论设置多大的起始号,仍然产生零条结果,不能用最后一次循环变量推断数量。
本例的分页偏移是假定外层已经取得对应页面,并不访问数据库,也不保证源数据在翻页期间保持不变。测试时同时断言标签、元素和数量,至少覆盖空页、首条、过滤空行及非零页偏移,才能区分编号错误与真正取错数据。
资料核对日期:2026年10月2日(北京时间)。代码在 CPython 3.12.14 中独立运行。



