

Python UserDict 与 dict 子类:重写了 __setitem__,为什么 update 仍绕过转换
想让配置键统一大写,最直接的做法是继承 dict 并重写 __setitem__。单条赋值测过没有问题,接上 update 批量导入后,小写键却重新出现。问题在于“某个方法完成写入”和“这个方法一定调用被重写的钩子”是两项不同承诺,不能只根据方法名字推断内部调用路径。
下面把规则限制为字符串键转大写,避免输入类型和业务校验干扰观察。完整代码可保存为 demo.py,使用 python demo.py 执行,只操作内存。dict 子类的结果在本文所用 CPython 中验证;如果项目依赖别的 Python 实现,应在目标运行时检查,不能把一次实验扩写成所有实现的内部约定。
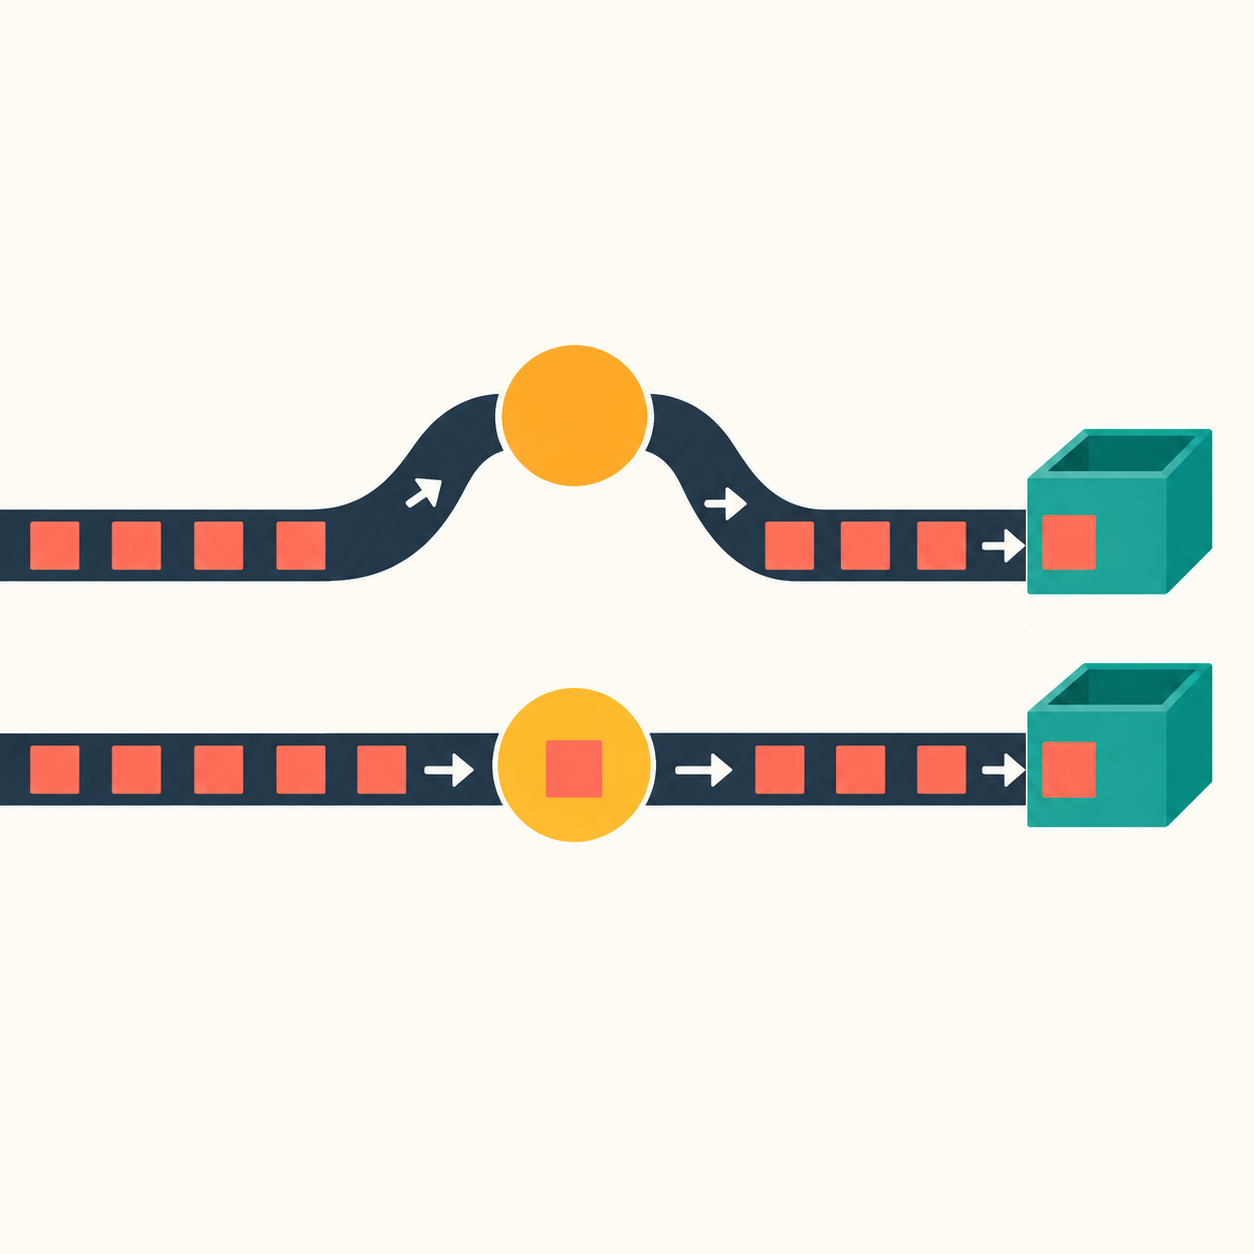
AI生成概念插图:两条写入路线分别绕过和经过检查点,表示批量更新与逐项赋值的调用路径差异;不是软件界面或运行截图。
from collections import UserDict

class UpperDict(dict):
    def __setitem__(self, key, value):
        super().__setitem__(key.upper(), value)

class UpperUserDict(UserDict):
    def __setitem__(self, key, value):
        super().__setitem__(key.upper(), value)

direct = UpperDict()
direct["alpha"] = 1
direct.update({"beta": 2})
assert direct == {"ALPHA": 1, "beta": 2}
print("dict:", dict(direct))

wrapped = UpperUserDict()
wrapped["alpha"] = 1
wrapped.update({"beta": 2}, gamma=3)
assert wrapped.data == {"ALPHA": 1, "BETA": 2, "GAMMA": 3}
print("UserDict:", wrapped.data)

created = UpperUserDict({"delta": 4})
assert created.data == {"DELTA": 4}
created.data["epsilon"] = 5
assert "epsilon" in created.data
print("raw data:", created.data)
逐项赋值与批量更新分别验收
第一行结果中 ALPHA 是大写,beta 仍为小写。前一条方括号赋值经过我们重写的方法,继承来的 dict.update 则没有沿这条钩子执行。仅测试 obj[key] = value 通过,不能证明初始化、更新、合并和默认值入口都执行相同的转换。业务规则若靠这种猜测维持,会在入口增加时悄悄失效。
UserDict 用普通字典保存内容,公开的 data 属性可以看到实际存储。这里的 update 来自可变映射的通用实现,逐项执行 self[key] = value,所以位置参数和关键字参数都进入重写后的方法。第二行包含 ALPHA、BETA、GAMMA,既验证结果,也验证了两类输入入口。
构造函数也要用同一组规则
UpperUserDict 的构造输入 delta 最终成为 DELTA,说明本例的初始化也使用了预期路径。若重写方法需要计数器或其他实例状态,应在父类初始化可能触发写入之前准备好那些状态。不要等构造完成后才建立依赖,再把初始化期间的错误误判成数据本身有问题。
不过 data 并不是保护业务规则的屏障。最后一次直接写 created.data,留下了小写 epsilon,因为调用者已经操作底层字典。对外暴露底层存储,就要接受绕过转换的可能;若不希望业务代码直接写入,应提供清晰接口,并在代码评审中约定存储属性的使用范围。
大写转换还会使 alpha 和 ALPHA 落到同一个键,后写的值会覆盖先写的值。这是本例规则的结果,不是 UserDict 自动判断出了重复配置是否合理。正式导入前应决定冲突是覆盖、报错还是保留来源,并用重复键样本验收。转换后再说“原输入没有重复”,已经遗漏了规范化造成的碰撞。
选择基类时先列出真正允许的修改入口,再逐个测试。需要重用映射通用方法并集中定制逐项写入时,UserDict 往往更易观察;必须保持 dict 子类接口时,则应明确实现所需入口并核对版本行为。无论选哪种,不能把重写一个方法当成所有修改都已经受到约束。
资料核对日期:2026年10月2日(北京时间)。示例在本地CPython 3.12.14实际运行并通过断言,结果对应文中固定输入。



