

LlamaIndex发布Extract v2.5:文档字段更容易回查来源,表格模式仍不返回引用与置信度
2026年10月1日,LlamaIndex发布Extract v2.5,更新按指定结构提取文档数据的代理系统。此次变化覆盖提取准确性、跨页理解和来源定位;公司表示各档位每页价格没有提高。对处理长表单、扫描材料和重复记录的团队,最值得关注的是错误能否更快回到原文核查。
提取出一个值,还要找得到它的依据
Advanced Citations会定位支持字段值的原文区域。新版本改进了这项能力,并从Agentic Plus扩展到Agentic。LlamaIndex在自家ExtractBench中报告三个档位的总体表现提升,展示的例子包括长列表漏项、跨页记录断裂,以及把批注误并入原始字段。这些属于发布方的测试和示例,本文没有独立复现。
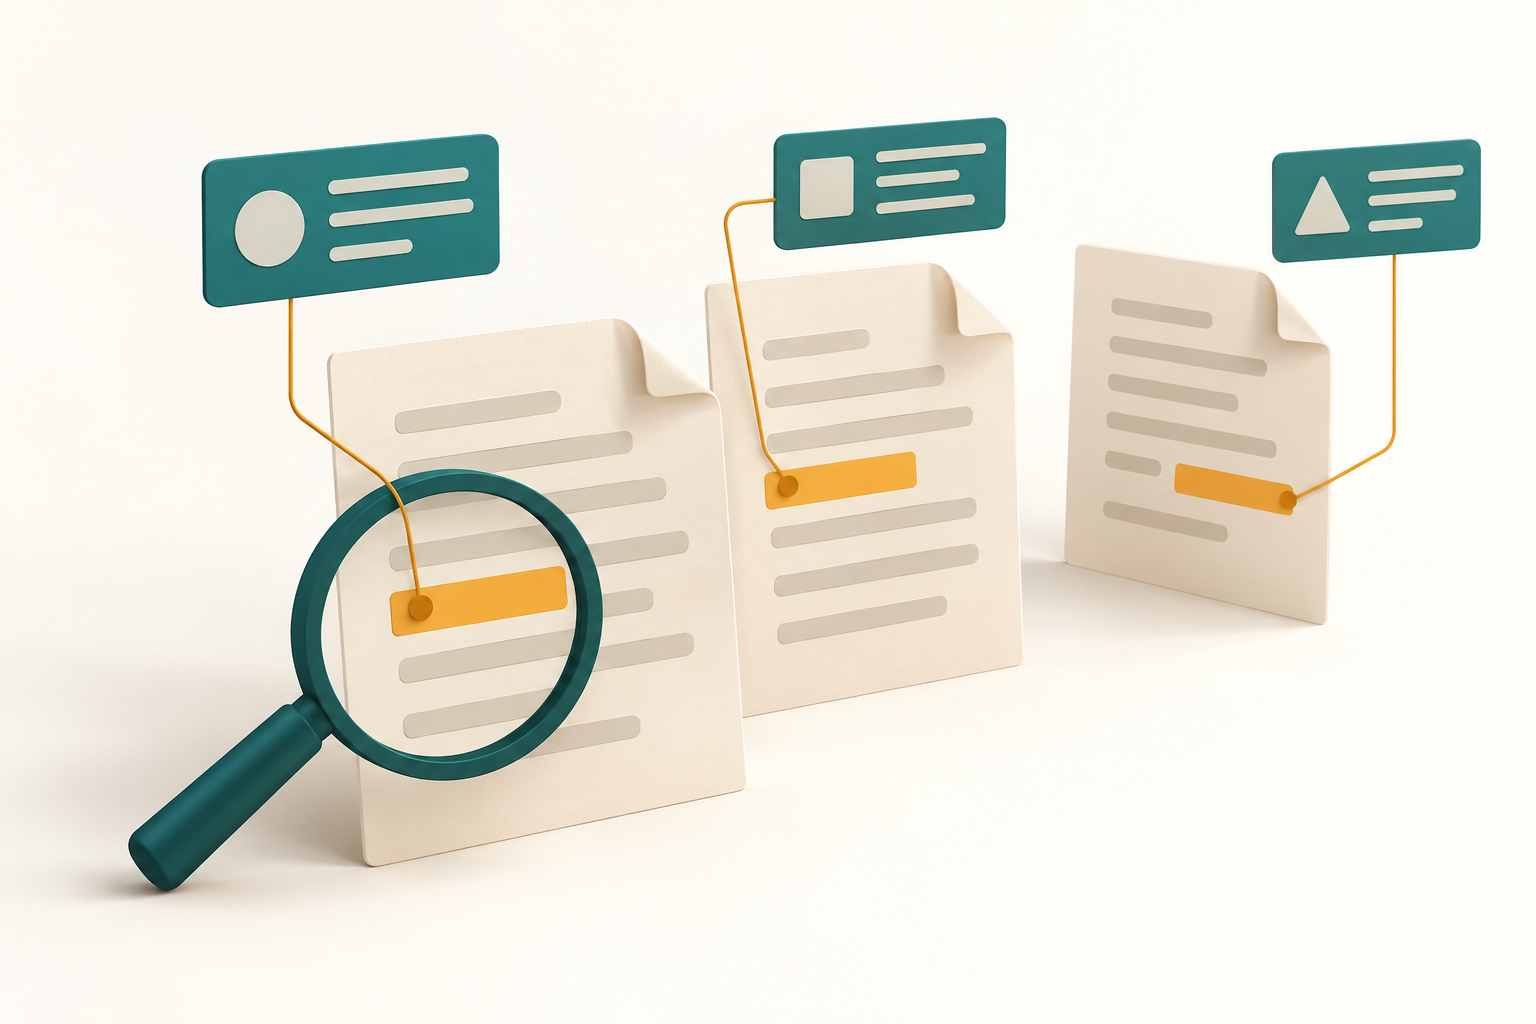
AI模型生成的概念配图,表现提取字段回连文档证据,并非真实文件、产品截图或准确率结果。
引用、置信度和表格模式并不总能一起开启
配置文档允许指定2.5版本;使用latest则会选择对应档位的最新兼容版本。来源引用和置信度默认关闭,需要主动启用。原生表格模式可以直接读取工作簿单元格,但文档明确写明该模式不提供引用或置信度,因此不能假设公告中的所有能力会同时出现在每条处理路径上。
以下为本文分析。假设一份设备清单在页末列出编号,下一页才接上地点和维护人。验收时只看每个字段有没有值,可能漏掉“内容都正确,却配到了另一台设备”的错误。更有用的做法是要求记录保留稳定编号,并把整条记录与其跨页依据一起检查。
升级比较应保留同一批难题
先选取以往确实需要人工修正的材料:重复多的列表、有手写改动的扫描件、同一条记录跨页的附件。固定字段定义和版本,分别记录漏项、错配、数值错误以及证据位置错误。这样能看清改进发生在哪里,避免被一个综合分数掩盖关键字段的退步。
置信度也应对应自己的验收数据来使用。一个高分结果仍可能抓错记录,低分结果也不一定错误。可以先按分数划出待复核范围,再统计复核者需要翻几页、花多少时间找到依据。若字段值的质量相近,但出处更易查找,人工交接仍可能得到实际改善。
本文未调用Extract v2.5,以上清单与评估步骤是原创建议。公告没有统一给出所有工作负载的延迟承诺,不能由单页价格不变推导出每份文件的总处理成本必然下降。
来源与核验
产品公告日期为2026年10月1日;配置文档用于核对版本、默认开关及表格模式限制。资料于北京时间2026年10月2日核验。



