

用 AI 画因果注意力掩码:挡住未来位置,要在归一以前完成
学习Transformer时,看到一个下三角格子容易记住形状,却未必知道它挡住了什么。让AI制作四个位置的可见性练习,再故意提交一个“乘零掩码”的错误版本,比只背术语更容易定位问题。
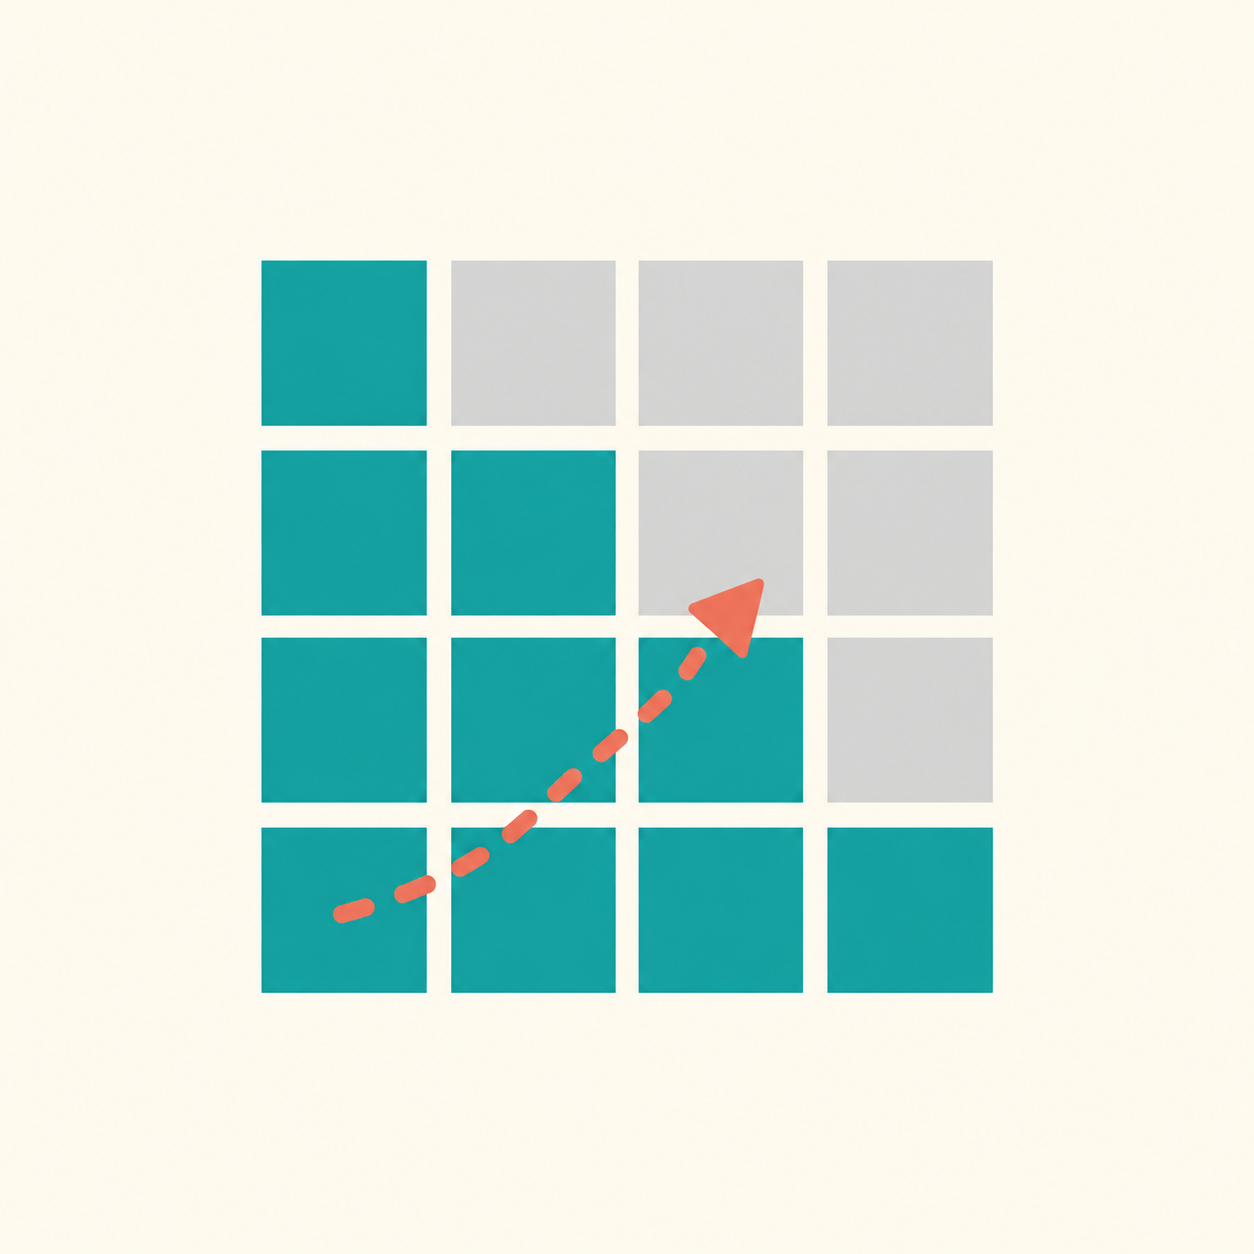
AI模型生成的概念插图:三角形可见区域;不是运行截图、照片或真实模型的注意力热图。
行是查询位置,列是可读取位置
教学输入依次为起始符、我、想、读,编号1到4。训练目标依次为我、想、读、书,也就是每个位置预测下一个词。方阵中,第i行只允许读取第1到i列,包含当前位置。四行允许标记为1000、1100、1110、1111;1只表示允许,并不代表最终权重为1。
第三行的输入是“想”,目标是预测“读”。它能读取起始符、我、想,却不能直接看第四个输入“读”。如果把所有输入都开放,训练时就可能从未来位置得到正在预测的答案。当前输入可以看见,与未来目标可以看见,是两件不同的事。
全零分数能暴露错误写法
先不计算查询和键的向量内积,直接给第三行四个注意力分数都设为0;给四个值分别设成2、4、8、100。它们只是便于手算的标量,不声称对应某个词的真实表示。本例没有dropout。
正确处理是在softmax之前把第四项排除;等价的理想写法是给该项加负无穷。前三项指数都是1,归一后权重为1/3、1/3、1/3、0,因此输出是(2+4+8)/3=14/3,约4.666667。
错误版本把分数逐项乘以1110。由于原分数全为0,结果仍是四个0,softmax会给每项1/4,输出变成(2+4+8+100)/4=28.5。被“遮住”的未来值仍然进入结果。这个反例说明:可见形状写对了,还要把它用在正确的计算步骤。
修改未来值,看哪套结果会变
把第四个值从100改成1000,正确结果仍为14/3;未真正排除第四项的版本则变成253.5。可以把这一步作为小型验收:在其它条件固定时,仅改变不可见位置的值,不应该影响第三行输出。
本文用独立计算核对了可见集合、权重总和及两次输出。PyTorch官方说明展示了因果遮挡、加性掩码和softmax的先后关系。实际API中布尔值表示允许还是禁止,不能只看变量名猜测;不同接口可能采用不同约定。
完整练习提示
“为输入[起始符,我,想,读]、目标[我,想,读,书]生成四行因果可见表,行是查询、列是键,允许j≤i。第三行分数全0,值为[2,4,8,100]。先按正确遮挡计算,再演示仅把分数乘1110的错误。把末值改成1000,复算并解释差异。不得把允许标记称为注意力概率,也不要推断词的真实语义表示。”
这个方阵只覆盖等长、自注意力的教学情形。带缓存时查询和键可能不等长,还要另外对齐绝对位置;填充位置也需独立屏蔽,不能把一张下三角图直接套到所有模型接口。
资料核对日期:2026年10月2日。文中为原创教学设定,计算核验不代表真实模型测试。



