

Node.js Readable.from 的字符串入口:明明可以逐字遍历,为什么只收到一整块
字符串可以用 for...of 逐个码点读取,于是把它交给 Readable.from 后,容易预期每次收到一个字符。Node.js 对直接传入的字符串和 Buffer 有专门处理:它们不会按照普通可迭代对象的方式逐项拆开。测试流处理函数时,这个入口差异会直接改变观察到的块数。
以下程序在 Node.js v24.19.0 上实跑。保存为 demo.mjs,运行 node demo.mjs。所有数据都写在程序中,使用默认的对象模式,没有文件或网络连接。inspect 收齐有限样本后才输出,方便比较每个块的类型和值。
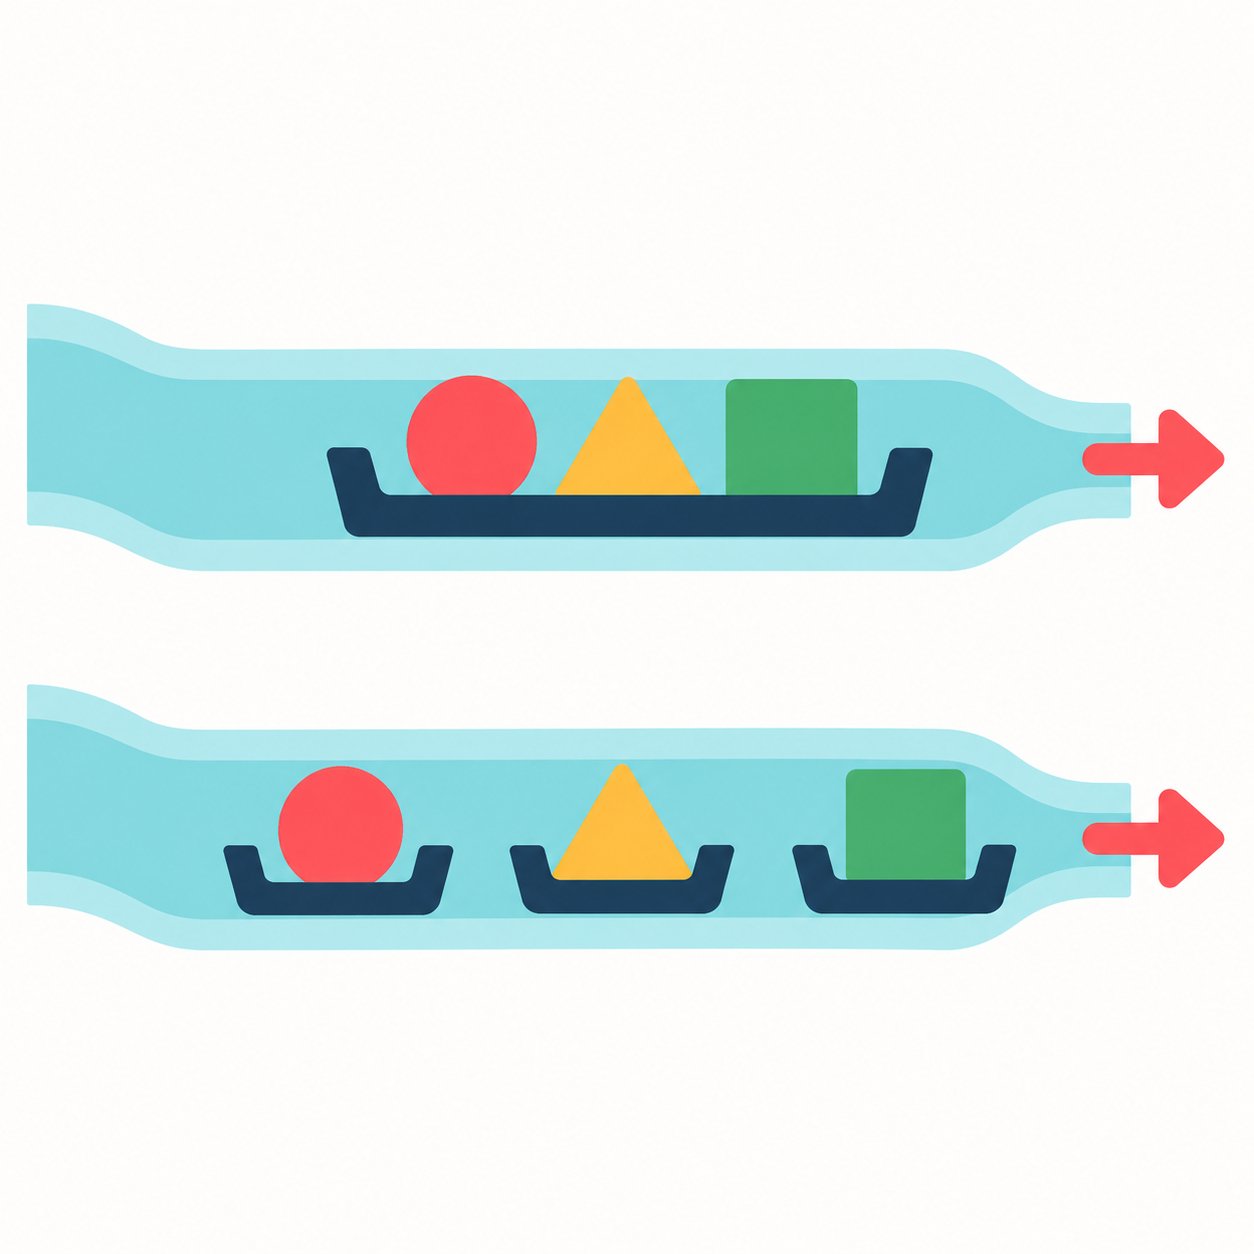
AI模型生成概念示意:上方一只长托盘承载整段内容,下方几只小托盘分别承载元素;图中托盘表示入口产生的概念块,不是网络数据包或性能测试图。
完整实验
import { Readable } from 'node:stream';

async function inspect(label, source) {
  const chunks = [];
  for await (const chunk of Readable.from(source)) {
    chunks.push(Buffer.isBuffer(chunk)
      ? { type: 'Buffer', value: chunk.toString('utf8') }
      : { type: typeof chunk, value: chunk });
  }
  console.log(label, JSON.stringify(chunks));
}

const text = 'A🌱B';
await inspect('string', text);
await inspect('iterator', text[Symbol.iterator]());
await inspect('records', ['first line\n', 'second line\n']);
await inspect('buffer', Buffer.from('AB'));

try {
  await inspect('invalid', ['ready', null, 'later']);
} catch (error) {
  console.log('invalid', error.code);
}
本地实际输出
string [{"type":"string","value":"A🌱B"}]
iterator [{"type":"string","value":"A"},{"type":"string","value":"🌱"},{"type":"string","value":"B"}]
records [{"type":"string","value":"first line\n"},{"type":"string","value":"second line\n"}]
buffer [{"type":"Buffer","value":"AB"}]
invalid ERR_STREAM_NULL_VALUES
string 只有一个条目,值是完整的 A🌱B;iterator 有三个条目,分别为 A、🌱、B。第二种写法传入的是字符串迭代器对象,不再是字符串本身,因此进入逐项读取可迭代对象的路径。这里的字符单位是字符串迭代器给出的码点,并不保证总等于用户眼里的一整个字形。
records 显示两项字符串各成一块,因为输入数组明确提供了两个元素。buffer 则保持为一个 Buffer 块,示例仅在记录输出时把它转成 UTF-8 文字。这个区别可用于准备可控测试样本:要测试若干业务记录,就传入记录数组或生成器;要测试整段文字,就直接提供字符串。
默认对象模式让上述观测容易复现,但代码不能据此断言任意流的一个块就是一行、一条消息或一个字符。改变对象模式、使用其他源或经过转换流后,块边界都需要重新检查。真正的行协议应按分隔符解析,长度协议应累计到规定字节数,不能依赖本例恰好收到几次循环。
边界与使用约定
最后一个输入数组含有 null。Readable.from 不允许把 null 当作普通元素推送,所以异步遍历抛出 ERR_STREAM_NULL_VALUES。inspect 尚未正常走到最终打印语句,程序只在外层 catch 中报告错误代码;这不表示前面的 ready 从未被取出。流处理可能已经消费一部分输入,发生失败后仍要由业务决定如何处理部分结果。
如果记录可能为空,应选择明确的对象,例如 { value: null },并让消费端识别这个字段。不要把缺失记录直接替换成 null 塞进流,也不要用空字符串假装所有空值都表达同一件事。
本例把结果累计到数组是为了展示短样本。处理大文件或无穷数据源时,这种收集方式会持续占内存,应边读取边处理,并安排错误与结束路径。先分清输入是什么对象,再设计解析规则,才能让测试入口与生产入口的差异可解释。
参考资料
官方资料核验日期:2026-10-02。



