

SQLite ntile 分桶:分数相同也会跨组,多出的行又先分给谁
把任务按分数排成三批时,很容易把 ntile(3) 理解成“相同分数一定放在一组”。实际上,它的目标是按窗口顺序让各桶的行数尽量均匀。相同分值碰上桶边界,可以被拆开;总行数不能整除时,靠前的桶会多分到一行。
下面用八条虚构数据,刻意把三个20分放在第一、第二桶交界处。程序在 Node.js v24.19.0 和内置 SQLite 3.53.3 上实跑,需要支持 node:sqlite 的版本。保存为 demo.mjs,运行 node --no-warnings demo.mjs。只使用内存数据库,不写入现有业务表;同样可以把其中SQL交给具备窗口函数的SQLite工具运行。
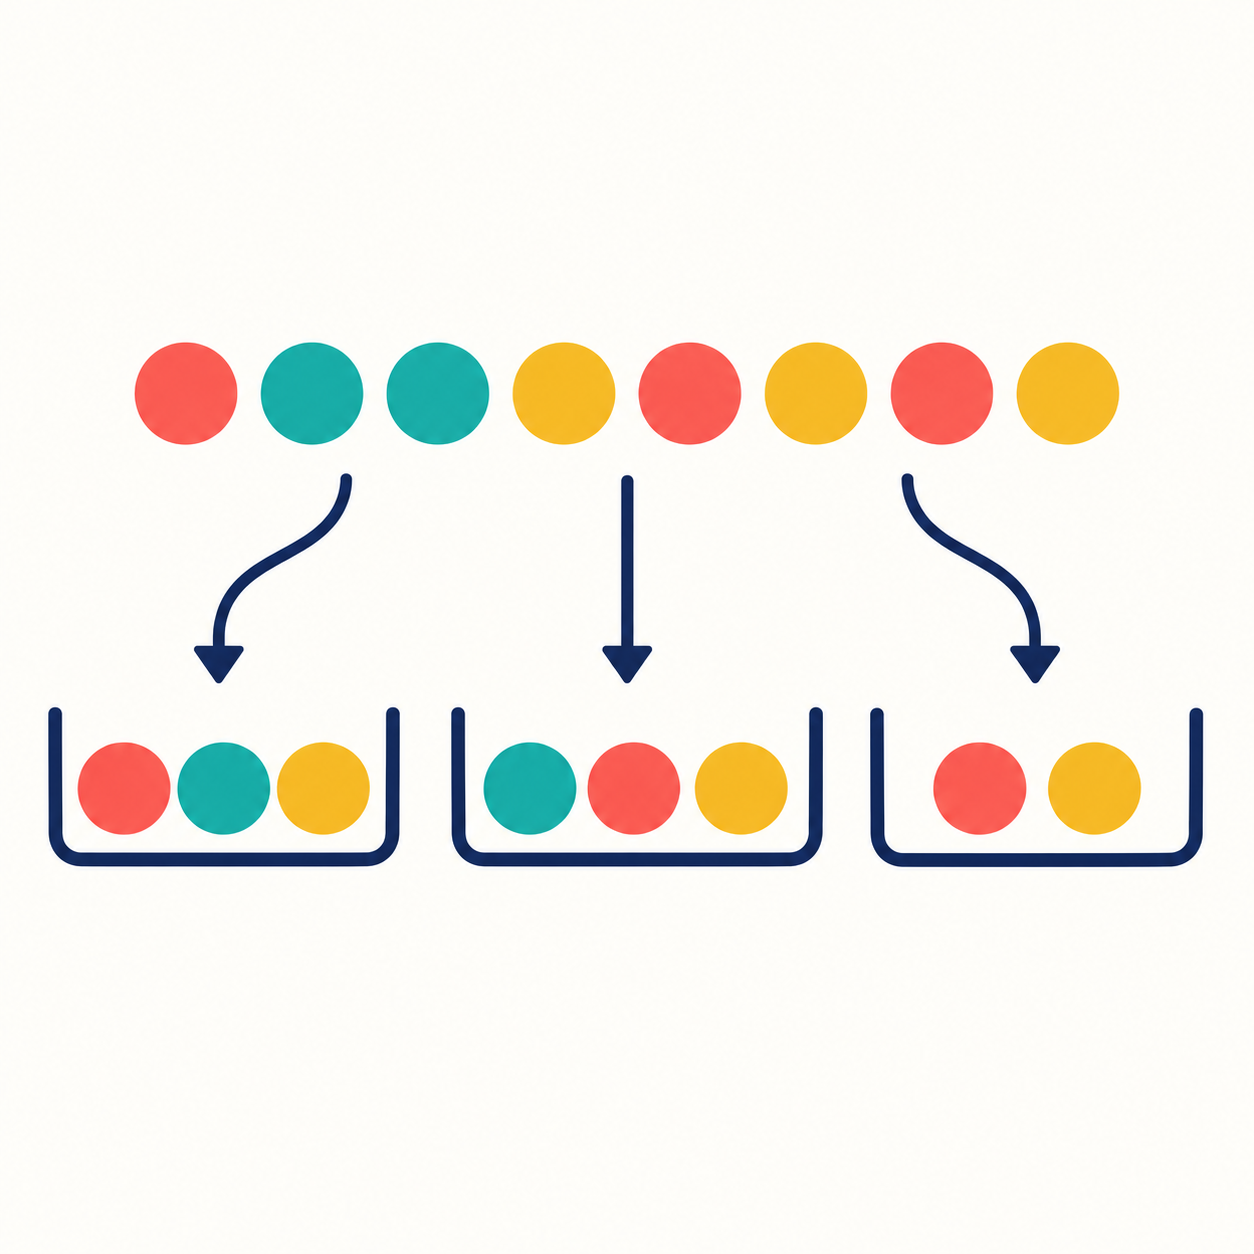
AI模型生成概念示意:八枚圆片分入三个容器,数量为三、三、二;图中颜色仅辅助区分图形,不代表示例记录的分数、编号或精确分配顺序。
完整实验
import { DatabaseSync } from 'node:sqlite';

const db = new DatabaseSync(':memory:');
try {
  db.exec(`
    CREATE TABLE sample (id INTEGER PRIMARY KEY, score INTEGER NOT NULL);
    INSERT INTO sample VALUES
      (1, 10), (2, 20), (3, 20), (4, 20),
      (5, 30), (6, 40), (7, 50), (8, 60);
  `);
  const rows = db.prepare(`
    SELECT id, score, ntile(3) OVER (ORDER BY score, id) AS bucket
    FROM sample ORDER BY score, id
  `).all();
  for (const row of rows) console.log('row', JSON.stringify(row));
  const sizes = db.prepare(`
    WITH assigned AS (
      SELECT ntile(3) OVER (ORDER BY score, id) AS bucket FROM sample
    )
    SELECT bucket, count(*) AS size FROM assigned
    GROUP BY bucket ORDER BY bucket
  `).all();
  console.log('sizes', JSON.stringify(sizes));
  const sparse = db.prepare(`
    SELECT id, ntile(5) OVER (ORDER BY id) AS bucket
    FROM sample WHERE id <= 2 ORDER BY id
  `).all();
  console.log('more-buckets', JSON.stringify(sparse));
  try {
    db.prepare('SELECT ntile(0) OVER (ORDER BY id) FROM sample').all();
  } catch (error) {
    console.log('invalid-count', error.message);
  }
} finally {
  db.close();
}
本地实际输出
row {"id":1,"score":10,"bucket":1}
row {"id":2,"score":20,"bucket":1}
row {"id":3,"score":20,"bucket":1}
row {"id":4,"score":20,"bucket":2}
row {"id":5,"score":30,"bucket":2}
row {"id":6,"score":40,"bucket":2}
row {"id":7,"score":50,"bucket":3}
row {"id":8,"score":60,"bucket":3}
sizes [{"bucket":1,"size":3},{"bucket":2,"size":3},{"bucket":3,"size":2}]
more-buckets [{"id":1,"bucket":1},{"id":2,"bucket":2}]
invalid-count argument of ntile must be a positive integer
八行分三桶,先给每桶两行,还剩两行,于是前两桶各补一行,得到 3、3、2。sizes 的实际输出就是这个结果。每行的 bucket 从1开始,反映它在这次完整查询中的位置分配,而不是表中永久保存的属性。
id为2、3、4的三条记录都为20分,其中前两条进入桶1,第三条进入桶2。查询写了 ORDER BY score, id,使用唯一的 id 把相同分数之间的顺序也固定下来。只按 score 排序时,相同分数的内部次序没有被这段SQL完整规定,不适合要求重复执行后每个编号都落到相同桶的场景。
窗口里的排序决定分桶;查询最外面的 ORDER BY 决定结果展示。两个位置虽然写了相同字段,却各管一件事。若仅改变最外层排序,看到的行顺序会变,窗口函数已经算出的桶号不会因此重算。
边界与使用约定
more-buckets 只保留两行,却指定五桶,返回的桶号只有1、2。查询不会额外造出三个没有记录的行。如果报表必须显示全部五个桶,即使数量为零也要出现,应另备桶编号表再关联结果。不能因为传了5,就断言这次查询一定返回5个非空组。
invalid-count 捕获了 ntile(0) 的错误,提示参数必须是正整数。业务入口应明确校验桶数为正整数,不依赖隐式数值转换处理小数或文字。动态桶数可以使用参数绑定,但绑定成功仍不等于分桶数量合理。
需要“同分必须同组”时,应先定义分数阈值或对分数等级制定分组规则,并接受各组行数不一定均匀。若目的是把处理工作尽量平均分批,ntile更合适,但它不会考虑每条任务的耗时差异。新增、删除或筛选记录还会改变分桶结果,因此稳定归属需求应把分配另行存储,而不是每次临时重算。
参考资料
官方资料核验日期:2026-10-02。



