

用 AI 拆 VAE 重参数化:随机数固定以后,均值和尺度仍然可以求导
“采样是随机的,所以不能训练”并不是VAE面对问题后的全部结论。把随机来源单独取出来,模型参数仍可通过一条确定的计算路径影响样本。让AI用一个标量展开这条路径,便能检查它有没有混淆方差与标准差。
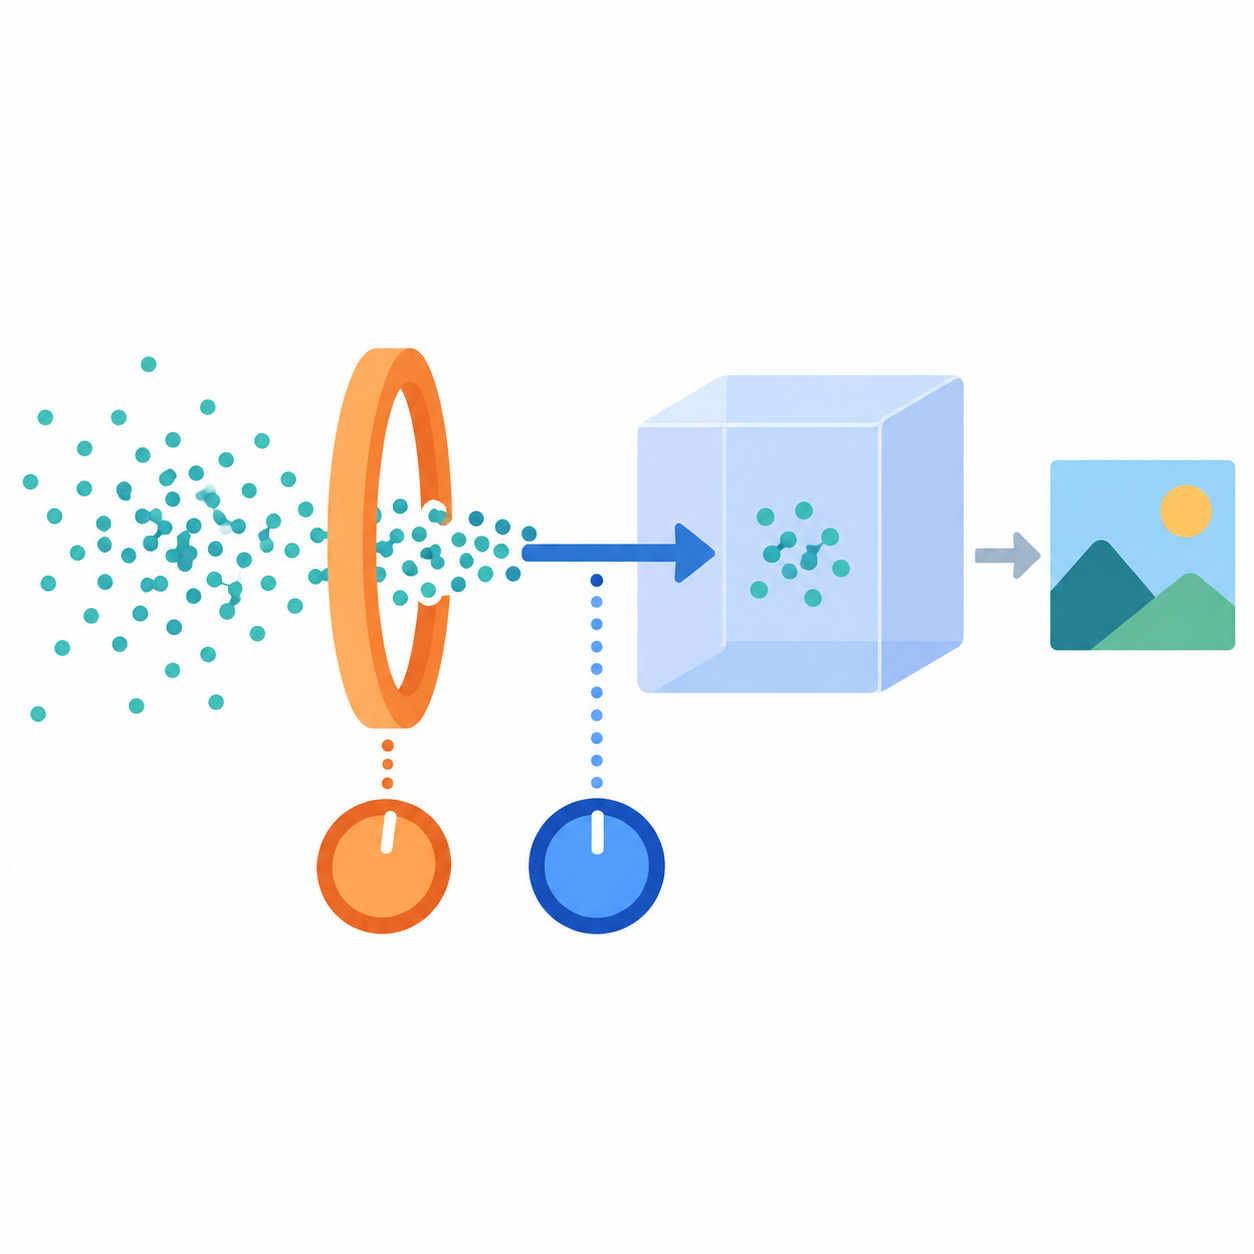
AI模型生成的概念插图:噪声经过尺度与位移控制形成潜变量,再进入解码示意;点云不代表真实样本或实验分布。
把噪声放在参数之外
设近似后验为均值μ=1、标准差σ=2的高斯分布,方差因此是4。原论文的高斯重参数化写成z=μ+σε,ε来自标准正态分布。为复算一条路径,本例指定ε=-0.5,于是z=1+2×(-0.5)=0。指定一个噪声值只是验算,不能用它代表完整分布。
假设解码器在这张教学卡里直接输出z,目标为3,重建损失R=(z-3)²/2。当前R=4.5,R对z的导数为-3。在这次计算中固定ε,z对μ的导数是1,对σ的导数是-0.5,所以重建项对μ与σ的梯度分别为-3和1.5。
随机数仍然存在,但它不必随μ或σ变化而重新抽取。做局部数值核验时,也要在参数加减微小量的两次计算中复用同一个ε,否则差分里混入了不同随机样本,便不是在检验这条路径的导数。
网络给的是 logvar 时,需要先开半个指数
一些编码器输出对数方差ℓ=ln(σ²)。本例ℓ=ln4,要得到标准差应算exp(ℓ/2)=2;若误算exp(ℓ)=4,再拿它乘噪声,就会把z算成-1,等于用了另一份方差。
沿正确路径,z对ℓ的导数为0.5σε=-0.5,所以R对ℓ的梯度是1.5。虽然这个数碰巧与本例对σ的梯度相同,两者不是同一个变量;换σ以后就未必相同。验收时应写变量名与转换式,不能只看数字对上。
单次梯度和整个期望不是同一张账
对这个特意简化的平方重建式,可直接算期望:E[R]=((μ-3)²+σ²)/2=4。期望对μ的导数是μ-3=-2,对σ的导数是σ=2。它们与这一次噪声对应的[-3,1.5]不同,属于正常的采样波动,并非重参数化失效。
若先验为标准正态,本例一维KL为(μ²+σ²-1-lnσ²)/2,约1.306852819。它可解析计算,不应拿一次抽到的z=0就宣布KL为0。VAE完整目标还包含分布约束;只列重建损失4.5,并不能代表全部负证据下界。
让AI交付时可要求两份结果:固定ε的采样路径及导数,以及这个特殊二次例子的解析期望。再用中心差分分别检查μ、σ和ℓ,明确每次究竟固定哪些变量,避免对σ扰动时又同时独立改动ℓ。
这里的恒等解码器只是用于算清机制,真实解码器通常是神经网络;离散潜变量也不能无条件套用同一高斯变换。重参数化提供可微的采样表达,并不会自动保证近似后验足够准确或生成质量良好。
资料核对日期:2026年10月2日。算例为原创教学设定,已用独立Python计算复核,不代表真实模型训练或性能测试。



