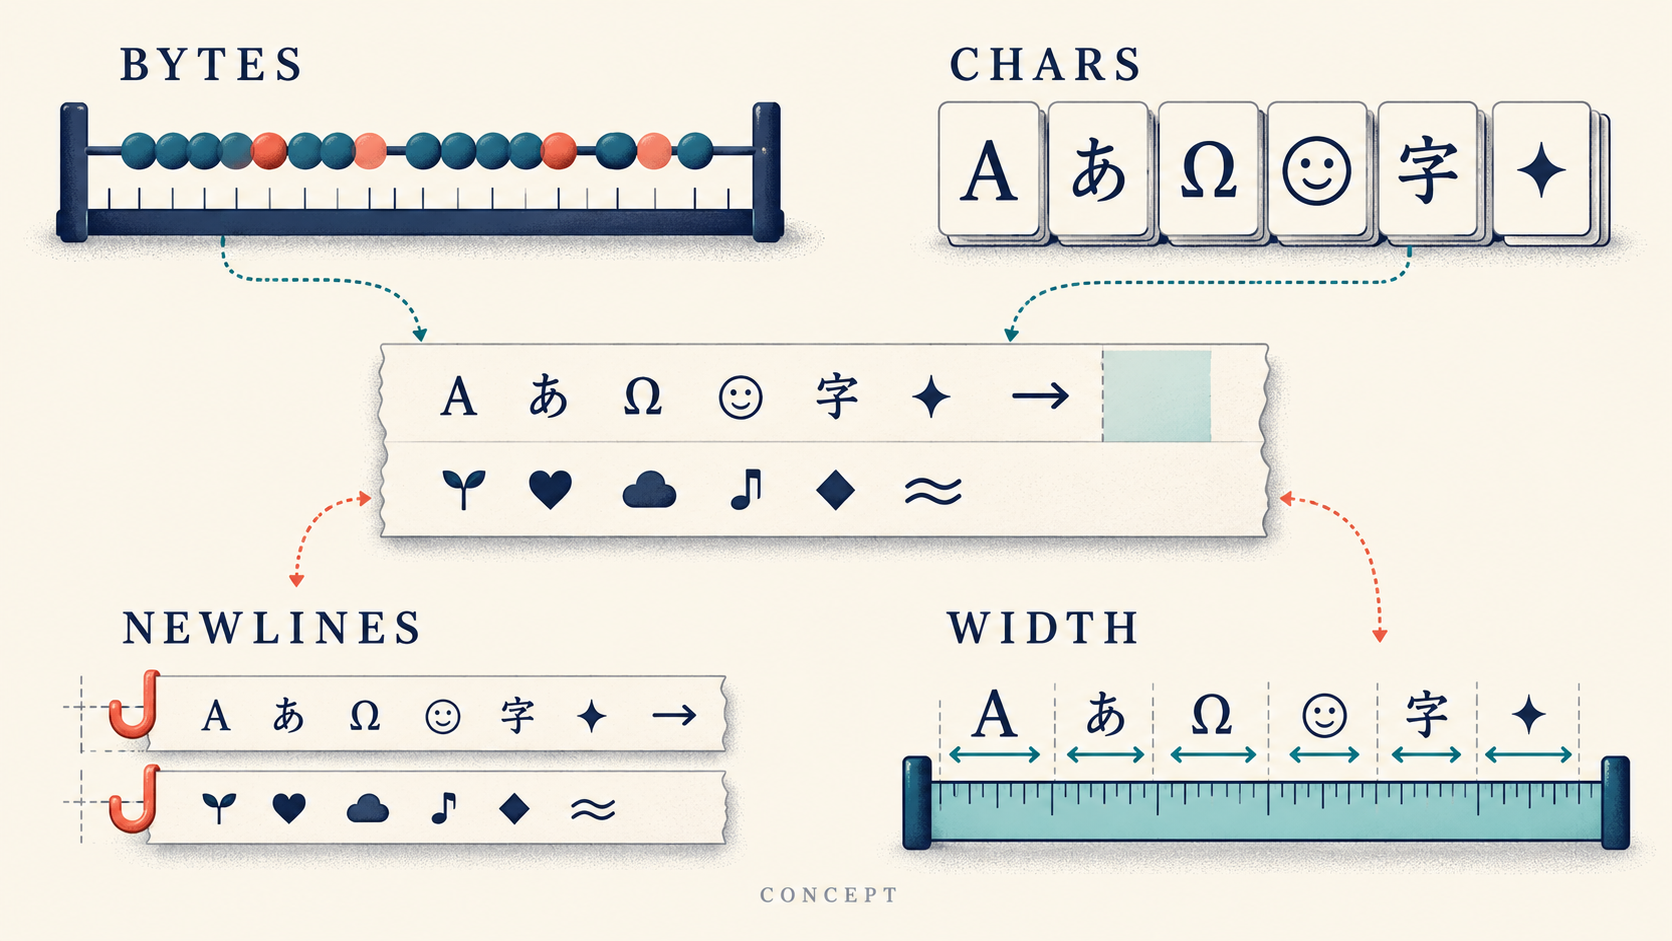
GNU wc 的四种计数:最后一行没有换行,行数为什么少一 上传一份两行文本,编辑器看见两条记录,wc -l却只报一;再换成wc -m,数字又和文件大小不同。这几种结果可以同时正确,因为它们回答的是不同问题。只有先规定记录怎样结束、文本怎样编码、宽度怎样计算,计数才能成为验收... yunqueblog/ 技术教程/ 2026-10-03/ 4 阅读
GNU split 按行切分验收:最后一行没有换行,怎样确认重组后仍是原文件 大文本分批处理后,分片数量看起来正确,合回去却可能因为顺序、旧文件混入或换行处理而变化。只检查“每片能打开”不足以证明拆分无损。本例用一个最后没有换行的中文小文件,从分片清单到字节重组建立完整验收,先把边界讲清再放大... yunqueblog/ 技术教程/ 2026-10-03/ 4 阅读
TextEncoder.encodeInto 的容量边界:还剩三个字节,为什么表情一个字节也没写入 把字符串写进固定容量的Uint8Array时,缓冲区还剩空间,并不表示编码器会把下一个字符切开塞进去。encodeInto要为一个码点写入完整UTF-8序列;如果剩余容量不足,就在该码点之前停止,并报告本次读了多少输... yunqueblog/ 技术教程/ 2026-10-02/ 3 阅读
Python surrogateescape 往返:字节不是合法 UTF-8,怎样保留它而不替换成问号 有些工具需要把带有少量非法字节的旧日志读进来,检查能识别的部分,再原样写回。errors="replace"虽然能让读取继续,却已经把出错字节换掉;等到保存时,原来究竟是FF还是另一个字节就无法从替代符号还原了。su... yunqueblog/ 技术教程/ 2026-10-02/ 3 阅读
TextDecoder 的 ignoreBOM:设为 true,为什么开头反而多出一个不可见字符 读取带 UTF-8 BOM 的短文本时,开发者把 ignoreBOM 设为 true,期待忽略文件开头的标记,字符串却多了一个 U+FEFF。这个名字容易被理解反了:true 会忽略BOM的特殊处理,使对应字符进入结... yunqueblog/ 技术教程/ 2026-10-02/ 2 阅读
Python UTF-8 分块解码:字符跨过读取边界时,怎样保留未完成字节 读取日志流时,英文测试完全正常,换成中文就偶发 UnicodeDecodeError,常见原因是把每次收到的字节块直接解码。读取边界由缓冲区决定,未必落在字符边界上。某一块末尾只含一个字符的前半段,并不能直接说明原数... yunqueblog/ 技术教程/ 2026-10-01/ 4 阅读


 yunqueblog