最新Double Q如何拆开选择与估值:挑中的最高数,不能再给自己打分 在强化学习里,下一状态的最高动作价值经常被拿来构造学习目标。如果每个动作的估计都有噪声,“选择最高估计”会偏向碰巧偏高的那一项。Double Q的关键动作是让一份估计选择动作,再让另一份估计评价这个已选动作。两份数组... yunqueblog/ AI分享/ 2026-10-04/ 2 阅读
最新REINFORCE减去基线以后:梯度均值不变,方差为什么反而可能更大 策略梯度实现里常出现“奖励减去基线”。这个减法允许改变样本更新的波动,同时保留想估计的梯度,但前提和数值效果要分开检查。基线满足无偏条件,并不代表它一定降低方差。下面只研究一个单状态、执行一次动作就结束的任务,让所有... yunqueblog/ AI分享/ 2026-10-04/ 2 阅读
让 AI 算 PPO 裁剪项:概率比同样超界,优势符号为何改变结果 看到PPO公式里的clip,容易让AI把所有超界的概率比都替换成边界,算完便结束。但原式还要比较裁剪前后两项,优势的正负会改变哪一项被保留下来。四格手算比一句“限制更新幅度”更能说明这件事。 yunqueblog/ AI分享/ 2026-10-02/ 3 阅读
用 AI 核对 Q-learning 目标:回合已经停了,未来价值为何有时还要算 强化学习日志里出现“这一回合结束”,可能是任务已经到达终止状态,也可能只是采样器用完了本次时间。让AI解释更新公式时,若把两者都写成“未来价值归零”,就会把两个学习问题混在一起。 yunqueblog/ AI分享/ 2026-10-02/ 3 阅读
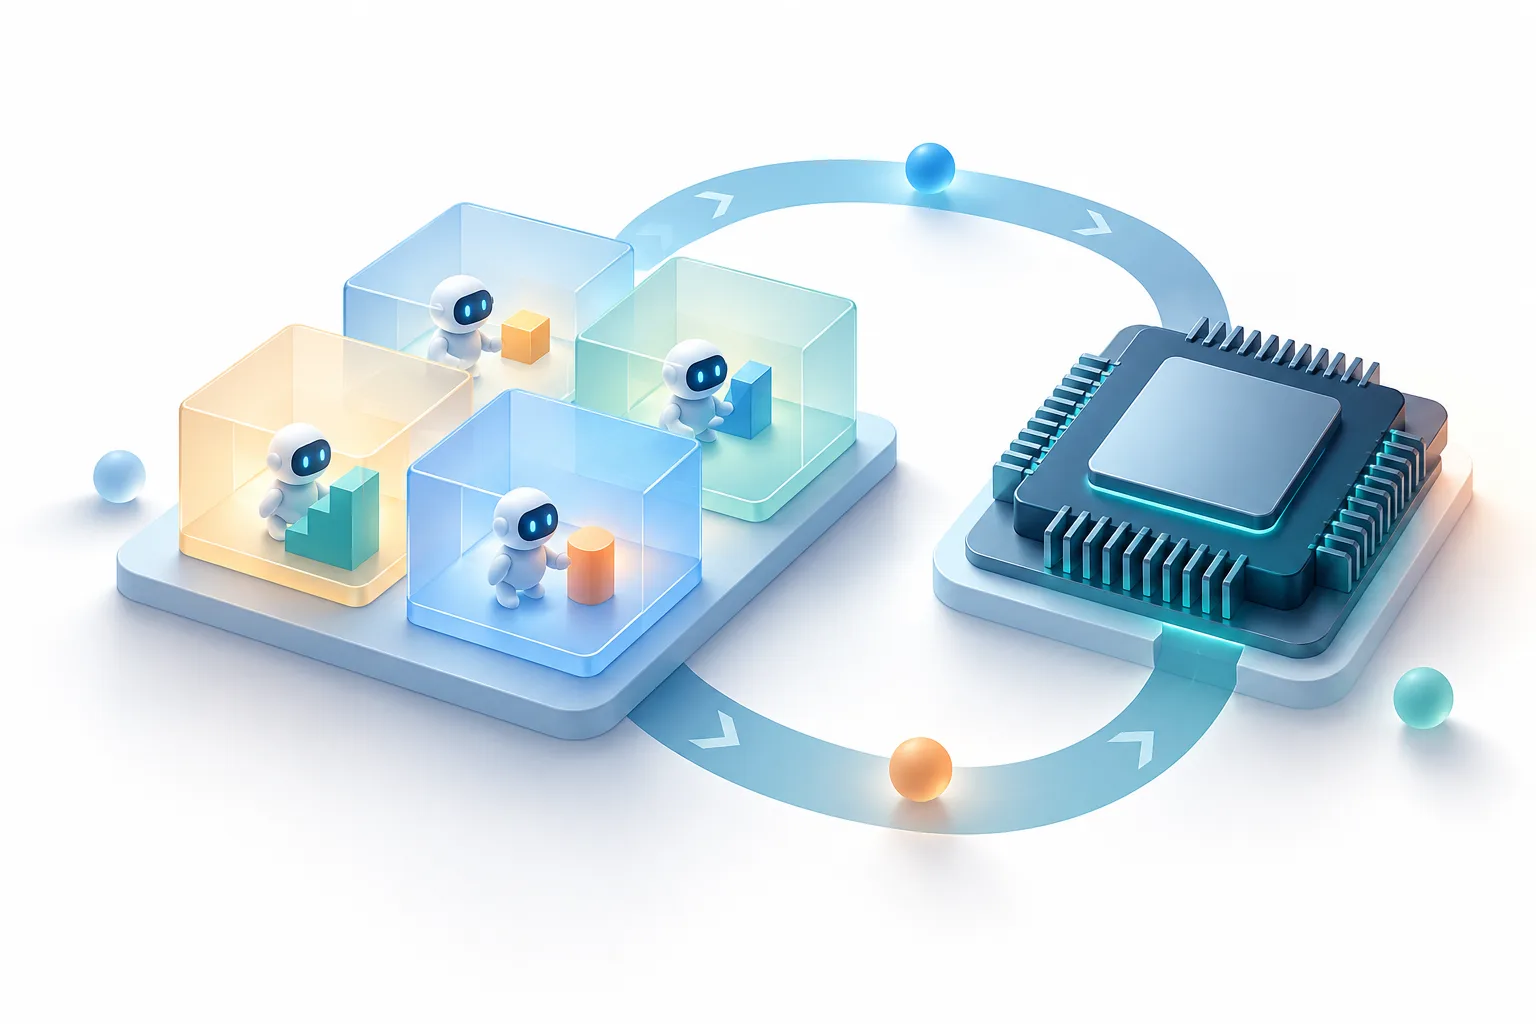
GKE发布面向强化学习的沙箱编排SDK:正式可用,性能数字对应特定基准场景 2026 年 9 月 29 日,Google Cloud 宣布针对强化学习与评估场景优化的 GKE Agent Sandbox、配套编排 SDK 及相关工具集成正式可用。本次更新关注智能体执行环境的准备与复用:模型产... yunqueblog/ 最新资讯/ 2026-10-01/ 4 阅读


 yunqueblog