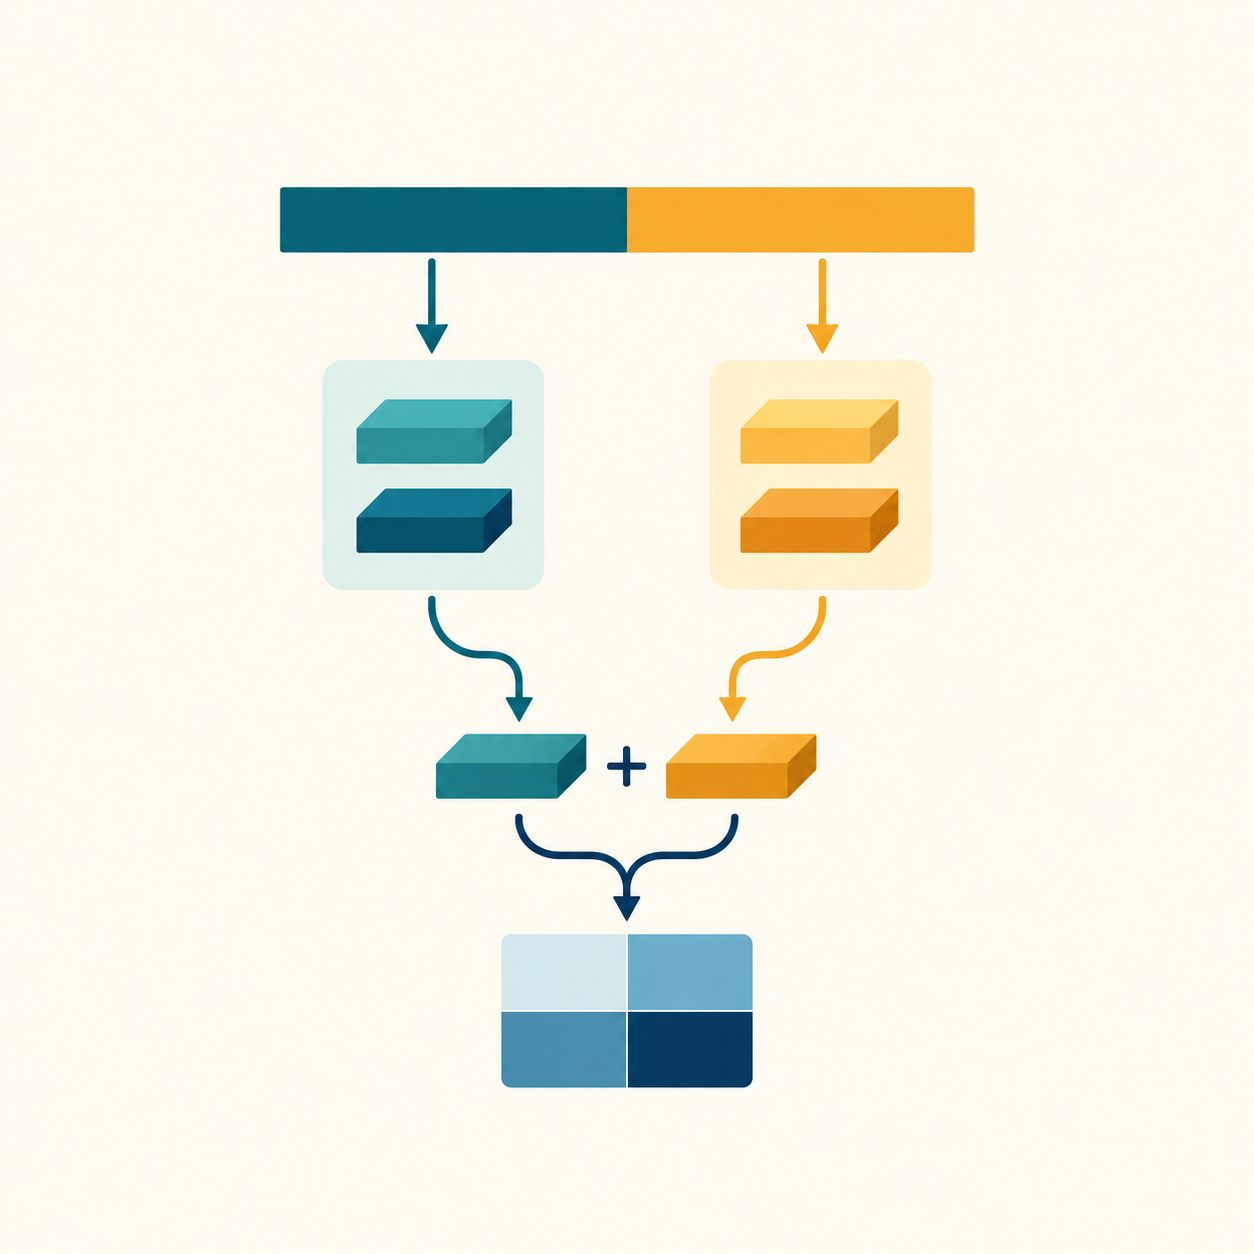
让 AI 算无分类器引导:系数大于一,为何结果越过条件预测 调整扩散模型的引导强度时,容易把它想成“无条件结果和有条件结果混合的比例”。但常用CFG系数大于1,已经是外推。让AI只算两维预测,可以看见结果为什么不必落在两份输入之间。 yunqueblog/ AI分享/ 2026-10-02/ 2 阅读
用 AI 查乘积量化距离表:两个向量代码相同,真实距离为何差很远 向量检索中的乘积量化,常被简称为“把浮点向量压成短码”。要知道短码为什么能用来估距离,可以让AI把四维向量切成两段,各自查一个小码本,再亲手把两张距离表的结果加起来。 yunqueblog/ AI分享/ 2026-10-02/ 2 阅读
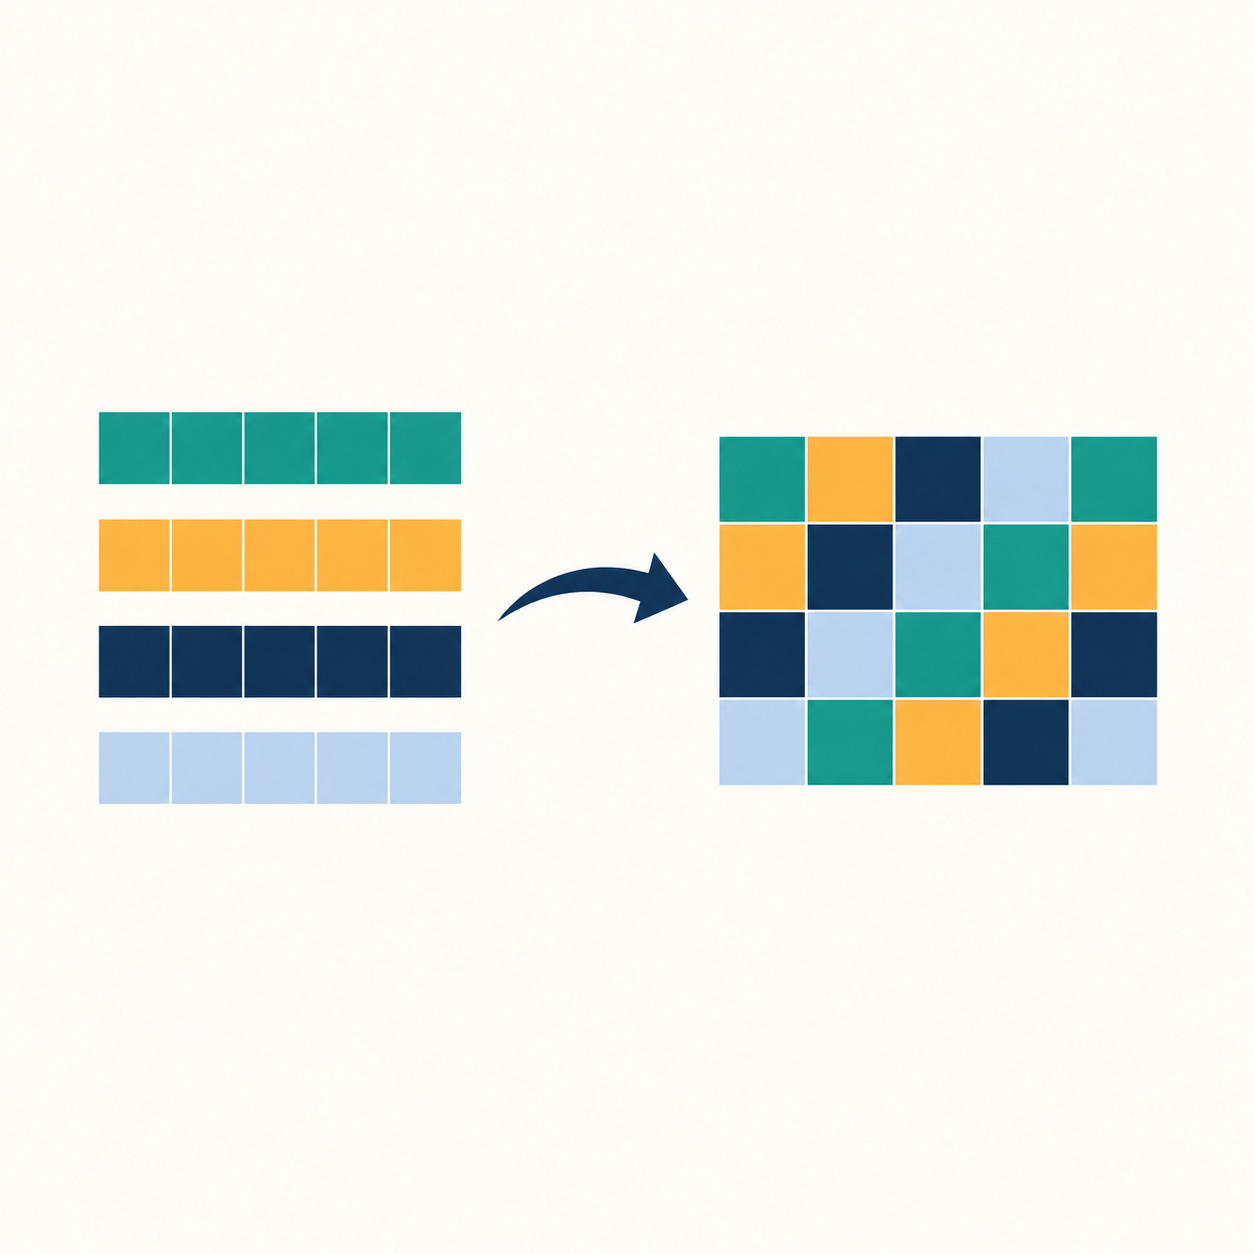
让 AI 排一次 PixelShuffle:画面变大,为什么元素总数没有增加 看到超分辨率模型里的PixelShuffle,AI可能解释成“每个像素放大成四块”。这个算子实际上把通道中的已有元素搬到更大的空间网格。八个互不相同的数字就足以检查它有没有复制、插值或只是错误地改了形状。 yunqueblog/ AI分享/ 2026-10-02/ 3 阅读
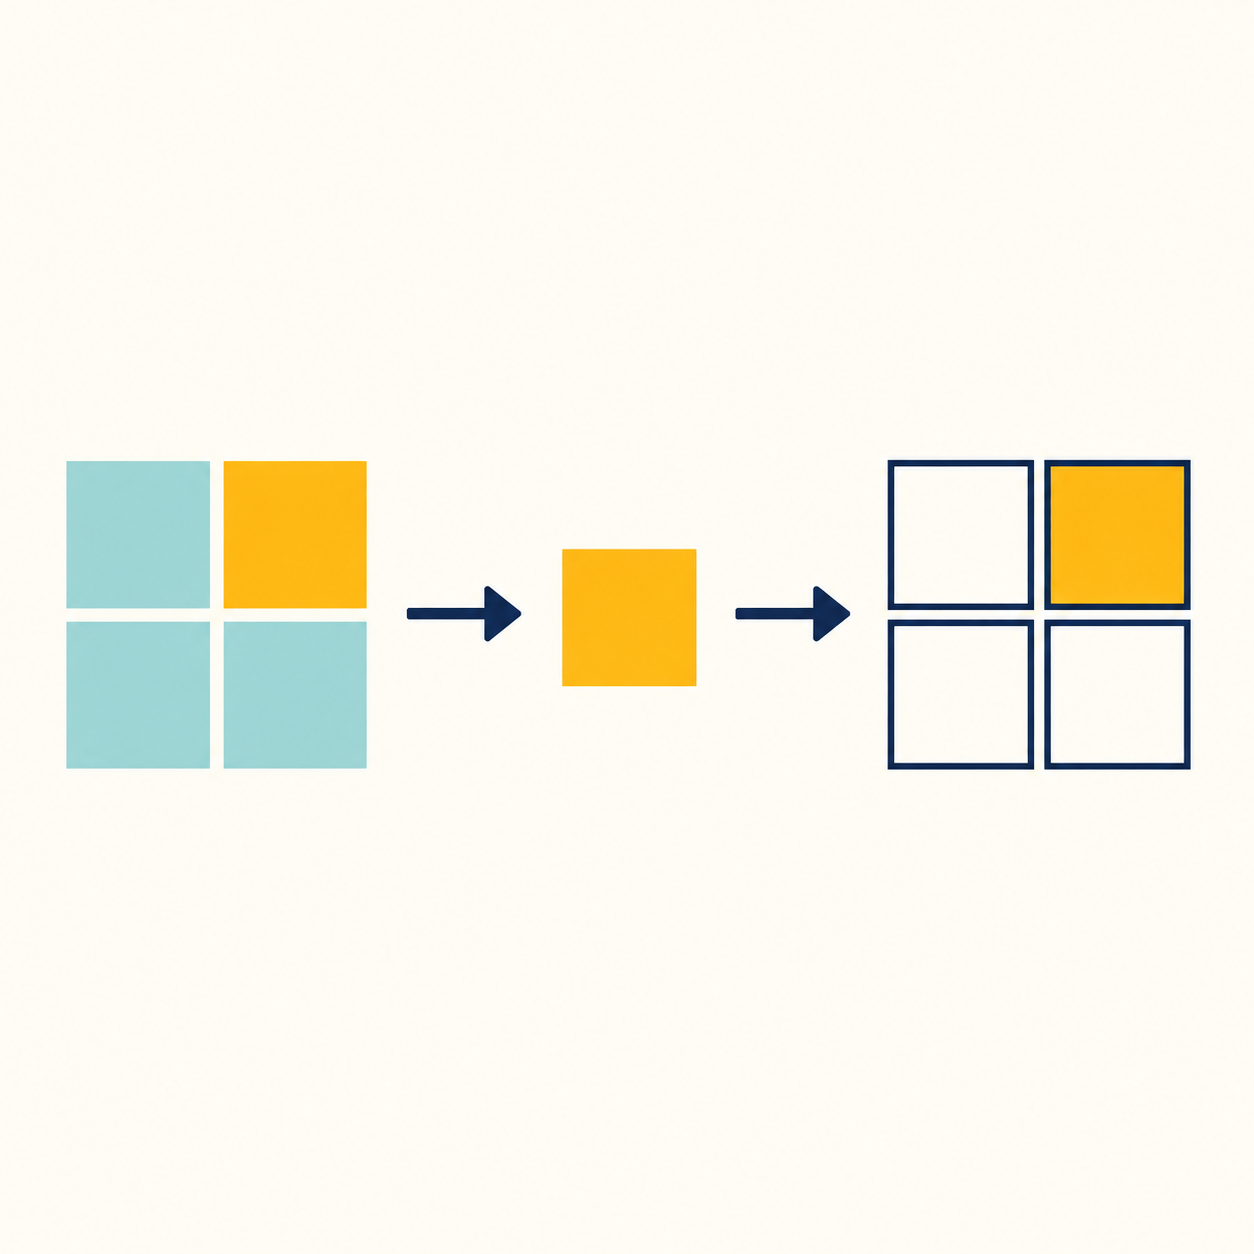
用 AI 还原最大池化:位置索引还在,较小的值为何回不来 最大池化把一片区域变成一个最大值。如果同时保留最大值的位置,反池化是否就能恢复原图?答案仍是否定的。让AI给一张小网格做来回转换,可以直接看见“知道放回哪里”和“知道原来所有内容”之间的差别。 yunqueblog/ AI分享/ 2026-10-02/ 2 阅读
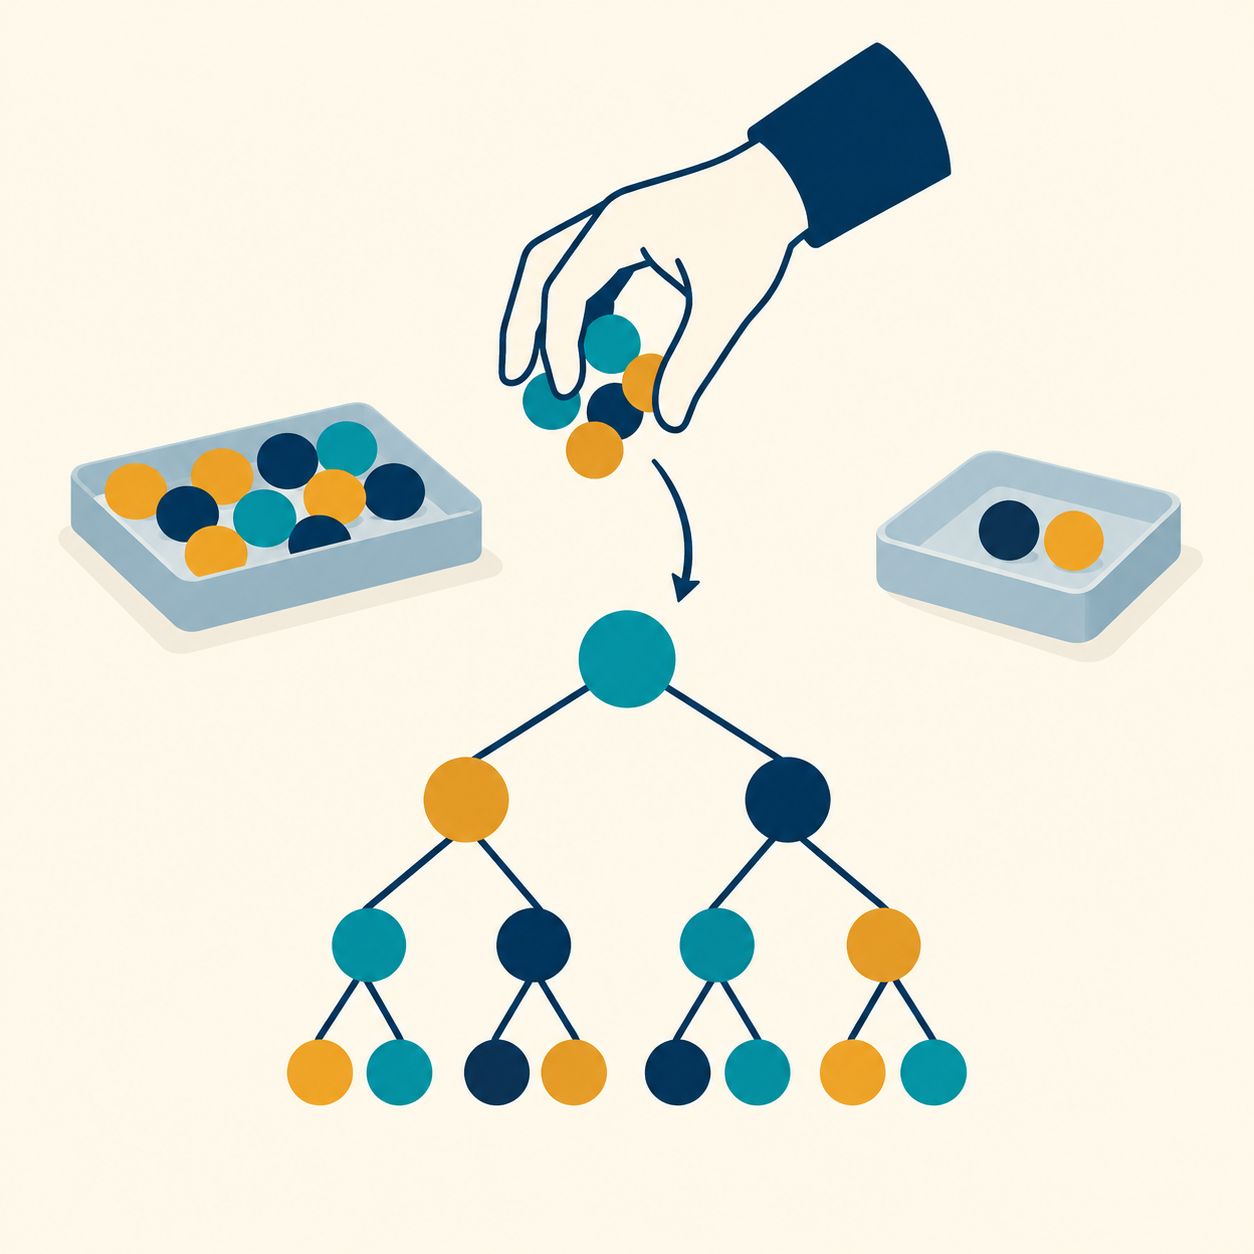
让 AI 数随机森林的袋外样本:抽了五次,为何还有记录一次没见过 随机森林的一棵树可以抽取与原数据同样多的训练记录,但“抽了五次”并不等于“五条都见过”。有放回抽样允许重复,留下的袋外记录正是理解OOB评估的入口。让AI把每次抽取和最终不同ID分开列,问题会清楚许多。 yunqueblog/ AI分享/ 2026-10-02/ 2 阅读
用 AI 记一轮 AdaBoost:同样错一张卡,下一轮错误率为何不同 比较两个分类器时,只数各自错了几条记录,有时会遗漏AdaBoost正在使用的样本权重。四张卡经过一轮更新后,单独一张错例可以占去一半权重,下一轮“错一张”的含义也就不同了。 yunqueblog/ AI分享/ 2026-10-02/ 2 阅读
让 AI 走一遍 DBSCAN:边界点碰到两群,为何不能把它们连成一群 看见两堆点中间有一颗连接点,AI可能直接把它们解释成同一个DBSCAN簇。但DBSCAN扩展簇时,能够继续传播的是核心点。中间点若只是边界点,即使同时靠近两边,也未必能将两簇合并。 yunqueblog/ AI分享/ 2026-10-02/ 2 阅读
用 AI 算高斯混合责任度:两个中心相同,为何归属仍不各占一半 如果AI把高斯混合模型解释成“看点离哪个中心近”,它便漏掉了分布的宽度。可以把两个中心设成完全相同,让距离失去区分能力,再检查模型如何用概率密度给出不同责任度。 yunqueblog/ AI分享/ 2026-10-02/ 2 阅读
让 AI 分清 HMM 的求和与最大值:最佳路径为何不是观测的全部概率 让AI解释隐马尔可夫模型时,“最可能”很容易把两件事混在一起:一串观测整体有多可能,以及哪条隐藏路径最可能产生它。前者要把路径概率加起来,后者只取一条最大路径。两步小例足够把差异算清。 yunqueblog/ AI分享/ 2026-10-02/ 2 阅读
用 AI 核对 DPO 偏好比:喜欢的回答概率更高,为何损失仍然不小 看到DPO中的胜出回答和落选回答,容易只问“胜出回答的概率是否更高”。标准DPO还要看这组相对偏好相比参考策略改变了多少。把完整回答缩成两个事件,就可以用普通分数验算这个差别。 yunqueblog/ AI分享/ 2026-10-02/ 2 阅读


 yunqueblog