

用 AI 记一轮 AdaBoost:同样错一张卡,下一轮错误率为何不同
比较两个分类器时,只数各自错了几条记录,有时会遗漏AdaBoost正在使用的样本权重。四张卡经过一轮更新后,单独一张错例可以占去一半权重,下一轮“错一张”的含义也就不同了。
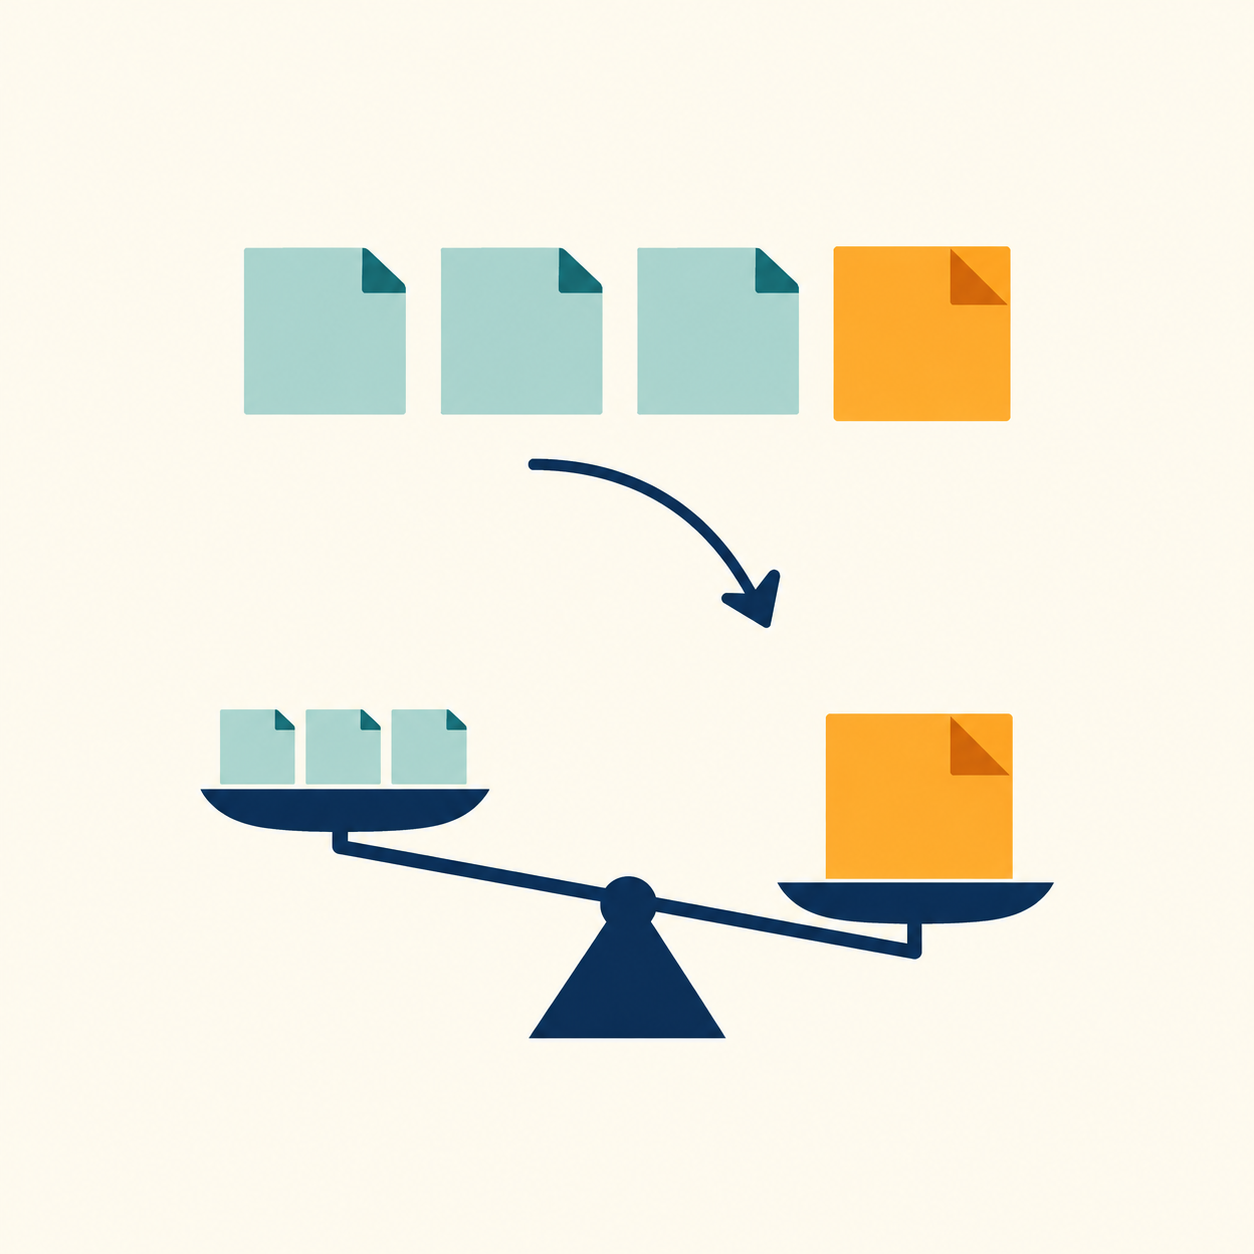
AI模型生成的概念插图:一次判断之后,样本对下一轮的影响重新分配;天平倾斜与卡片面积不是精确权重比例,也不是训练截图。
固定二分类的一个明确版本
本例采用标签与弱分类器输出都为-1或+1的经典二分类AdaBoost。四张卡编号1到4,初始样本权重均为1/4。给定第一轮弱分类器h₁只把第4张判错,其余三张正确;我们直接使用这些判断,不运行决策树训练。
加权错误率ε是所有错例权重之和,所以本轮ε=1/4。分类器在最终组合中的系数α=(1/2)ln((1-ε)/ε),得到(1/2)ln 3,约0.549306。这个α属于分类器,和四张训练卡各自的样本权重不是同一种量。
先更新,再统一归一化
正确卡的旧权重乘exp(-α),错误卡乘exp(α)。由于exp(α)=√3,三张正确卡的未归一化权重各约0.144338,错误卡约0.433013。四项相加的归一化因子Z约0.866025。
每项除以Z后,新样本权重为[1/6,1/6,1/6,1/2]。四个数加到1,前三张合计1/2,第4张也占1/2。只把错误卡乘大而不归一化,会留下另一套数,不能直接将其当作下一轮已经归一的错误概率。
再检查一个比值:错误卡与任意正确卡原来同权,更新后是三倍。这个三倍来自exp(2α)=3;它与第4张的新权重“从1/4到1/2、变两倍”并不矛盾,一个比较卡与卡,另一个比较同一卡前后。
两位候选都错一张,代价却不同
下一轮候选h₂只错第1张,候选h₃只错第4张。按普通计数,两者错误率都是1/4;按当前分布,h₂的加权错误率为1/6,h₃为1/2。前者的经典系数是(1/2)ln 5,约0.804719;后者系数为0,在这一轮没有带来优于随机水平的加权分类表现。
因此不能把第一轮的1/4一直沿用到以后。让AI给每轮都写“本轮进入的权重、错例ID、加权错误率、α、更新因子、归一化结果”,人工按错例ID求和,即可检查它是否仍在偷偷数卡片。
最终预测要把各轮α乘对应弱分类器输出后求和,再取符号;样本权重用于影响下一轮学习,不直接作为新输入的投票系数。本文只算到第二轮候选比较,没有编造一个已训练完成的集成模型。
此处限定的是二分类半对数版本;多分类SAMME及不同学习率约定会有不同系数形式。ε=0时还需处理无限系数的边界,不能直接代入本例步骤。持续被判错的卡也可能是坏标签,提高其权重并不保证泛化更好,仍要用独立数据检查最终系统。
资料核对日期:2026年10月2日。算例为原创教学设定,已用独立Python计算复核,不代表真实模型训练或性能测试。



