

让 AI 检查蓄水池抽样:只留两条记录,先到的数据为何仍有公平机会
持续到来的模型评测记录或训练回放候选,可能多到无法全部留存。如果希望保留全历史的均匀小样本,只保存最近几条会偏向后来的数据,最先装满后不再更新又会偏向早期数据。蓄水池抽样用固定容量,在尚不知道最终长度时维持明确的抽样概率。
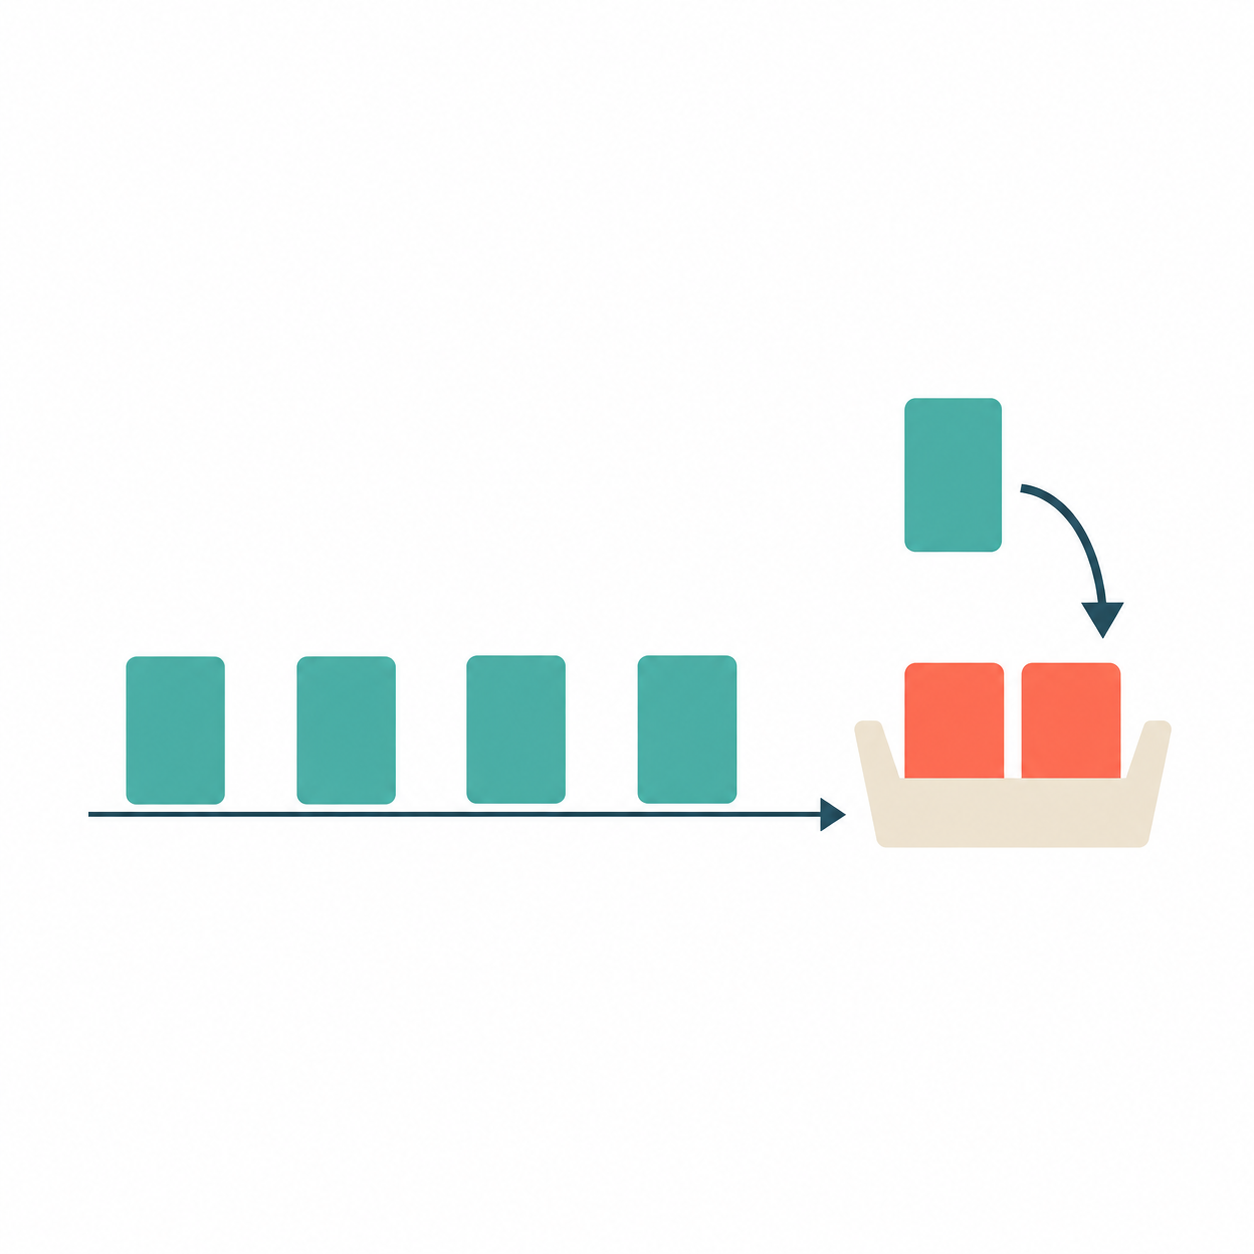
AI模型生成的概念插图:连续到来的卡片可能替换固定容量中的记录;不是具体抽数轨迹、真实数据或软件界面。
新来的记录不一定要留下
设容量k=2,数据按A、B、C、D依次到来,记录身份互不相同。先把A和B装入两个槽位。第t条记录到来时,从1到t等概率抽一个整数j;若j不大于2,就让新记录替换第j个槽位,否则忽略这条新记录。每次抽数相互独立。
C是第3条,所以抽1、2、3各有1/3机会。抽1变为[C,B],抽2变为[A,C],抽3仍为[A,B]。D到来时改为从1到4抽数,只有抽到1或2才进入,因此它当下入选的机会是2/4。
常见错误是每次都从现有两个槽位中随机选一个替换。那会让新来的D必然在池内,早期记录却不一定在,显然不是全历史等机会。随机选择替换位置,只解决“换掉谁”,没有解决“是否应该换”。
旧记录先入选,再计算能否留下
处理完C时,A在池内的概率是2/3。到D时,若A仍在某个槽位,只有恰好抽中那个槽位才会删除它,概率为1/4,所以存活概率为3/4。两步相乘,A最终留下的概率为(2/3)×(3/4)=1/2,恰好与D相同。
一般地,若处理t-1条后每个旧记录入选概率为k/(t-1),下一步它存活的条件概率为1-1/t。相乘得到k/t;新记录也因j不大于k而以k/t进入。先到者经历更多轮替换,同时也享有较早较高的入选机会,两部分正好平衡。
单条机会相同,还要看整组样本
本次程序把C到来时的3种抽数与D到来时的4种抽数组合全部枚举,共12条等可能路径。忽略槽位顺序,最终AB、AC、AD、BC、BD、CD六种两条子集各出现2次,所以每个子集的概率都是1/6,每条记录入选概率均为1/2。
枚举时必须使用当时池中的内容。例如先抽1把A换成C,再抽1会把C换成D,结果是[D,B],不能一直把第一个槽位当成原始A。记录路径和当前槽位,可以检查AI是否把对象身份与位置混淆。
这类抽样对记录位置公平,并不自动对类别、用户或时间段公平。某一类出现得更多,就会占更多历史记录;重复上报也会按多条记录参加。若任务需要各类均衡或更偏重近期数据,应选择相应规则,而不能继续沿用“所有历史记录均匀”的解释。
此外,小样本可能完全漏掉稀有错误,不能把两条记录当可靠评测集。实际实现要维护已处理总数t、稳定记录ID与随机源;恢复处理中断时,计数与池内容也要一致。这份四条记录的练习验证抽样机制,不证明任何模型的性能或训练收益。
资料核对日期:2026年10月2日。算例为原创教学设定,已用独立程序复核,未进行真实模型训练或效果测试。



