随机投影保住的是哪种距离:平均正确,单次仍可能把两点压成同一点
把向量从几千维压到几百维时,人们常用“随机投影大致保距离”解释其作用。但这句话漏掉了三个问题:保的是距离还是平方距离,是固定两点还是整份数据,以及保证来自平均还是高概率。一个二维到一维的小例,足以让这三个层次分开。
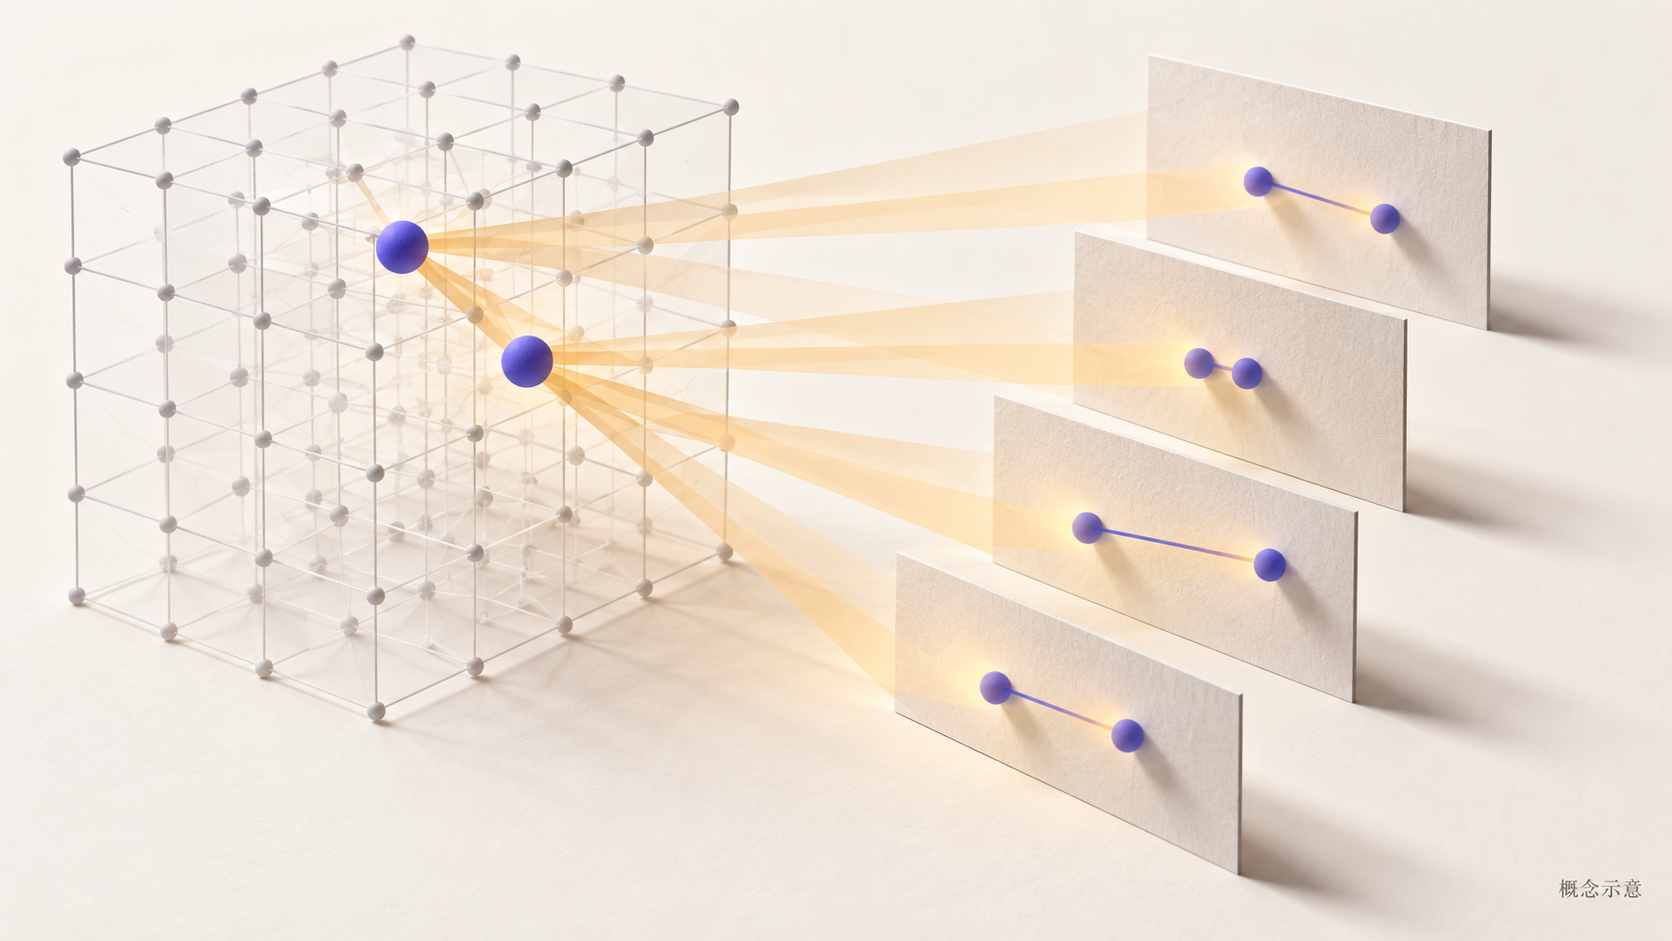
AI生成的概念示意图:同一对点在不同随机映射下留下长短不同的影子;影子并非正文投影矩阵的准确几何图。
一个随机符号就能看见失真
设两点之差为v=(1,1),原平方距离为1²+1²=2。采用一行投影R=(r₁,r₂),两个符号独立且各以一半概率取+1或-1。投影后的差为r₁+r₂,四种符号组合给出2、0、0、-2,平方距离对应4、0、0、4。
平均平方距离是2,恰好等于原来的值。但单次结果不是翻倍就是归零,没有一次落在2附近。这个例子并不反驳随机投影理论:我们只用一个输出维度,远未满足对给定误差和点集大小所需的维数条件。
注意,平均距离本身是(2+0+0+2)/4=1,而原距离是√2,约1.414214。平方距离的期望正确,并不能通过两边开平方推出距离期望也正确。先求平均再开方,与先开方再平均,是两种不同运算。
两行以后,为什么要除以平方根二
增加到两个输出坐标时,分别独立抽两行符号,并把整张矩阵除以√2。投影平方距离成为两次单行平方结果的平均。16种等概率矩阵中,4种得到0,8种得到2,4种得到4;均值仍是2,方差从单行的4降到2。
这里有一半机会精确保距,同时还有四分之一机会完全压扁这对点。多一行提供了更多独立测量,却没有立刻获得确定性保证。验收不能只展示那8张“正好成功”的矩阵,再把它们当成所有随机输出的代表。
若有k行,且每个元素都以相同规则独立生成,再统一除以√k,本例平方距离可写成4B/k,其中B服从参数为k和1/2的二项分布。它的期望是2,方差为4/k。这个推导只使用本例v=(1,1),不是声称所有向量都恰好具有同一个方差公式。
漏掉1/√k缩放时,平方长度的期望会变成原来的k倍;误除以k则会变成原来的1/k。两种实现都能输出形状正确的低维向量,所以需要直接检查数值比例,不能仅靠维度断言发现错误。
单个点到原点正确,还不足以通过
再看三个点O=(0,0)、A=(1,0)、B=(0,1)。一行符号投影以后,A和B到原点的距离都恒为1,看起来完全正确。然而A与B的投影距离会是0或2,原距离却是√2。只测每个向量自身的范数,可能漏掉数据内部最重要的相对关系。
用差向量检验成对距离更直接,因为线性映射满足R(A-B)=RA-RB。一个测试集应包含重复点、正交点、几乎相同的点与尺度差异较大的点。记录的是“投影平方距离除以原平方距离”的分布;原距离为零时另行确认输出也相同,不应直接进行除法。
还可以测试同一矩阵是否被整个数据集复用。若对每条记录重新抽一张矩阵,即使每条向量的长度在平均上正确,记录之间已经不在同一个坐标系中,近邻搜索就失去了原本要保留的含义。
有限点集保证需要同时看规模和误差
Johnson–Lindenstrauss类结论针对固定的有限点集,通过足够的输出维数,让所有点对的平方距离以高概率落在允许区间。常见维数尺度随点数的对数增长,并随误差容忍度的平方倒数增长。具体常数和失败概率要跟选用的矩阵分布、定理版本一起说明。
这也解释了为什么“原始维度有一万,所以压到十维一定够”没有依据。点数增加时,需要同时控制的点对变多;允许的失真越小,需要的输出维度通常越大。反过来,理论给出的安全维数可能保守,实践效果仍应在与任务一致的验证数据上测量。
任何从较高维映射到较低维的线性变换都有非零零空间,所以不可能对整个连续空间的所有向量都精确保距。有限点集的概率保证不能扩展为“任何未来输入都不会塌缩”。如果后续数据分布改变,应重新检查近邻关系和下游任务表现。
把随机矩阵也当作模型状态
生成投影矩阵后,训练、验证、推断和恢复任务都应使用同一份映射。只保存低维维数而不保存矩阵或可可靠重建它的状态,会让新数据落到另一套坐标里。若采用稀疏随机投影,还须记录非零概率及对应缩放,不能把稠密符号矩阵的规则直接照搬过去。
它适合把高维欧氏几何压缩为更省内存的近似表示,之后仍要检验任务误差。它不会主动选择与标签最相关的方向,也不等同于根据训练数据寻找最大方差方向的主成分分析。本文的穷举可以验证实现与概率含义,但没有展示任何真实数据集上的检索速度或准确率收益。
数据预处理也会重写距离定义
若一个坐标以米表示,另一个坐标以毫米表示,直接欧氏距离可能主要由后者决定。随机投影大致保留的正是输入时那种尺度关系,它不会判断哪个单位更合理。标准化、单位转换或归一化应在定义目标距离时决定,而不是看到投影图不好看以后临时修改。
同样,如果先把所有向量归一成单位长度,再进行映射,原问题已经偏向角度几何。不能把这个流程测得的误差拿去保证未归一化向量的长度关系。一个可靠对照应保存原始表示、预处理后表示和投影后表示,明确距离比较发生在哪两层之间。
若不断抽取随机矩阵,直到验证集上的某个指标最好,再报告那次结果,得到的已经是经过选择的实验。这个选择未必不允许,但应固定选择预算并使用独立测试集评估,不能把最好一次的结果当成未经筛选随机映射的典型表现。保存每次种子和比较条件,能让后来的人知道收益来自降维机制还是调参选择。
资料核对日期:2026年10月3日。数值均为原创教学设定,已用本地独立程序复算;未进行真实模型训练、线上检索或生产性能测试。
参考资料
scikit-learn:Random Projection及Johnson–Lindenstrauss说明
Achlioptas:Database-friendly random projections