随机超平面LSH:六成多的同位率,为什么不等于余弦相似度
两条向量经过同一组随机平面,只保存每个平面两侧的符号,便得到紧凑的二进制指纹。随后比较多少位相同,看起来像在计算余弦相似度。这里恰好有一个重要细节:同位率对应的是角度的线性函数,而余弦是角度的非线性函数。把两者混用,阈值和召回率都会失去原本的解释。
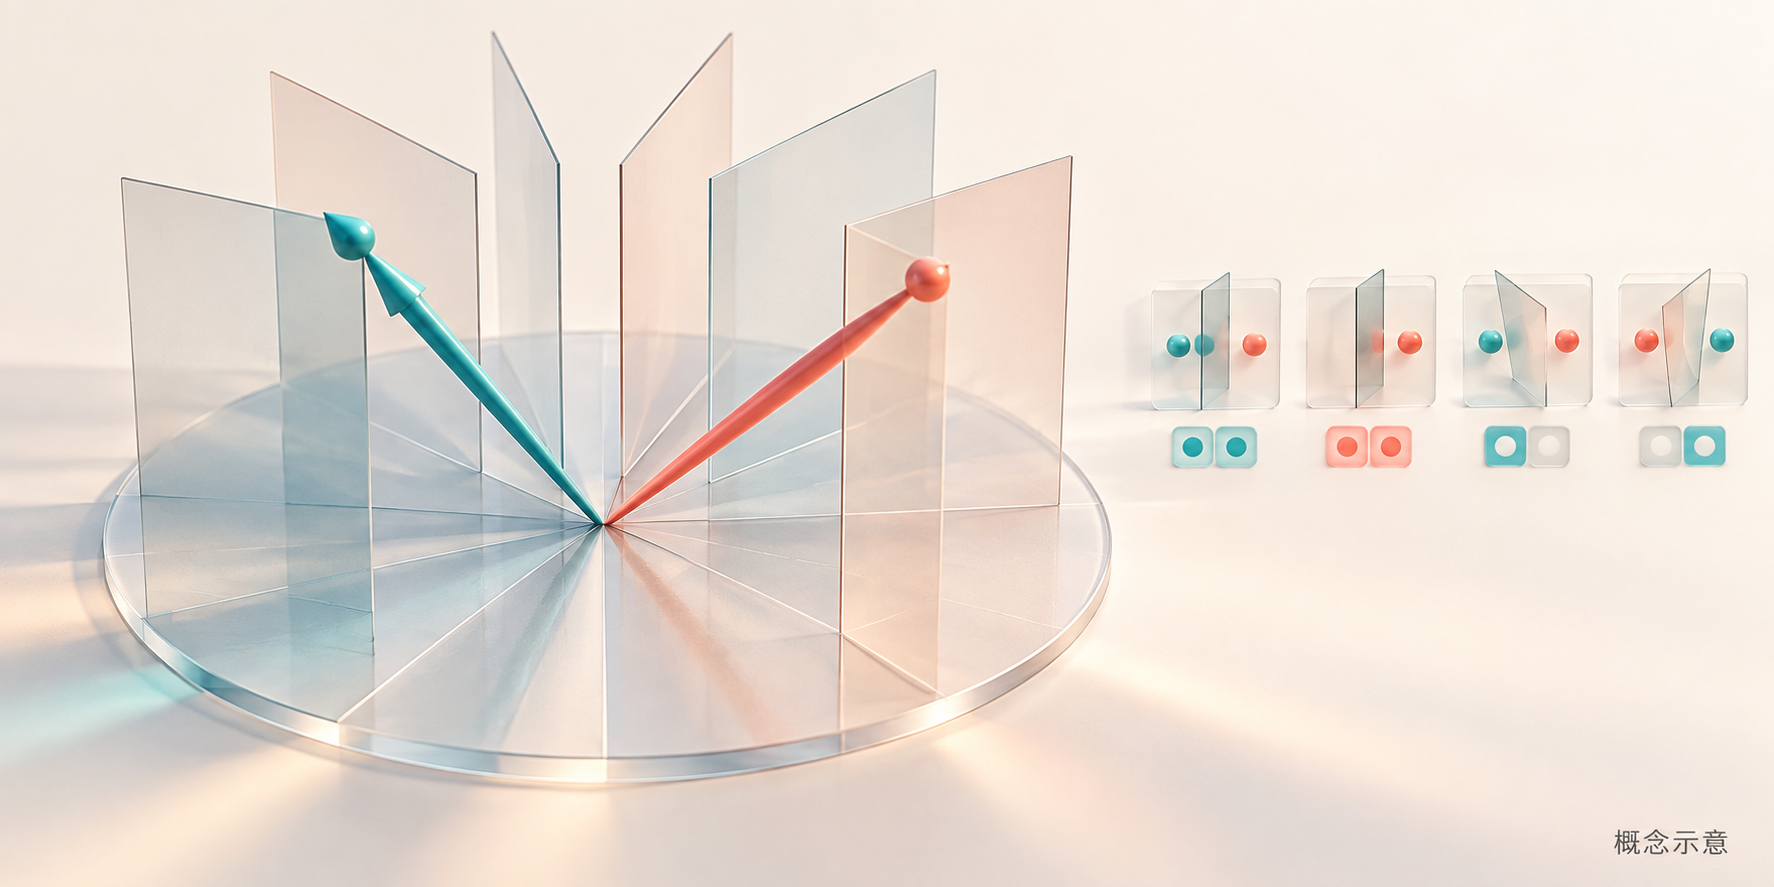
AI生成的概念示意图:两条固定方向的射线被不同平面划分,再形成符号指纹;图中角度与亮灯数量不对应正文计算。
先说清一个比特怎样产生
对非零向量x,随机取方向均匀的法向量r,计算内积r·x。内积非负记为1,负记为0。可以用各坐标独立的标准高斯变量构造r,其方向具有所需的旋转对称性。平面通过原点,因此只改变向量的正比例长度,不会改变该比特。
两条向量夹角为θ时,随机平面把它们分在不同侧的概率为θ/π,位相同的概率为1-θ/π。这里θ使用弧度。平面边界恰好穿过非零向量的事件在连续分布下概率为零;计算机有限精度下仍应固定内积等于零时的规则。
取u=(1,0),v=(1/2,√3/2),它们都是单位向量,夹角为60度,也就是π/3。余弦相似度是1/2,而一个比特相同的概率是1-1/3=2/3。把约0.666667的同位率直接写成“余弦相似度约0.666667”,便是在报告另一种量。
先估计角度,再讨论余弦
假如m个独立平面得到d个不同位,角度的自然估计为πd/m。再求cos(πd/m),可以形成余弦估计。这个后续非线性变换一般不保留无偏性;不能因为不同位比例对θ/π无偏,就声称余弦估计也完全无偏。
例如对上述60度向量,只用一个比特。若同位,角度估计为0,余弦估计为1;若异位,角度估计为π,余弦估计为-1。两种结果的概率为2/3和1/3,所以余弦估计的期望是1/3,并非真实的1/2。少量比特的离散误差在这里一目了然。
作为确定性核验,可以在二维里按所有符号改变的位置切分一整圈法向量角度,逐段累加同侧区间长度。对60度例子得到整圈的2/3,对90度得到1/2,对反向向量得到0。这个区间积分检验的是概率公式,不是挑几个好看的随机种子。
把四个位拼成键,近点也可能漏掉
相似度估计通常比较全部位的汉明距离;哈希检索则常把r个位拼成一个桶键,要求全部相同才把两条记录放到同一候选桶。若各位独立,单表碰撞概率由p变成p的r次方。两个过程共享比特构造,但不能共享同一个概率数字。
取每表4个位。60度这对向量的p为2/3,所以单表进入同一桶的概率为(2/3)⁴=16/81,约0.197531。原来单个位接近三分之二的相同机会,拼接后只剩不到两成。提高桶键长度能减少拥挤,也会排除一部分本来想找到的近邻。
再建立8张彼此独立的表,只要任意一张发生碰撞就纳入候选。候选概率为1-(1-p⁴)⁸。本例约为0.828040。它说明这一个给定点对在随机建表下的入选概率,并不直接等于整个真实检索系统的召回率。
对夹角90度的另一对向量,p=1/2,单表概率为1/16,8表的候选概率约为0.403281。由此能看见取舍:多表帮助召回60度邻居,同时也让不少更远的记录进入候选。不能只展示前一个百分比而隐藏后一个。
独立性和最终重排各管一层
若8张表复用了完全相同的4个平面,候选事件其实只有一个,概率仍是16/81。表名不同、文件不同,不等于随机性独立。若共享部分比特,上述简单的多表公式也需要重新检查,不能机械代入表数量。
进桶仅表示通过粗筛,不能替代原空间的精确相似度计算。候选集合应去重,再用原始向量或经过验证的精排表示计算所需指标,按业务阈值输出。把同桶记录全部当成语义重复,会将随机碰撞误变成确定性判断。
零向量没有可定义的夹角。即便代码会把所有零内积记为1,也不能由此得出“它和某类向量完全相似”。应给零向量单独的处理路径,并检查缺失嵌入、全零特征或失败编码是否混入了索引。
让验证记录对应实际部署问题
给AI的复核任务可以分三层:用已知夹角检查单个位的理论概率;检查r与表数改变后的候选概率;在固定验证集上统计候选量、目标近邻召回与精排耗时。前两层能抓公式和随机数复用错误,第三层才回答是否值得部署。
随机超平面方法天然面向角度关系,对正比例长度不敏感。如果任务关心向量模长,例如未归一化内积检索,仅凭这种指纹无法完整表达目标。先确定相似度定义,再选择索引,比把任何二进制哈希都叫作“语义相似度”更可靠。
别把随机法向量换成另一种分布
在二维例子里,可以直接让法向量角度在整圈均匀分布,作为标准高斯构造的几何对照。若只让两个坐标各取正负一,法向量只剩四个方向,不再具有连续旋转对称性。它虽然也用了随机符号,却不能因此直接套用一减夹角除以π的碰撞公式。
把输入向量和所有法向量一起旋转,内积符号应保持不变;只旋转输入而保留一张已抽好的索引,则有限比特结果可以改变。理论旋转不变说的是随机分布层面的性质,不是每个已经固定的短指纹都完全不受坐标方向影响。这一区分可以避免对随机测试写出过强断言。
建表以后还应保存法向量顺序与比特打包顺序。向量值完全相同,但一端按高位到低位打包、另一端按低位到高位打包,会导致桶键不同;数值算法本身没有错,协议却已经不兼容。用一组固定输入导出完整内积、符号和最终字节,是定位这类跨语言问题的有效方式。
内积接近零的位对舍入更敏感,量化向量或更换数值精度时应把它们纳入回归样本;不能仅凭哈希长度未变就认定索引可以原样复用。
资料核对日期:2026年10月3日。数值均为原创教学设定,已用本地独立程序复算;未进行真实模型训练、线上检索或生产性能测试。
参考资料
Charikar:Similarity Estimation Techniques from Rounding Algorithms