MinHash为什么要共用随机顺序:两个集合各自洗牌,碰撞率就变了
给两份文档建立短指纹时,一个常见直觉是“各随机抽一个词,相同就算一次匹配”。MinHash确实会留下一个代表元素,但它依靠的是所有集合共用同一份随机全序,而不是各自独立抽样。少了这个共享条件,得到的碰撞概率就不再是原来承诺的集合相似度。
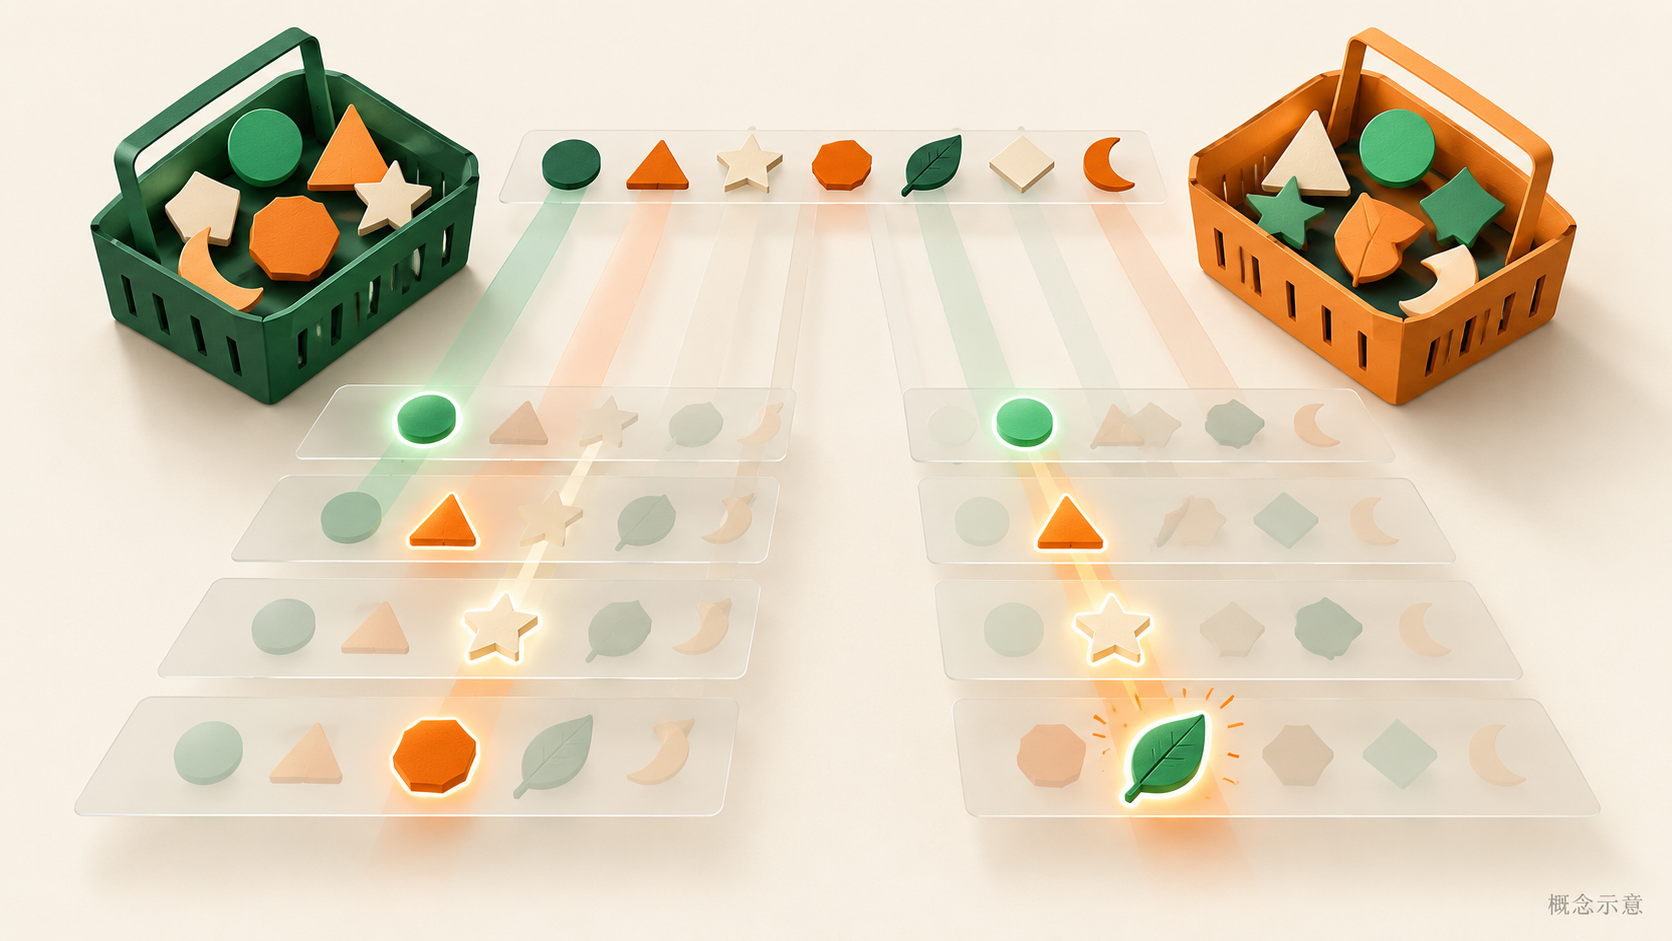
AI生成的概念示意图:两个集合在共享顺序下寻找最早元素;篮子、图形和亮灯只表达机制,不是正文四元素的逐项运行图。
四个元素足以穷举全部情况
设A={a,b,c},B={b,c,d}。交集有b、c两个元素,并集有a、b、c、d四个元素,所以Jaccard相似度为2/4=1/2。现在对这四个元素随机排列,每种排列的概率相同;A和B分别留下自己在该排列中最早出现的元素。
例如共享顺序为b、a、d、c,A最早是b,B最早也是b,两份指纹碰撞。若顺序改成a、b、c、d,A选a,B选b,便不碰撞。算法不要求原始字符的字典序有特殊含义,真正使用的是这一轮共同生成的随机顺序。
四个元素共有24种排列。若并集里最早的元素为b或c,两集合一定同时选中它;若最早的是a或d,另一集合没有这个元素,最小值一定不同。每个元素当第一名各有6种排列,因此碰撞排列共有12种,概率就是12/24=1/2。
为什么这个计数能推广
设两个非空集合的并集共有n个元素,其中k个属于交集。均匀随机全序下,每个并集元素成为最早者的概率都为1/n。两份最小值相同,当且仅当并集最早者落在交集,于是碰撞概率为k/n。
注意这里说的“碰撞”,是两个集合选中了同一个原始元素或同一个无冲突排名,不是两个不同元素偶然拥有相同的短整数哈希值。工程实现会用哈希模拟随机顺序,但有限位宽带来的额外碰撞会改变统计模型,应与MinHash自身的匹配事件分开。
如果保留m个独立共享排列各自的最小值,再计算对应位置相同的比例,就得到Jaccard的无偏估计。所谓独立是不同位置之间独立;在同一个位置上,所有文档恰恰必须共享同一随机规则。这两种“共享”和“独立”并不矛盾。
各自洗牌为什么只剩九分之二
现在故意换一个看似合理的实现:A独立随机排列自己的三个元素,B也独立排列自己的三个元素,然后各取第一个。每个集合内的三个元素都均匀,但A和B之间不再共享顺序。
相同只能发生在同时选b或同时选c,两种事件的概率各为1/3乘1/3,也就是1/9,总碰撞概率变成2/9,约0.222222。与真实Jaccard的1/2相比,这不是小样本波动,而是整个估计量的目标已经变了。
本地穷举可以直接验证:两边各有6种排列,联合共有36种等概率组合,其中8种选中相同元素,所以得到8/36=2/9。这个反例特别适合检查分布式实现中“每个分片自己设种子”的错误,避免只看单个文档指纹长度是否一致。
多存几位,改善的是统计精度
在本例Jaccard为1/2时,单个匹配指示量的方差是1/4。使用100个独立共享排列,匹配比例的标准差为√(1/4÷100)=0.05;使用400个,标准差为0.025。标准差减半需要四倍独立位置,不是两倍。
这两个数字不是误差上限,也不是自动生成的置信区间。若100个位置复用了同一排列,结果仍只能是0或1,方差还是1/4。指纹文件有100项,不等于拥有100份独立证据。实现采用相关哈希族或其他压缩变体时,应依据其实际性质评价误差。
如果筛选阈值恰好是0.5,而候选估计也在0.5附近,仅凭一次短指纹便做不可逆删除并不稳妥。更合适的方式是把它用于近似候选检索,再用原始集合核对交并比;同时保留业务允许的重复定义和人工复核路径。
文档如何变成集合,会改变问题本身
同一文本可以按词、字符片段或连续词组建立集合。普通集合会去掉重复次数,因此把同一个片段写十遍与写一遍,在这一表示中没有区别。如果业务需要考虑词频,就不能声称普通MinHash已经自动保留了频率信息,需要明确使用另一种加权表示或估计方案。
Jaccard还不同于包含率。若一篇短稿的10个片段全部出现在一篇有100个不同片段的长稿里,短稿被包含的比例是1,Jaccard却只有10/100=0.1。这样的候选在“近乎相同”筛选中得分不高,并不说明短稿没有被整段复用。
空集合没有最小元素,两个空集合的Jaccard也会出现零除零。服务需要预先定义空输入策略,不能随便放一个公共哨兵,再把所有空文档指纹碰撞解读成内容一致。分词失败、只有过滤词的文本和真正空文档,最好在进入指纹流程前分开记录。
交付一份能够重建的指纹协议
请AI检查实现时,至少输出文本规范化规则、片段长度、集合去重规则、哈希族与种子、整数位宽、指纹长度和空输入约定。相同文件经过不同版本的切分规则,可能得到完全不同的集合;这类变化不能靠增加指纹长度修补。
本文四元素穷举证明的是共享随机顺序下的碰撞机制,并没有测试真实语料的语义去重效果。MinHash擅长近似比较明确的集合表示;两篇表达不同但意思相同的文章,能否被发现,仍取决于表示方式和后续判定,而不是哈希名称本身。
批量比较时再核对一次坐标身份
两个指纹都长100,并不保证第一个位置使用了相同排列。若某个服务把种子列表排序了,另一个服务保留生成顺序,对应位置比较就会失去意义。可为整份协议生成版本标识,同时把固定测试集合的完整指纹作为兼容性样例,升级时逐位核验。
去重也是集合构造的一部分。本例若把b重复输入三次,普通集合语义下的结果必须与只输入一次相同;若指纹变化,说明代码实际上对序列或多重集合进行了处理。再交换输入元素顺序,结果同样应保持不变。这样的不变量测试比只用一对相似文档更容易抓住实现偏差。
最后把统计估计与候选索引分开保存。按指纹若干行分段建桶,是为了降低比较数量,另有自己的入选概率;它不改变完整指纹匹配比例的定义。候选未出现和候选出现但原集合相似度不足,属于两种不同失败,应在验证报告里分别计数。
资料核对日期:2026年10月3日。数值均为原创教学设定,已用本地独立程序复算;未进行真实模型训练、线上检索或生产性能测试。
参考资料
Broder:On the resemblance and containment of documents,第3节