Python sqlite3 executemany:生成器中途报错,前两行为什么仍然被提交
导入任务只调用了一次executemany,输入生成器却在第三项之前报错。调用者记录了错误,随后发现前两行已经提交。关键不在于数据库忽略了异常,而在于executemany会逐项消费参数并重复执行语句,输入失败时前面的写入可能已进入事务;异常又在with块内部被捕获,事务出口看到的是正常结束。把调用次数、语句次数与事务范围混成一件事,就容易产生这种部分成功。
本文在Linux、CPython 3.12.14与运行时SQLite 3.53.1上实跑。数据库均为独立的:memory:连接,测试结束显式关闭,不读取或修改业务数据库。Python版本与SQLite库版本分别记录,因为相同Python版本可能链接不同SQLite构建。
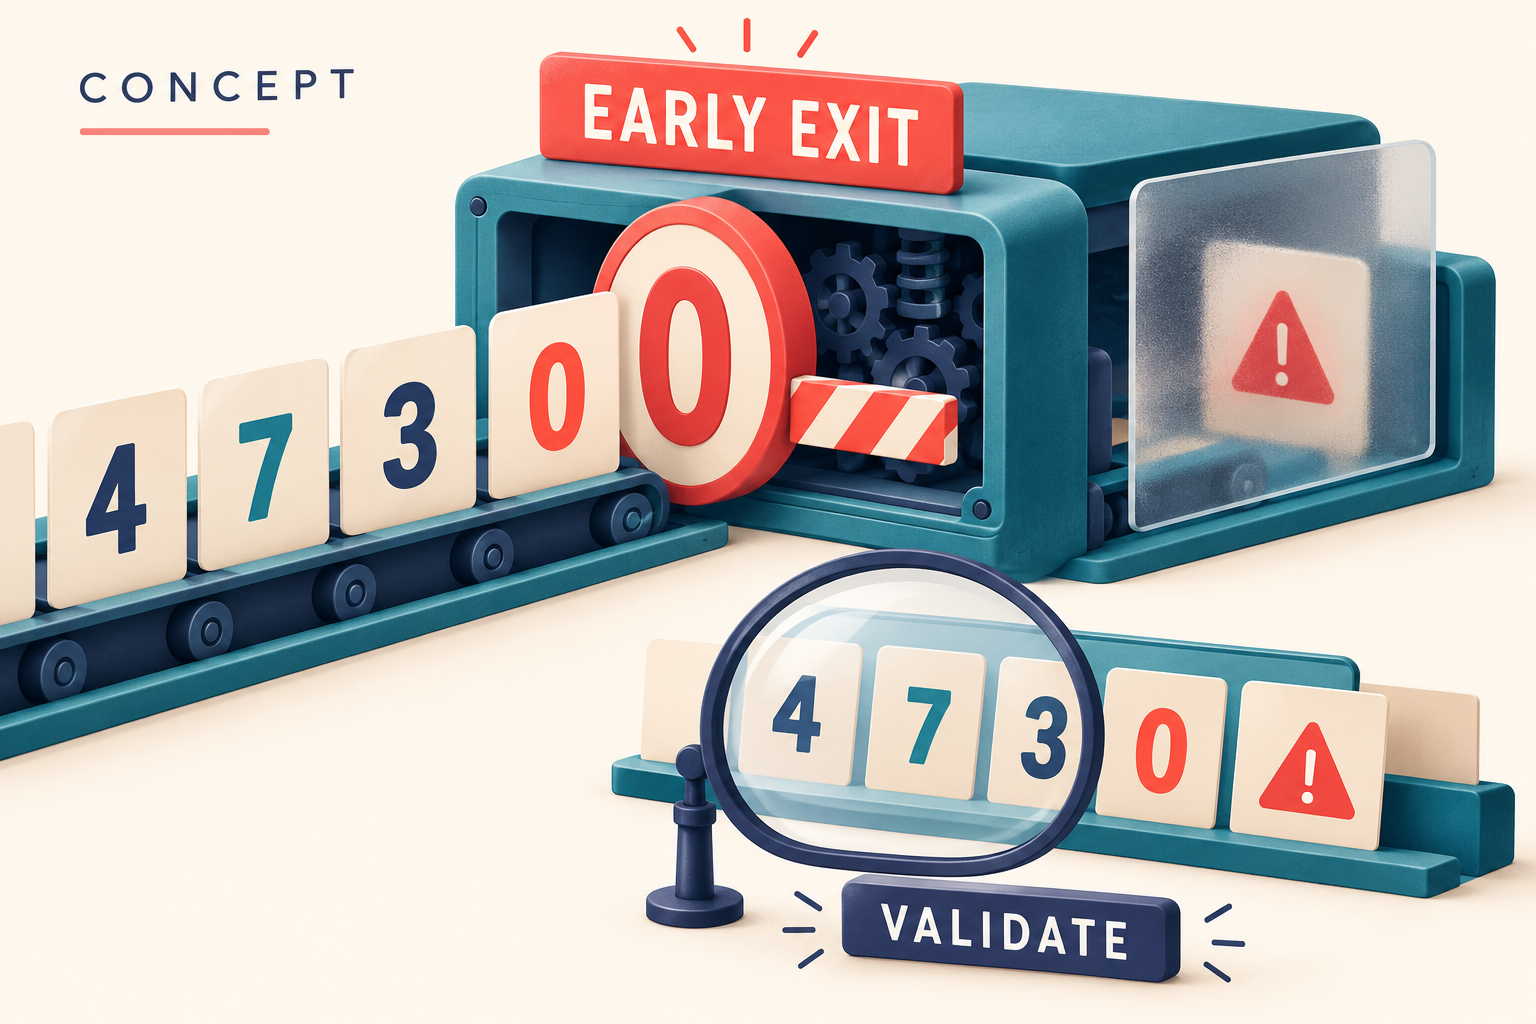
AI生成的概念示意图:任务卡片流进入事务容器,中途出现警告,再分向提交档案盒与回滚托盘,强调异常如何离开事务边界;不是真实软件界面或运行截图。
完整程序与实际输出
保存为demo.py,执行python3 demo.py。程序只使用固定测试输入,代码和本次输出分别列出。
import sqlite3

def rows():
    yield ('alpha',)
    yield ('beta',)
    raise ValueError('input stopped')

for mode in ('catch-inside', 'catch-outside'):
    con = sqlite3.connect(':memory:')
    try:
        con.execute('CREATE TABLE job(name TEXT NOT NULL)')
        if mode == 'catch-inside':
            with con:
                try:
                    con.executemany('INSERT INTO job VALUES (?)', rows())
                except ValueError as exc:
                    print(mode, 'caught:', str(exc))
                    print('pending rows:', con.execute('SELECT name FROM job ORDER BY rowid').fetchall())
                    print('transaction active:', con.in_transaction)
        else:
            try:
                with con:
                    con.executemany('INSERT INTO job VALUES (?)', rows())
            except ValueError as exc:
                print(mode, 'caught:', str(exc))
        print(mode, 'after with:', con.execute('SELECT name FROM job ORDER BY rowid').fetchall())
        print('transaction active:', con.in_transaction)
    finally:
        con.close()
本次实际标准输出:
catch-inside caught: input stopped
pending rows: [('alpha',), ('beta',)]
transaction active: True
catch-inside after with: [('alpha',), ('beta',)]
transaction active: False
catch-outside caught: input stopped
catch-outside after with: []
transaction active: False
把失败点放在输入生成器里
rows先产生alpha和beta两组参数,接着抛出ValueError。错误来自Python输入侧,不是SQL唯一约束,也不是数据库连接中断。这个安排可以清楚地区分两件事:已经产生的参数可能已被执行,尚未产生的参数根本没有交给SQLite。一次函数调用失败,不表示这次调用内部没有做过任何工作。
executemany接收可迭代参数,每拿到一组就重复执行同一条参数化DML语句。它不是先无条件收集整个输入、确认全部合法以后才开始写入。使用生成器可以减少输入常驻内存,却也把读取、转换与写入交织在一起。上游解析第三条记录时出错,数据库可能已经接纳前两条。
程序在捕获处马上查询表,得到alpha和beta,并打印事务仍处于活动状态。此刻“本连接能看到两行”和“两行已经持久提交”仍有区别。查询同一连接能观察到待提交修改,不能据此判断另一连接一定可见;本文随后通过退出with后的结果与事务状态,展示最终出口发生了什么。
内部捕获为什么会走提交路径
catch-inside把try和except放在with con里面。ValueError在到达上下文管理器出口前已经被处理,with主体因而正常结束。在本例默认的传统事务控制模式下,连接上下文管理器会提交已有事务,前两行得到保留。输出中after with仍有两行,而transaction active变成False,与这一过程一致。
日志语句本身不会把异常重新抛出。实际项目常见的模式是捕获后打印“导入失败”,函数再返回一个普通状态;如果这一切发生在事务内部,外围代码可能仍然正常提交。错误文案和控制流不是同一个信号。要让事务失败路径生效,应让异常离开事务边界,或在内部采取明确的回滚策略并保证后续没有误提交。
不建议为了修复这一问题而到处添加宽泛except,再凭布尔变量猜测该提交还是回滚。事务结构越复杂,越容易漏掉输入转换、校验或日志之外的异常。尽量让成功出口集中,失败由一致的异常传播路径处理,随后在事务外把异常翻译成用户能够理解的业务结果。
外部捕获把回滚留给with
catch-outside将try包在with外侧。同一个生成器同样先提供两组参数,但ValueError会穿过with出口,连接上下文管理器回滚打开的事务,然后外层except才记录错误。最终表为空,事务不再活动。示例没有换SQL、没有更换输入,差异仅在异常处理所在的位置,因此因果关系很容易复核。
这个保证依赖事务确实包住相关写入。若连接处于自动提交、前面已经显式提交,或工作被切成多个独立事务,外层捕获无法撤销已经完成的提交。Python 3.12还提供autocommit设置,不同模式下连接上下文的效果有区别。迁移配置时要重新检查事务状态,而不是把with看成对任何连接设置都有效的魔法。
连接上下文管理器负责提交或回滚,不负责关闭连接。程序用finally显式close,使每轮测试的资源生命周期独立清楚。这不是本文错误的直接原因,却能防止测试之间残留连接状态,尤其在将内存数据库换成文件数据库后,连接未关闭还可能干扰锁与文件删除等后续观察。
选择全批原子性还是可追踪的部分成功
若业务要求全批成功,输入读取、参数转换与全部写入都应处于一致的失败策略内。小批次可先完整校验输入再写入,大批次可以流式处理但保留事务回滚能力;两者在内存、锁持续时间和失败重试成本上各有取舍。先声明业务保证,再决定分批大小,不能把性能选项顺手变成数据一致性策略。
如果业务允许分块提交,应为每个块保存稳定标识、成功进度及重试规则。生成器报错后直接重跑整个文件,可能再次插入已经提交的前缀。去重键或幂等标识应来自业务记录,而不是根据本次插入顺序猜测。部分成功并非总是错误,无法说明究竟成功到哪里才是问题。
输入生成器还可能有数据库事务之外的副作用,例如读取消息、推进文件位置或调用外部服务。SQLite回滚只恢复数据库事务,并不会让生成器倒退,也不会撤销外部操作。本文的rows只产生固定字符串,没有此类副作用;换成真实来源时,应单独设计确认、重放与检查点机制。
验收至少覆盖输入为空、第一项前失败、中途失败、数据库约束失败和全部成功。对每组同时检查最终行集合与事务是否仍活动,不能只断言抛了某种异常。本文两行样本足以暴露捕获位置的问题,扩展测试时应保留这一最小反例,让后续重构事务包装器时能够立刻发现行为变化。
参考资料与验证记录
官方资料核验于2026年10月3日。本次完整程序退出码为0,标准错误为空;例子验证的是上述固定输入与运行环境,不表示所有平台和版本的输出细节完全一致。