

用 AI 试排库里肖夫剪辑:同一张脸,接上不同镜头会怎样读
短片里的人物没有微笑,也没有皱眉,观众仍可能觉得他在期待或失落。这种判断有时来自邻接镜头。AI适合在拍摄前帮我们列出几种组合,并说明每个组合依靠哪条线索;真正的效果则要留给实际观看,不能由AI替观众宣布。
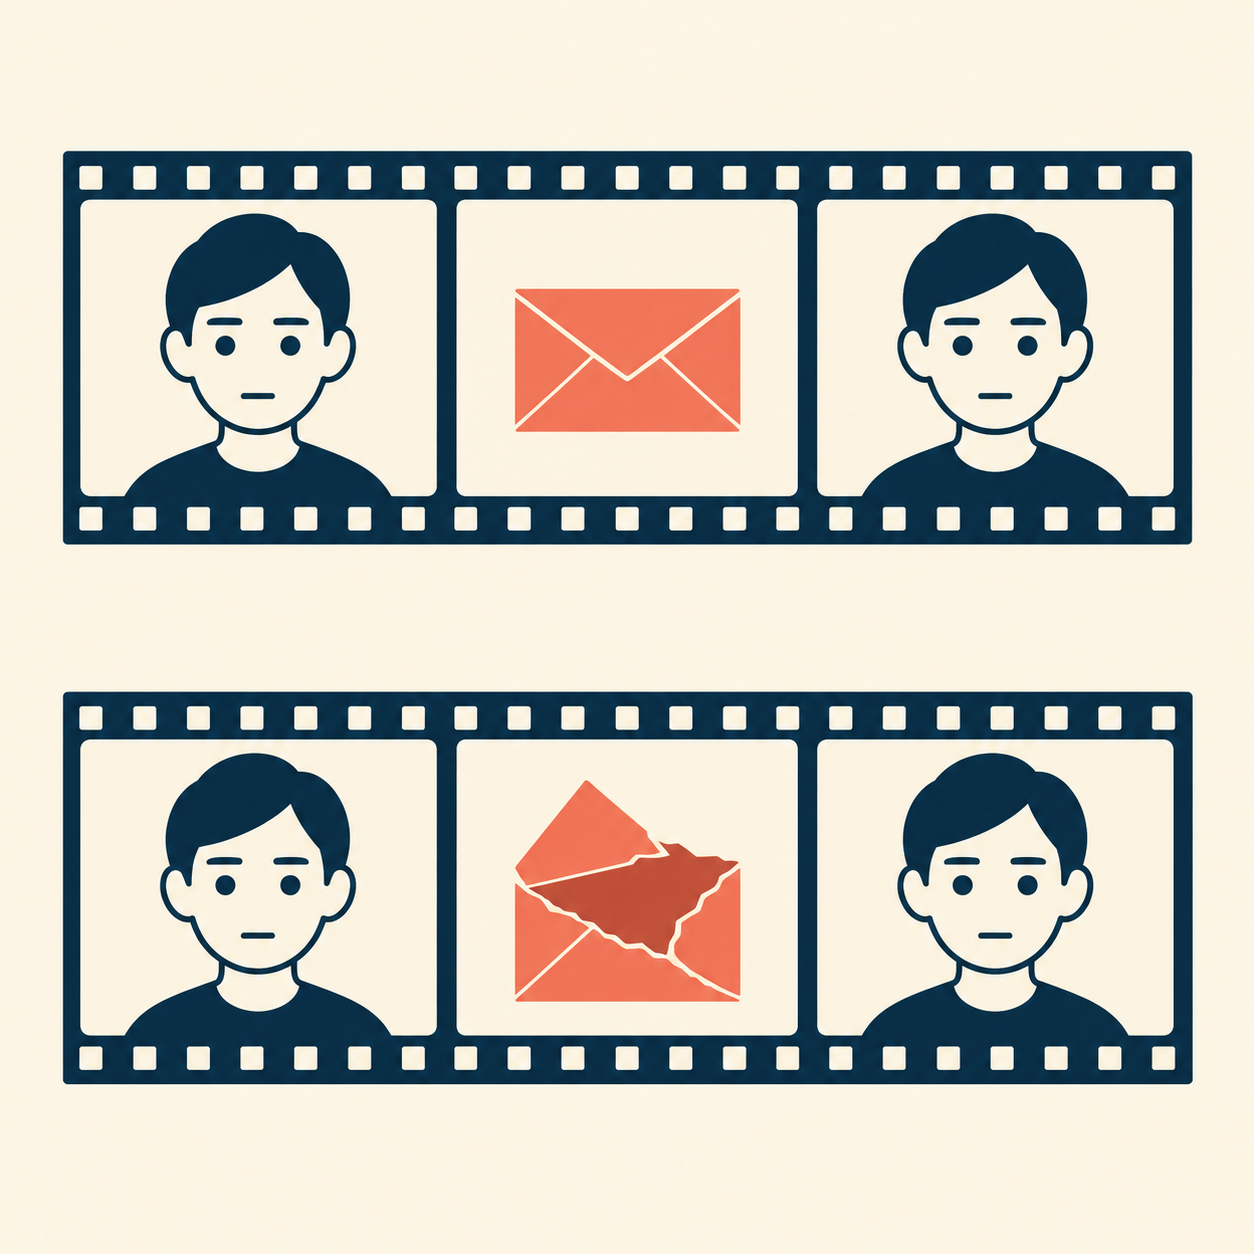
AI生成概念插图:相近的中性脸与两种信封状态组成剪辑对照;不是影片截图,也不代表观众实验结果。
只替换中间那一段素材
原创素材清单有三项。F是一位成年演员看向画外的两秒中性表情,固定机位,无台词。E是一只完整封口信封,放在空桌上,四秒。T是同款信封已经撕开、里面没有纸,四秒。两只信封颜色相同,拍摄方向与人物视线对应。练习只使用这些素材,不添眼泪、叹气或音乐。
方案甲按F、E、F排列,时长为2加4加2,共8秒;方案乙按F、T、F排列,同样8秒。两个F都复制同一素材的同一入出点,不重新挑一个“更像失望”的表情。这样,两版在本次剪辑层面改变的主要条件是中间对象的状态。
把预期读法写成可以被推翻的句子
甲可能被读成等待消息、犹豫是否拆信,也可能只是盯着桌面。乙可能被读成发现内容不见了、回想一封已读的信,甚至是检查废纸。AI若只给“甲期待、乙伤心”,就省掉了我们最需要的部分:同一个镜头还容许哪些解释,缺少什么线索才无法排除它们。
2024年的相关原研究使用脸、场景、同一张脸的组合,并讨论场景背景对面部情绪判断的影响。这支持把邻接语境作为剪辑变量来练习;它没有证明本文两只信封一定产生相同效果。影片节奏、素材表情和观众经验都会改变读法,不能把研究名称当成效果保证。
完整提示词与交付检查
“请做一份原创无声短片剪辑试排。素材F:成年演员中性表情看画外,2秒;E:桌上封口信封,4秒;T:同款撕开空信封,4秒。生成F-E-F与F-T-F两版,F必须复用同一入出点。列每段起止秒、总时长、两种可能读法及各自依据。不得加音乐、字幕、新表情或隐藏情节。给一项只检验中间镜头影响的观看记录办法;预期与实测分开。”
合格时间单是0至2秒F、2至6秒E或T、6至8秒F。手工打开时间线,检查两个F的素材名、入点和时长,再临时关掉中间镜头,确认表情没有变化。模型若把最后F放慢,便又增加了一个影响判断的变量,需先恢复。
观看时先问“你觉得人物正在想什么,依据在哪里”,记录原话,再揭示两版复用同一表情。少量熟人反馈只能帮助这支短片修改,不能外推观众比例。若大家都没读出信封差异,下一步是让封口和空内部更易辨认,再比较;AI的作用是帮我们把修改落到具体镜头。



