

让 AI 排一次 MoE 路由:总槽位够用,热门专家为什么仍会溢出
稀疏专家模型常被介绍成“每个token只找少数专家”。但即便总处理槽位不少于token数,也不代表每个请求都能进入它首选的专家。把路由选择和容量限制分开记账,才能解释一边拥挤、一边空闲的情况。
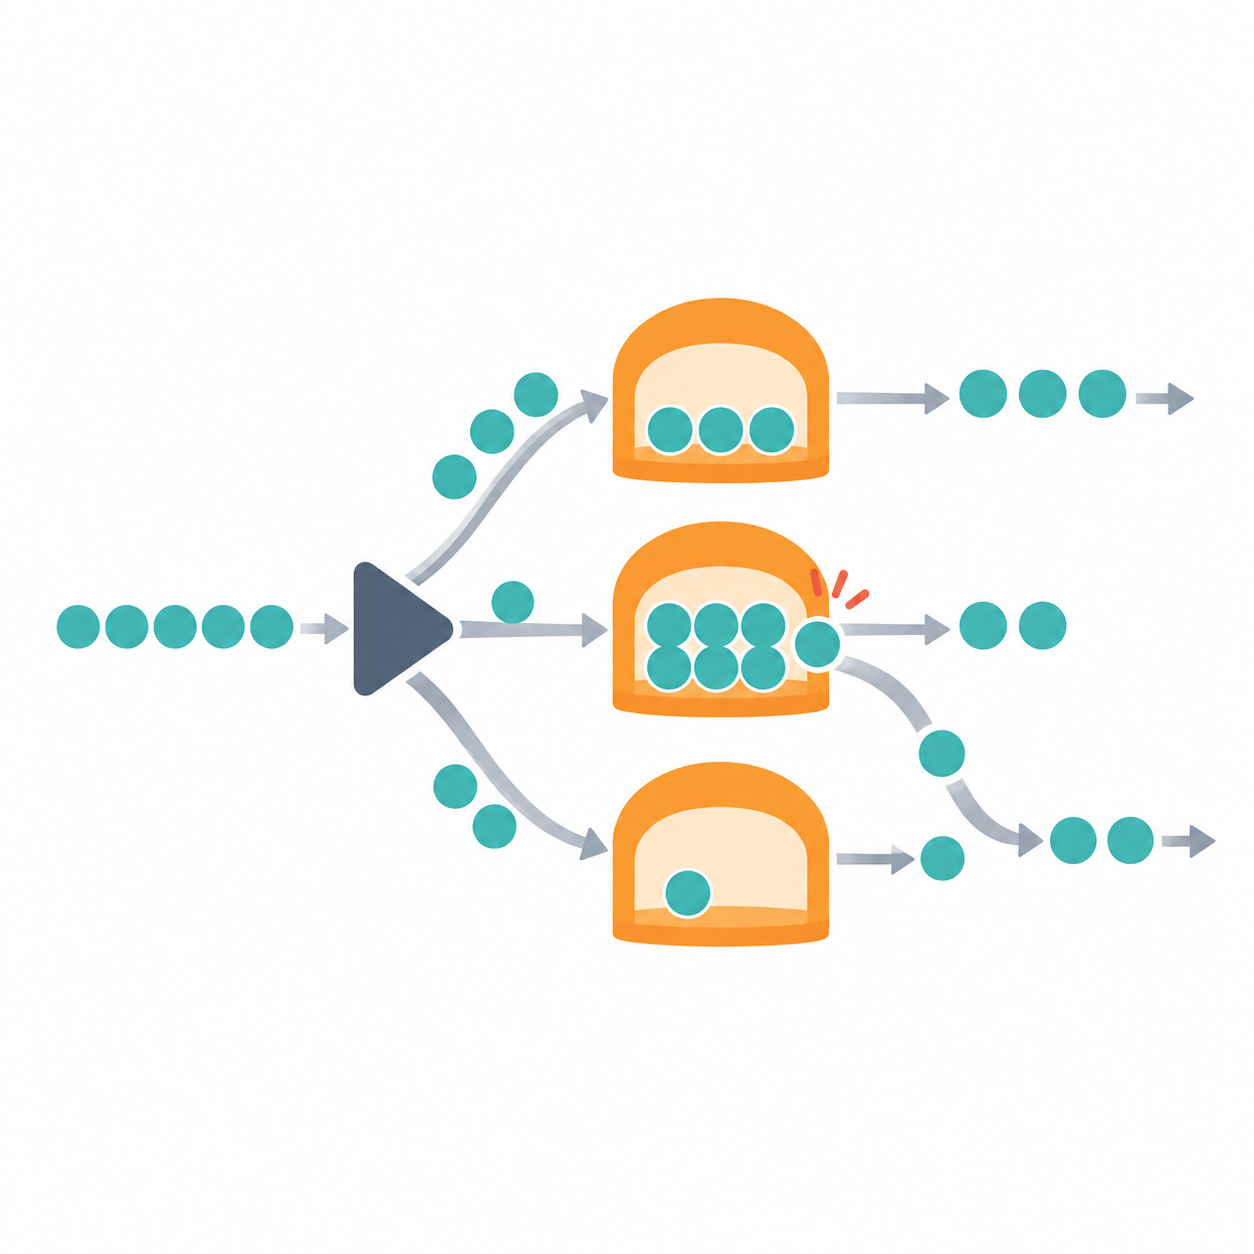
AI模型生成的概念插图:专家收到不均匀的路由,热门分支存在旁路;圆点数量仅表达拥挤关系,不编码正文八个token。
先规定一种具体路由,而非所有 MoE
本文采用Switch Transformer论文中的top-1思路:每个token选路由概率最高的一个专家;容量超过上限时,该专家层的计算可被跳过,表示沿残差路径继续。不同MoE实现可能有重路由或其他策略,因此以下结论只用于写明的方案。
准备8个token,4名专家E1至E4。首选依次为[E1,E1,E1,E1,E1,E2,E3,E4],所以需求量为[5,1,1,1]。演示规则规定按输入顺序占槽,满了以后走旁路;这个顺序规则是本例的明确约定,不能假装所有实现都如此。
论文给出的容量关系是“批次token数÷专家数×容量因子”。因子取1时,每名专家有8÷4×1=2个槽,总共8个。E1只能接前两个,另外三个溢出;E2、E3、E4各接一个,总共只处理5个。
空槽不能自动搬给热门专家
三个冷门专家各空一个槽,所以此时空槽数也是3。总容量8等于需求8,却仍出现3个溢出,这不是加法出错,而是8个槽分属不同专家。除非实现另有迁移或重路由机制,E2的空位不能直接承担E1的函数。
把容量因子改成1.5,每名专家有3槽,总共12槽。E1接3个,其余三名各接1个,处理6个,仍有2个溢出;空槽是12-6=6。槽位增加以后,溢出有所减少,但整体利用比例从5/8降成6/12。利用比例是本例的槽位账,不是GPU吞吐率。
要让这份路由完全不溢出,逐专家容量至少达到5,相应因子为2.5。总槽位达到20,仅8个被使用,空12个。可见单靠扩大统一容量能解决本次拥挤,也会在其他专家留下更多空位。实际成本还受通信、填充和实现方式影响,不能将空槽百分比直接换算成速度下降。
让 AI 保留需求、接收与旁路三份数量
一份有用的路由检查表应逐专家列首选token编号、容量、实际接收、旁路编号和剩余槽位。总接收加总旁路必须等于8;接收不能超过各自容量;空槽要按配置容量减实际接收算。只列最终专家编号,会把被选中与被处理混为一谈。
读者可以再试均匀路由[2,2,2,2],在容量因子1时恰好无溢出。它与原例有相同的token数、专家数与总容量,差别来自负载分布。这个对照可以用来检查AI是否只按平均需求判断容量够不够。
本例没有计算路由器训练、负载均衡损失或专家输出的概率加权,也没有宣称某种模型实际丢弃了多少token。若输入规模不是专家数的整数倍,还必须说明容量取整和最小容量规则。先把这几条约定写在账本顶部,才有条件比较两套配置。
资料核对日期:2026年10月2日。算例为原创教学设定,已用独立Python计算复核,不代表真实模型训练或性能测试。



