

用 AI 核对 Q-learning 目标:回合已经停了,未来价值为何有时还要算
强化学习日志里出现“这一回合结束”,可能是任务已经到达终止状态,也可能只是采样器用完了本次时间。让AI解释更新公式时,若把两者都写成“未来价值归零”,就会把两个学习问题混在一起。
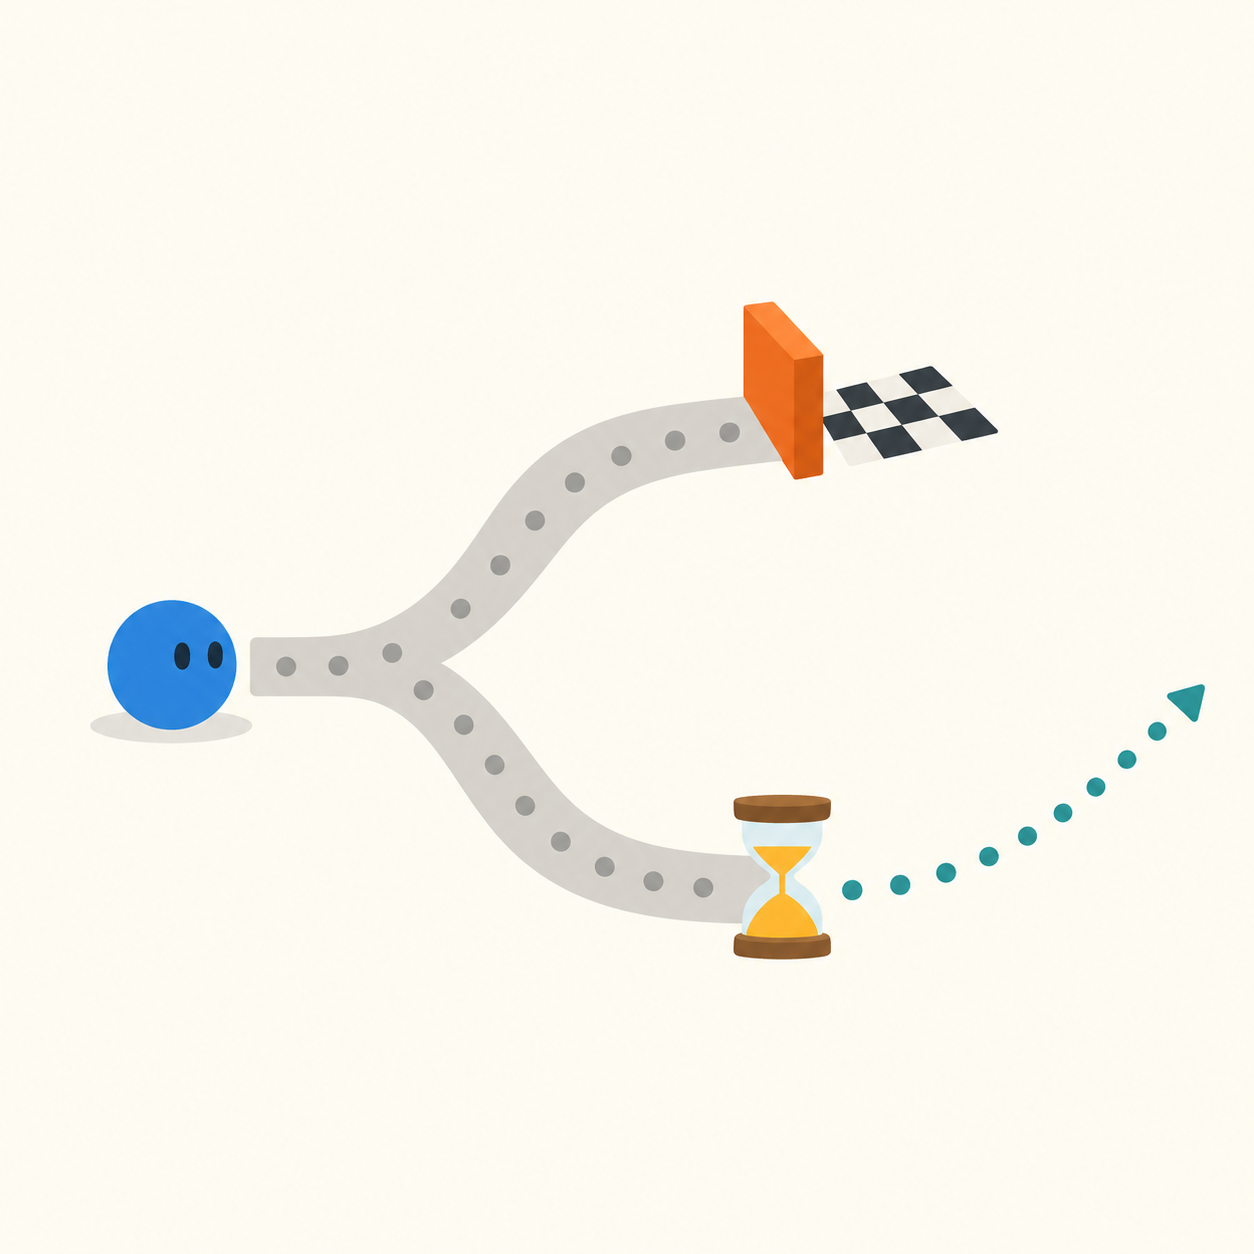
AI模型生成的概念插图:一条路径到达终点,另一条暂时停表后仍可延伸;不是游戏实测、环境截图或价值函数图。
同一条数值记录,先说明停下的原因
设当前Q(s,a)=4,刚收到奖励r=2,折扣系数γ=0.9,下一状态两个动作的估计值是[10,6],本次表格更新学习率α=0.25。这里数值全是教学输入,既不来自训练日志,也不代表动作真的能得到这些回报。
若下一状态仍属于可继续的任务过程,Q-learning目标是r+γ×max Q(s′,a′)=2+0.9×10=11。再按“旧值+α×(目标-旧值)”更新,得到4+0.25×(11-4)=5.75。目标11和更新后的5.75不是同一个量,应分别记下。
现在设采样器因为外部步数上限停下,但底层任务在这个状态仍可继续。这是截断。对这一自举更新,应保留下一状态的价值估计,仍得到目标11和新值5.75。停止收集这一回合,并不自动取消状态在任务定义中的后续回报。
真正终止时,目标只剩这一步奖励
如果同一条记录表示到达任务定义的终止状态,就不再加未来项。目标变成2,更新为4+0.25×(2-4)=3.5。若把所有结束都当终止,本来应更新到5.75的截断样本就会错误地更新到3.5,两者差2.25。
Gymnasium把terminated与truncated分开,正是为了保留这种信息。一个常见的自举掩码是1-terminated;而结束本次回合循环往往需要看terminated或truncated。控制“是否开始下一回合”和控制“是否使用后续价值”,不应强行共用一个含义模糊的done。
时间限制本身也可能属于任务规则
不能反过来认定所有计时结束都只是截断。如果任务原本就规定“只能走十步”,到时便结束,那么有限时域的终点属于任务定义。为了保持相应的马尔可夫描述,观察通常还应包含剩余时间信息;同一个位置剩一步与剩九步,决策条件可能不同。
让AI检查日志时,先给出环境规则、terminated、truncated、奖励和真正的下一观察,再要求它逐条写自举掩码、max值、目标和更新。遇到自动重置的包装器,还要确认拿来估值的是被截断轨迹的末状态,而不是新回合的初始状态。
可加两个验收点:γ=0时两种目标都只剩即时奖励;α=1时表格新值直接等于目标。它们有助于发现漏掉折扣、把学习率乘在错误位置等算式问题,却不能证明整个算法已经收敛。
本文只计算单步表格Q更新。DQN等方法还涉及目标网络、损失函数和批量采样,不能把5.75直接当成一次神经网络训练后的输出。先保住“为什么结束”的语义,再讨论优化过程,才不会让漂亮的损失曲线掩盖错误目标。
资料核对日期:2026年10月2日。算例为原创教学设定,已用独立Python计算复核,不代表真实模型训练或性能测试。



