

让 AI 比较 Huber 与 Smooth L1:转折点相同,损失为何仍差一个倍数
Huber与Smooth L1都常用来减弱大残差的影响,名字相近、曲线形状也相似。让AI比较时,若只说“都是小误差平方、大误差线性”,就会漏掉缩放差别,连同一批数的损失大小都可能算错。
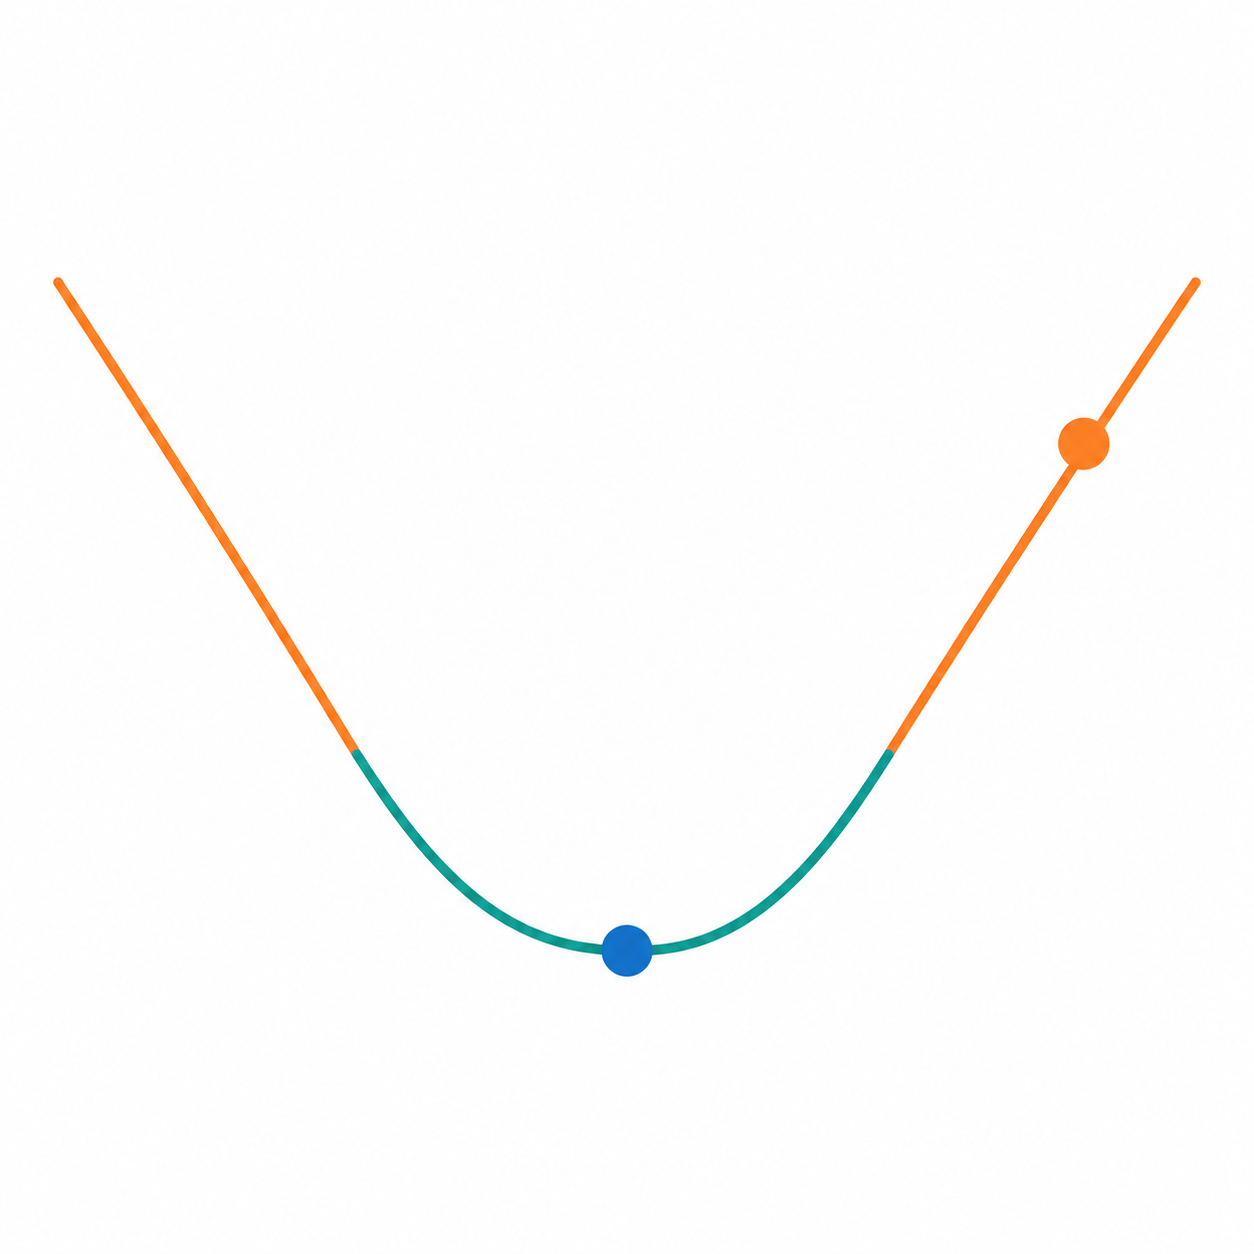
AI模型生成的概念插图:中间弧形区接到两侧线性区;没有精确坐标或单位,不是训练损失曲线或软件截图。
先给残差定义与转折尺度
定义残差e=预测值-目标值,取δ=2。Huber在|e|小于δ时为e²/2,在外侧为δ×(|e|-δ/2)。本例先逐项计算,再明确使用哪一种归约,不把框架默认值藏在最后一行。
对残差[0.5,2,5],第一项落在平方区,损失0.5²/2=0.125。第二项恰好到边界,用外侧表达式为2×(2-1)=2,内侧延伸到边界也得到2。第三项为2×(5-1)=8。
三项相加得到10.125,若按三个元素取平均,结果为3.375。若AI报告10.125而你预期3.375,可能只是sum与mean不同,不应立即判定它用了错误的逐项公式。先核对未归约的三个数。
线性尾部的斜率由 δ 决定
Huber对残差的导数在内侧为e,外侧为δ乘残差的符号。因此上面三项的未归约导数为[0.5,2,2]。残差从2增至5,损失继续增长,斜率却不再跟着残差变大;它没有把大残差整个忽略。
在e=2处,两侧导数都是2;在e=-2处都是-2,因此一阶连接是平滑的。若拿e²/2作为对照,e=5的损失为12.5,导数为5,而Huber是8和2。这是明确公式下的局部比较,不是宣称某份真实数据的预测效果提高了。
这里被限制的是损失对残差的导数。模型参数的梯度还需乘预测对参数的导数,并受批量归约影响,所以不能说所有参数梯度绝对值都被限制到2;那会把稳健损失与全局梯度裁剪混为一谈。
Smooth L1 要把整个 Huber 再除一次
在对应β=δ=2的设定下,PyTorch所述Smooth L1等于Huber除以δ。所以三项变成[0.0625,1,4],总和5.0625,均值1.6875。转折点仍在绝对残差2,但损失尺度全部减半,线性尾部斜率也变成1。
只有δ=β=1时,这两个定义才在数值上相同。替换损失后若保留其他损失项权重,组合目标里的相对贡献可能改变;不能因为转折点一样,就认为总目标无需重新检查。
读者可以让AI逐项列区域、Huber值、对e的导数、Smooth L1值,最后分别算sum和mean,并补测负残差以检查损失对称、导数反号。边界附近的差分检查应选合理步长,避免把舍入噪声误当不连续。
δ必须为正,而且它与残差使用同一数值尺度。把目标单位从米改成厘米后,若δ仍写2,容许的误差范围已经改变。本例不能替你选最佳δ;应结合目标尺度、异常值来源和独立验证决定。
资料核对日期:2026年10月2日。算例为原创教学设定,已用独立Python计算复核,不代表真实模型训练或性能测试。



