

用 AI 做保序校准:高分样本暂时失败,为何要和前一段合并
分类分数越高,校准后的概率通常希望不要反而下降。但少量标注里完全可能出现“低一点的分数成功,高一点的分数失败”。保序回归不会把标签重新排序,它在保持分数顺序的条件下寻找一组尽量贴近标签的拟合值。
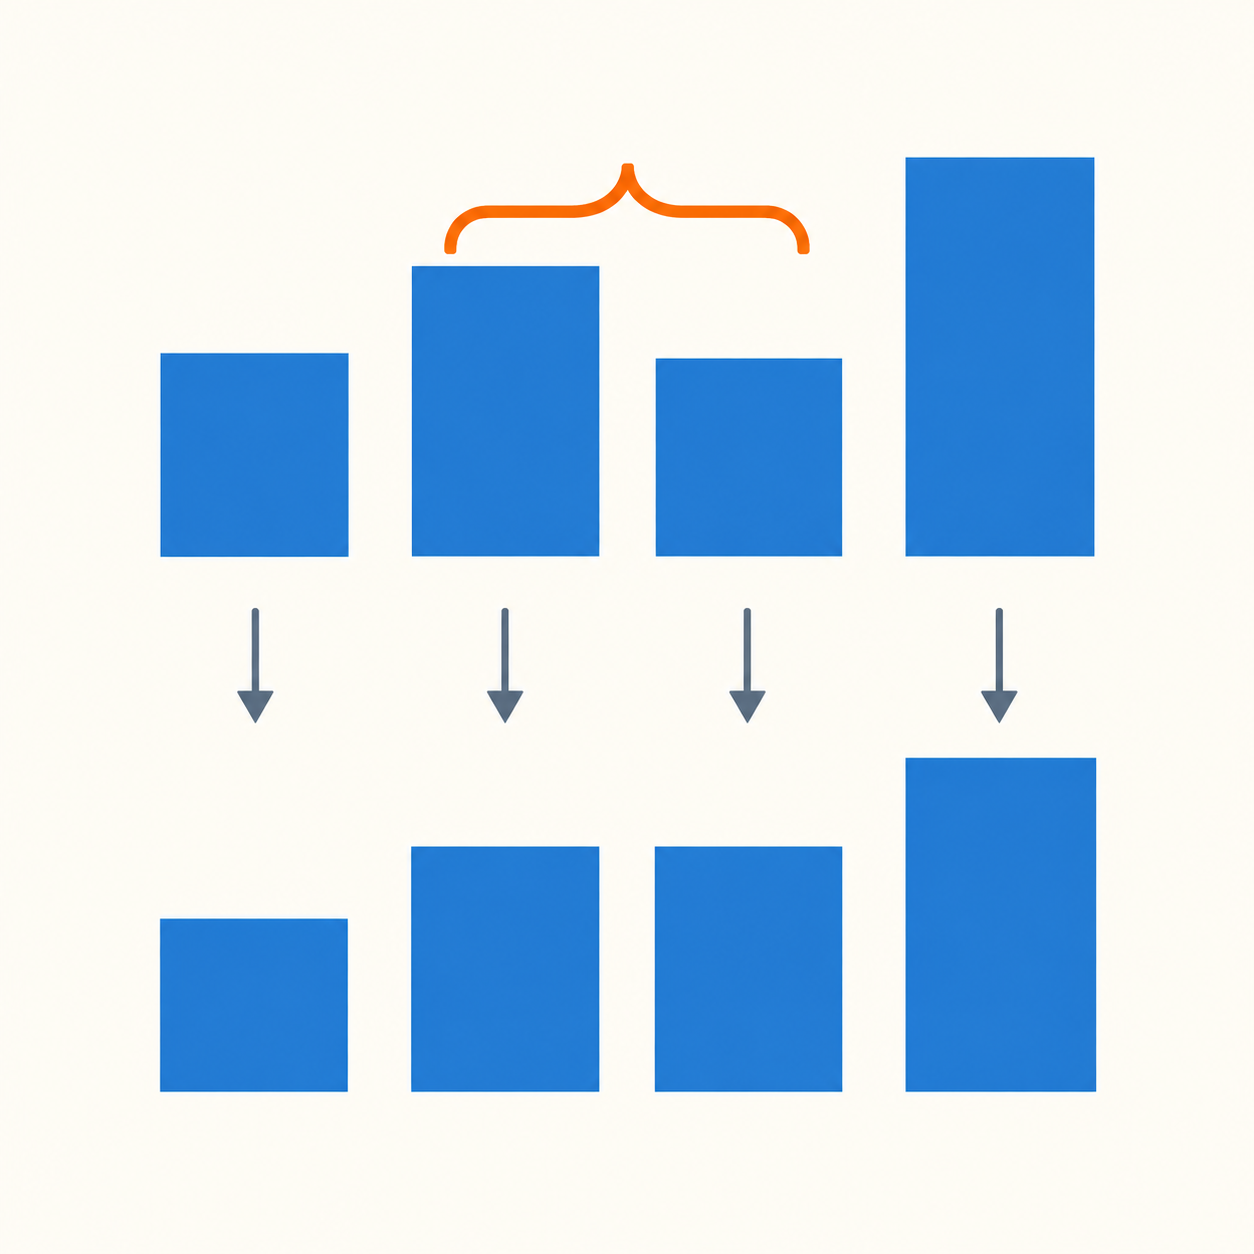
AI模型生成的概念插图:相邻违序段被合并后形成非递减结果;柱高不代表本文概率、样本量或实测表现。
四个有序分数,不是四个已经可信的概率
设分数按升序为[0.1,0.2,0.3,0.4],对应二元标签为[0,1,0,1],每条权重都为1。分数只是校准器的输入,暂不假定它已经等于真实概率。要求输出q₁≤q₂≤q₃≤q₄,并最小化各项(yᵢ-qᵢ)²之和。
若直接复制标签,第二项1大于第三项0,违反非递减约束。把这两个相邻项合并成共同值m,中间损失为(1-m)²+m²。展开或求导可得最小值在m=0.5,于是拟合结果为[0,0.5,0.5,1]。
这时总平方误差是0+0.25+0.25+0=0.5。若把中间两个都压成0或都抬成1,虽然同样满足顺序,中间误差都会变成1;满足单调并不代表已经最小化目标。首尾0与1没有造成新的违序,所以本例无需继续合并。
合并值按权重平均,不能只数分数位置
现在仅将第三条标签0的权重改为3,其余权重仍为1。中间目标变为(1-m)²+3m²,最优共同值为1/(1+3)=0.25,得到[0,0.25,0.25,1]。加权平方误差为0.75²+3×0.25²=0.75。
若仍机械地取0.5,加权误差为0.25+3×0.25=1,比0.75大。这里权重体现各条观测在给定目标中的影响,不能把它偷偷理解为模型更喜欢哪一种标签。实际数据中的权重来源也应记录。
相邻违序合并算法PAVA会把违反顺序的相邻块合并,并以块内加权均值作为新值;合并后还要回看与前一块是否又发生违序。本例只需合并一次,但较长序列可能要连续向前合并,不能只扫描一遍相邻原始标签便停下。
拟合点之外,还要明确预测规则
采用scikit-learn IsotonicRegression的线性插值,等权例中分数0.25位于两个0.5之间,输出0.5;分数0.15位于(0.1,0)和(0.2,0.5)中间,输出0.25。不能把训练点的成块常数结果误解成接口在所有区间都只做阶梯跳变。
分数0.05已经超出本例训练范围。该接口默认out_of_bounds='nan',返回NaN;选择clip才会使用最近端点值0,选择raise则报错。读者应让AI在拟合值之外另列区间内与区间外的预测规则,避免把无数据支持的外推悄悄写成可靠概率。
真正做模型校准时,要使用没有参与基础分类器拟合的数据,并另外评估校准效果。四条观测只适合演示算法,远不足以证明现实概率可靠;保序映射还会产生并列值,不保证严格保留原先所有排名差异。检查AI时先看标签与分数是否保持配对,再看合并过程和加权误差。
资料核对日期:2026年10月2日。算例为原创教学设定,已用独立Python计算复核,不代表真实模型训练或性能测试。
参考资料
scikit-learn:Isotonic regression



