让 AI 拆 InfoNCE 分母:正例没变,重复一个负例为何仍会加大损失 对比学习常被说成“拉近正例、推远负例”。这句话没有说明一批候选怎样一起影响损失。让AI固定正例与负例的评分,只重复一条负例,就能看见InfoNCE衡量的并非孤立的正例距离。 yunqueblog/ AI分享/ 2026-10-02/ 3 阅读
用 AI 算 Focal Loss:一百个容易样本,为何不再压过一个难样本 同一批训练样本中,容易判断的项目可能数量很多。每项损失虽然小,合起来仍会盖过少数难例。要理解Focal Loss改变了哪里,可以让AI先算单张卡,再把同一种卡复制一百次,检查总贡献怎样变化。 yunqueblog/ AI分享/ 2026-10-02/ 3 阅读
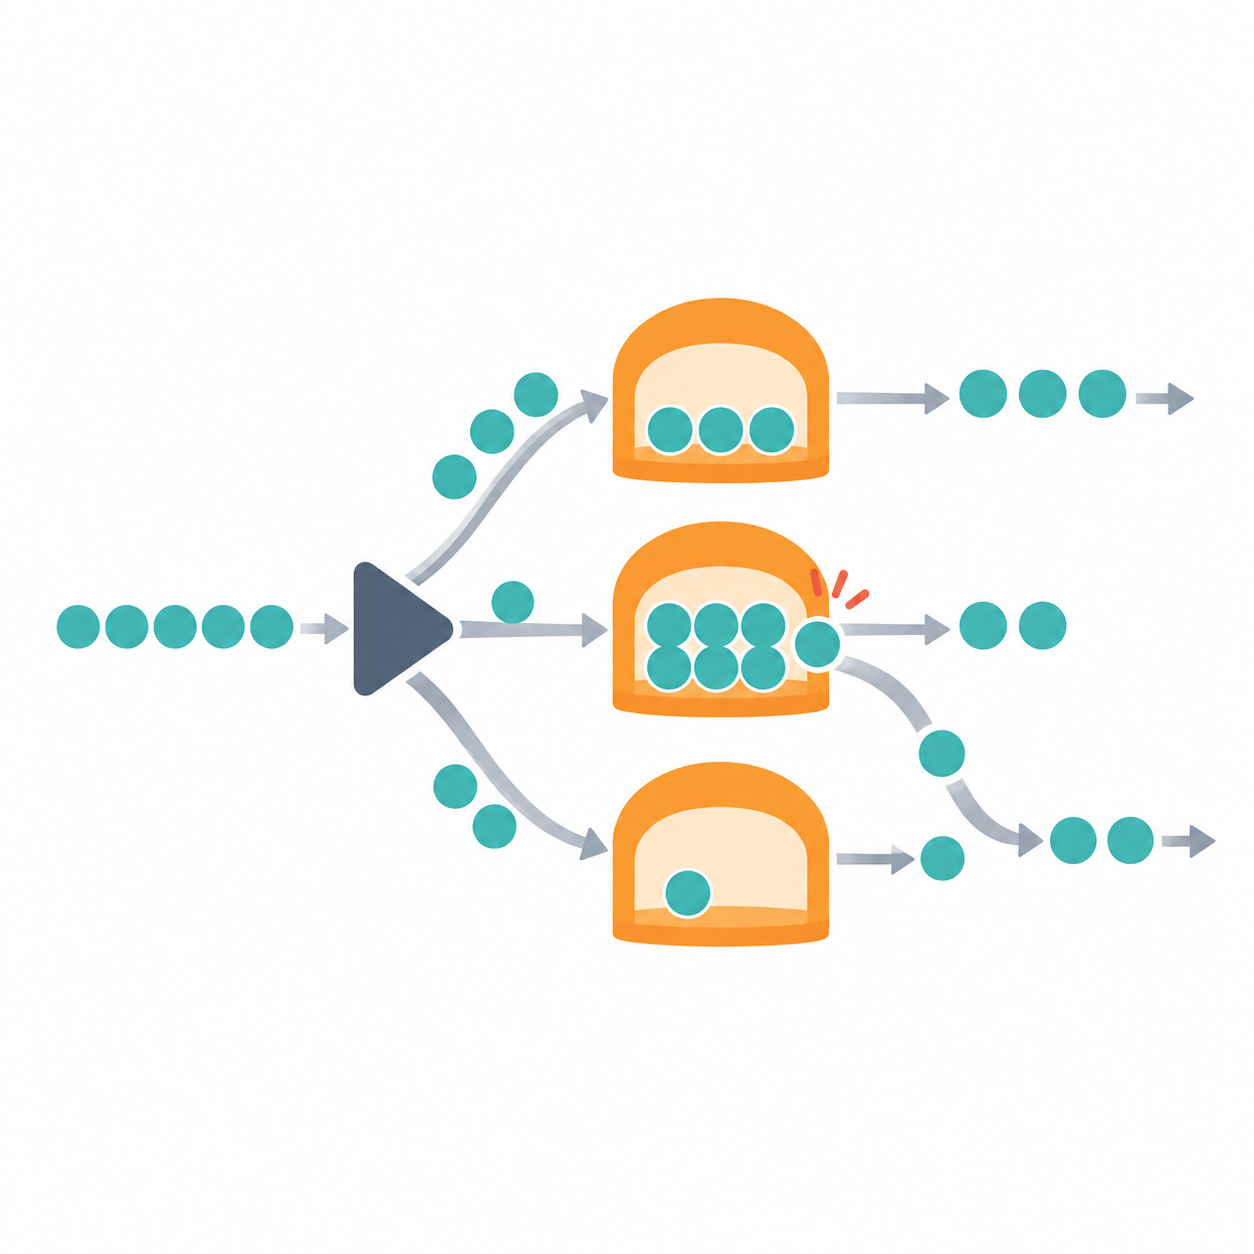
让 AI 排一次 MoE 路由:总槽位够用,热门专家为什么仍会溢出 稀疏专家模型常被介绍成“每个token只找少数专家”。但即便总处理槽位不少于token数,也不代表每个请求都能进入它首选的专家。把路由选择和容量限制分开记账,才能解释一边拥挤、一边空闲的情况。 yunqueblog/ AI分享/ 2026-10-02/ 3 阅读
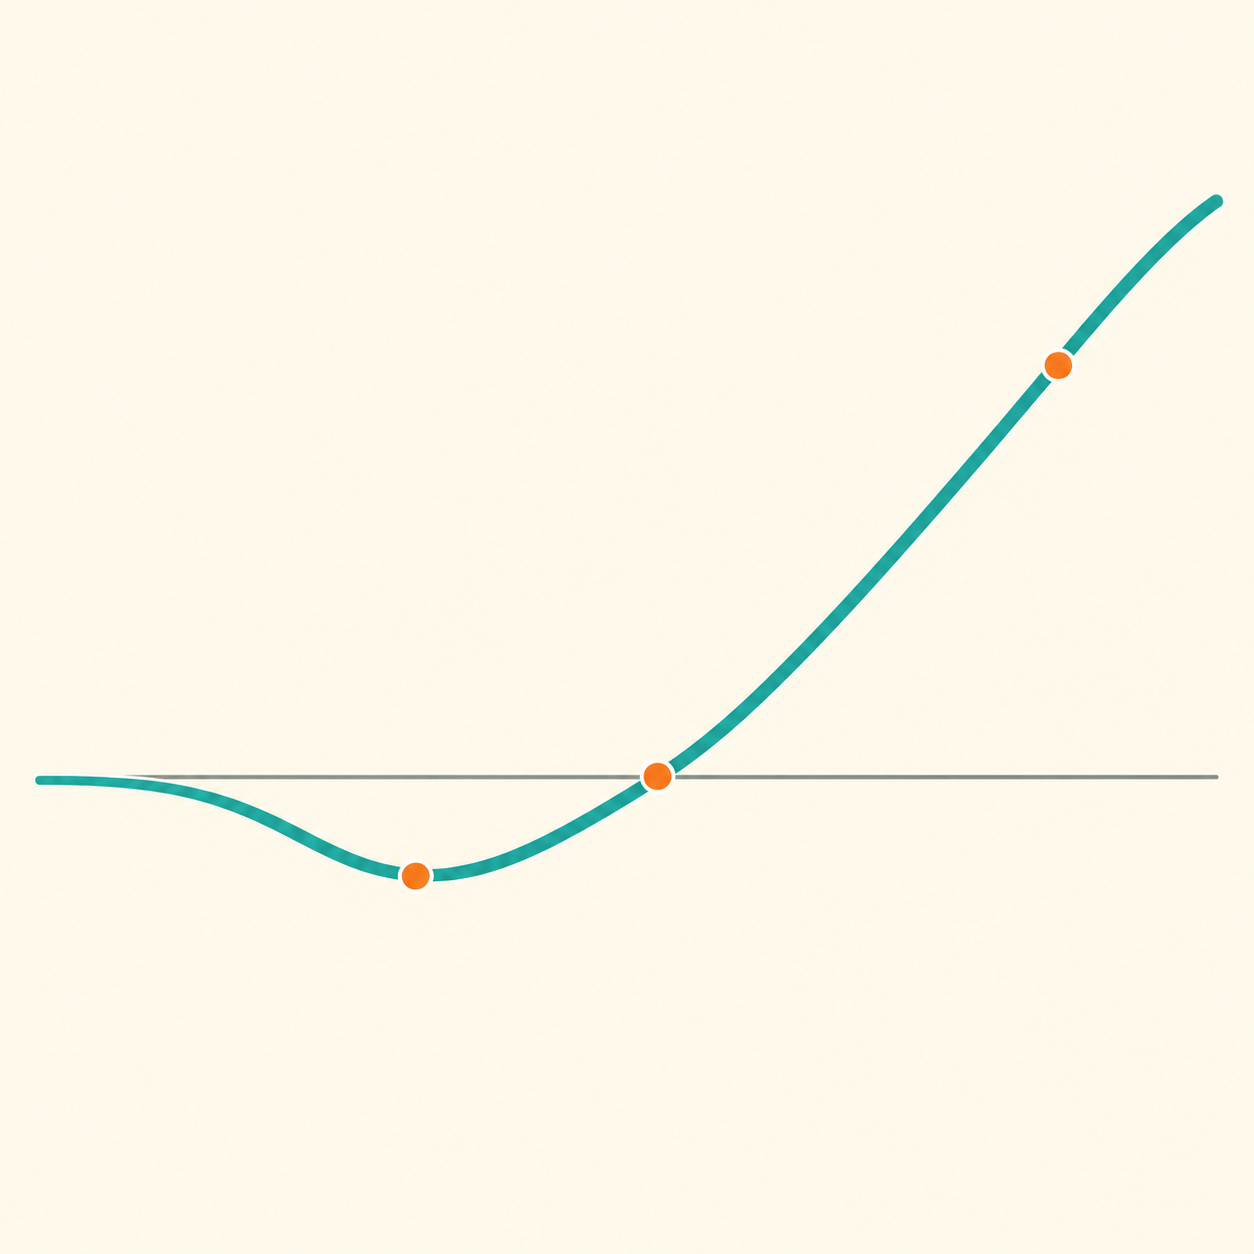
用 AI 检查 GELU 的负半轴:输入更负,输出为何反而靠近零 如果AI把GELU解释成“平滑一点的ReLU”,接着就说负数全部变成零,这个解释已经过头了。用几个负输入和一条独立计算式,既能检查输出,也能看出它不是处处单调上升的函数。 yunqueblog/ AI分享/ 2026-10-02/ 3 阅读
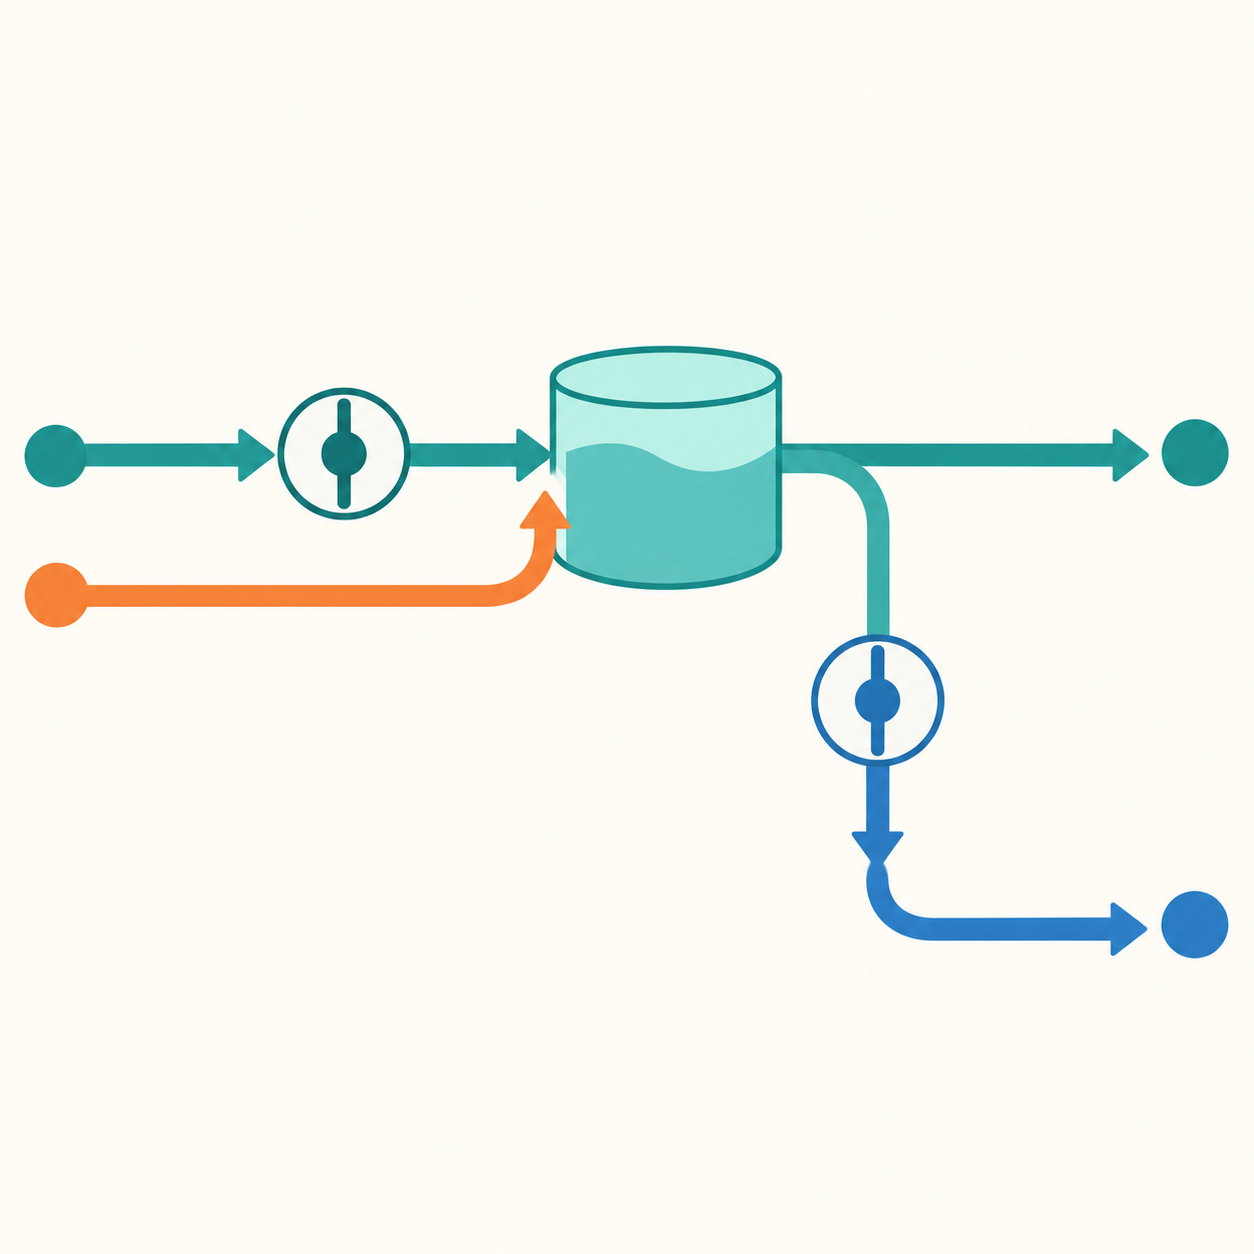
让 AI 拆开 LSTM 的两份状态:输出变小,记忆为何仍然留着 讲到LSTM,AI有时把“隐藏状态”和“细胞状态”都简称为记忆,于是下一步究竟传哪个数就说不清。做一张单维计算卡,让同一份细胞状态产生两种不同的输出,可以直接看见两个状态为什么不能互换。 yunqueblog/ AI分享/ 2026-10-02/ 3 阅读
让 AI 算三元组损失:正样本已经更近,为什么还不是零 学习检索向量时,“同类更近、异类更远”说出了方向,却没有说够多远。让AI解释三元组损失,可以固定一个锚点与正样本,只移动负样本,逐次核对距离差是否达到margin。 yunqueblog/ AI分享/ 2026-10-02/ 3 阅读
用 AI 展开两步扩散加噪:噪声系数直接相加,为何算不出最终方差 扩散模型的正向过程常写成“逐步加入噪声”。如果让AI只画从清晰到模糊的几格图,很难看出信号缩放与噪声方差怎样累计。用一个标量、两步公式,可以把这部分算到每个系数都对得上。 yunqueblog/ AI分享/ 2026-10-02/ 3 阅读
让 AI 折叠 CTC 路径:空白先删掉,两个相同字就可能少一个 语音或手写识别的一帧输出,不一定对应最终文字里的一个字。CTC把较长路径映射成较短标签时,会处理连续重复与特殊空白。让AI制作几张路径卡,可以把“重复出现”和“连续重复”这两个意思分开。 yunqueblog/ AI分享/ 2026-10-02/ 3 阅读
用 AI 给分类树选分叉:一边已经纯了,整次切分仍可能更差 给AI一棵分类树的候选分叉,它可能优先赞成“左边已经全是同一类”的方案。纯净的小分支确实有价值,但如果大多数样本仍挤在混杂的另一边,整次切分未必更好。八张卡片就能把这个差异算清楚。 yunqueblog/ AI分享/ 2026-10-02/ 3 阅读
让 AI 压成一个主成分:保留八成方差,两个不同样本仍会重合 “保留80%的信息”是介绍降维时常见的简写,却容易让人以为每个样本都恢复得八九不离十。让AI做一次PCA投影时,可以要求它同时交出原点、投影坐标和重建点,看究竟丢掉了什么。 yunqueblog/ AI分享/ 2026-10-02/ 3 阅读


 yunqueblog